1. JPA 소개
- 생성 일시
- 2023년 3월 30일 PM 12:20
1. SQL을 직접 다룰 때의 문제점#
1.1. 반복 그리고 반복#
java
// Member 객체
public class Member {
    private String memberId;
    private String name;
    ...
}

// Member용 Data Access Object
public class MemberDAO {
    public Member find(String memberId) {...}
}
위와 같은 DAO에서 회원을 찾기 위한 find 메서드를 구현할 때 아래와 같은 순서로 개발을 진행한다.
- 회원 조회용 SQL 작성sql
SELECT MEMBER_ID, NAME FROM MEMBER WHERE MEMBER_ID = ? - JDBC API를 사용해 SQL을 실행java
ResultSet rs = stmt.executeQuery(sql); - 조회 결과를 Member 객체로 매핑java
String memberId = rs.getString("MEMBER_ID");
String name = rs.getString("NAME");

Member member = new Member(memberId, name);
...
여기서 다른 기능(회원 추가, 삭제 등)을 추가할 경우 위 3가지 경우를 지속적으로 반복하게 된다.
- 결국 문제는 객체를 DB에 CRUD하려면 너무 많은 SQL과 JDBC API를 코드로 작성해야한다.
- 테이블이 100개라면 무수히 많은 SQL을 작성해야 하고 이런 비슷한 일을 100번은 더 반복해야 한다.
1.2. SQL에 의존적인 개발#
앞서 진행한 예제에서 만약 요구사항이 추가되어 회원 테이블에 전화번호를 저장할 수 있도록 변경되었다고 생각해보자
java
// Member 객체
public class Member {
    private String memberId;
    private String name;
    private String tel; // 추가 됨
    ...
}
이렇게 새롭게 요구사항이 추가되어 테이블이 변경될 경우 이에 따른 객체와 SQL문 전부가 수정되어야 한다.
- 수정되어야 할 코드의 양도 많을 뿐더러 수정되지 않은 SQL로 인해서 버그가 발생할 수도 있다.
SQL 의존적인 개발은 SQL 계층을 분리해 숨겨도 문제를 찾기 위해서는 어쩔 수 없이 DAO를 열어 실행되는 SQL을 확인해야한다.
- 진정한 의미의 계층 분할이 어렵고, 엔티티를 신뢰할 수 없다.
1.3. JPA와 문제 해결#
JPA를 사용하면 객체를 데이터베이스에 저장하고 관리할 때, 개발자가 직접 SQL을 작성하는 것이 아닌 JPA가 제공하는 API를 이용하면 된다.
그러면 JPA가 개발자 대신 적절한 SQL을 생성해 DB에 전달한다.
1.3.1. 저장기능#
java
jpa.persist(member);persist()메소드는 객체를 데이터베이스에 저장한다.- JPA가 객체와 매핑정보를 보고 적절한 SQL을 생성해 DB에 전달한다.
1.3.2. 조회기능#
java
String memberId = "helloId";
Member member = jpa.find(Member.class, memberId);find()메소드는 객체 하나를 DB에서 조회한다.
1.3.3. 수정기능#
java
String memberId = "helloId";
Member member = jpa.find(Member.class, memberId);
member.setName("이름변경");- JPA는 별도의 수정 메소드를 제공하지 않는다.
- 대신 객체를 조회해 값을 변경하면 트랜잭션을 커밋할 때 적절한 UPDATE SQL이 전달된다.
1.3.4. 연관된 객체 조회#
java
String memberId = "helloId";
Member member = jpa.find(Member.class, memberId);
Team team = member.getTeam();- JPA는 연관된 객체를 사용하는 시점에 적절한 SELECT SQL을 실행한다.
2. 패러다임 불일치#
- 애플리케이션은 발전하며 그 내부의 복잡성이 점점 커진다.
- 복잡성을 제어하지 못하면 결국 유지보수하기 어려운 애플리케이션이 된다.
- 객체지향 프로그래밍은 추상화, 캡슐화, 정보은닉, 상속, 다형성 등 시스템의 복잡성을 제어할 수 있는 다양한 장치들을 제공한다.
- 비즈니스 요구사항을 정의한 도메인 모델도 객체로 모델링 하면 객체지향 언어가 가진 장점을 활용할 수 있다.
- But. 저장이 필요한 객체라면 메모리가 아닌 어딘가에 영구 보관해야한다.
- 자바는 이런 문제를 고려해 객체를 파일로 저장하는 직렬화 기능을 지원한다.
- But. 보안상의 문제와 더불어 객체를 검색하기가 어렵다.
- 현실적인 대안은 RDB를 사용하는 것이지만 이는 앞서 이야기한 객체지향적인 개념이 존재하지 않는다.
- 객체지향과 RDB간의 패러다임 불일치를 개발자가 중간에서 해결해야 한다.
2.1. 상속#
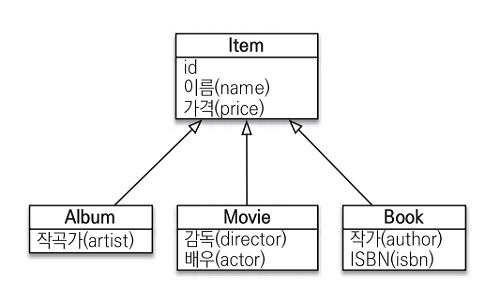
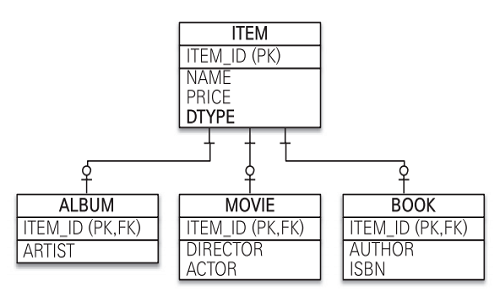
java
abstract class Item {
    Long id;
    String name;
    int price;
}

class Album extends Item {
    String artist;
}

class Movie extends Item {
    String director;
    String actor;
}

class Book extends Item {
    String author;
    String isbn;
}- 객체는 상속이라는 기능을 가지고 있지만 테이블은 상속이라는 기능이 없다.
- 그나마 유사한 모델링은 슈퍼타입과 서브타입 관계라고 말할 수 있다.
ITEM테이블의DTYPE컬럼을 사용해 어떤 자식 테이블과 관계가 있는지 정의 했다.- JDBC API를 사용해 해당 코드를 완성하려면
ITEM용 INSERT SQL을 작성하고 자식 데이터만 커내 ALBUM용 INSERT SQL을 작성해야 하는데 작성해야 하는 코드량이 만만치 않다.- 물론 조회도 쉬운일이 아닌것이
ALBUM을 조회한다면ITEM과ALBUM테이블을 조인해 결과로ALBUM객체를 생성해야 한다.
- 자바 컬렉션에 보관한다면 이런 고민없이 그냥 컬렉션에 보관하면 된다.java
list.add(album); list.add(movie); Album album = list.get(albumId); - JPA는 상속과 관련된 패러다임 불일치 문제를 개발자 대신 해결해준다.
- 개발자는 마치 자바 컬렉션에 객체를 저장하듯 JPA에게 객체를 저장하면 된다.
jpa.persist(album);
2.2. 연관관계#
- 객체는 참조를 사용해 다른 객체와 연관관계를 가지고 참조에 접근해 연관된 객체를 조회한다.
- 반면 테이블은 외래 키를 사용해 테이블과 연관관계를 가지고 조인을 사용해 연관된 테이블을 조회한다.
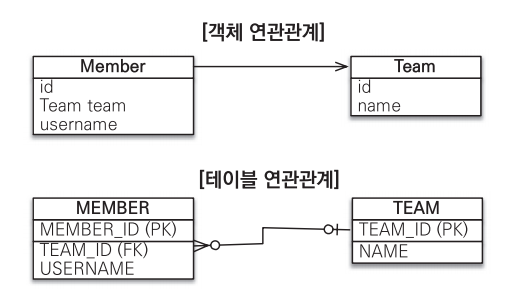
- 참조를 사용하는 객체와 외래 키를 사용하는 RDB 사이의 패러다임 불일치는 객체지향 모델링을 거의 포기하게 말든 정도록 극복하기 어렵다.
- Member 객체는 참조를 통해서 Tream을 조회할 수 있다.java
// 참조를 사용하는 객체 모델 class Member { String id; Team team; String username; Team getTeam() { return team; } } class Team { Long id; String name; } ... member.getTeam(); // 접근 - MEMBER 테이블은 MEMBER.TEAM_ID 외래 키를 통해 TEAM 테이블과 관계를 맺고 조인하여 접근할 수 있다.sql
SELECT M.*, T.* FROM MEMBER M JOIN TEAM T M.TEAM_ID = T.TEAM_ID;
2.2.1. 객체를 테이블에 맞춰 모델링#
java
class Member {
    String id;
    Long teamId;
    String username;
}

class Team {
    Long id;
    String name;
}- 여기서 조금 어려운 문제가 존재한다.
- 객체는 참조가 있는 방향으로만 조회가 가능하지만 외래 키는 반대 방향으로도 조회가 가능하다.
- 테이블과 동일하게 객체 모델을 수정하게 되면 Member 객체와 연관된 Team 객체를 참조를 통해 조회할 수 없다.
- 좋은 객체 모델링은 기대하기 어렵고 결국 객체지향의 특징을 잃어버리게 된다.
2.2.2. 객체지향 모델링#
- 참조를 통한 모델링을 이용할 경우 개발자가 중간에서 변환 역할을 해줘야 한다.
- 이에는 저장/조회시 개발자가 사용하고 신경써야하는 비용이 된다.
2.3. 객체 그래프 탐색#
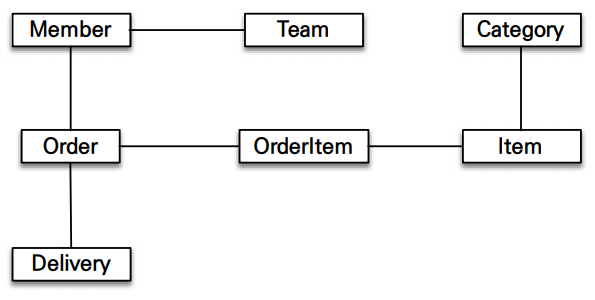
- 객체에서 회원이 소속된 팀을 조회할 때는 다음처럼 참조를 사용해 연관된 침을 찾으면 된다 ⇒ 이를 그래프 탐색이라 한다.
member.getOrder().getOrderItem()...= 그래프 탐색 코드
- SQL을 직접 다루면 처음 실행하는 SQL에 따라 객체 그래프를 어디까지 탐색할 수 있는지 정해진다.
- 이는 객체지향 개발자에겐 큰 제약인데 비즈니스 로직에 따라 객체 그래프가 다른데 언제 끊어질지 모를 그래프를 함부로 탐색할 수는 없기 때문
java
class MemberService {
		...
		public void process() {
				Member member = memberDAO.find(memberId);
				member.getTeam();  // 그래프 탐색이 가능한가?
				member.getOrder().getDelivery();  // ???
		}
}- member 객체를 조회했지만, 객체와 연관된 Team, Order, Delivery 방향으로 객체 그래프를 탐색할 수 있을지 없을지는 이 코드만으로 전혀 예측할 수 없다.
- SQL에 논리적으로 종속되어서 발생하는 문제다.
2.3.1. JPA와 객체 그래프 탐색#
- JPA를 사용하면 객체 그래프를 마으껏 탐색할 수 있다.
- JPA는 지연로딩을 투명하게 처리한다.
java
Member member = jpa.find(Member.class, memberId);

Order order = member.getOrder();
order.getOrderDate(); // Order를 사용하는 시점에 SELECT ORDER SQL- JPA는 연관된 객체를 즉시 함께 조회할지 아니면 실제 사용되는 시점에서 지연해서 조회할지를 간단한 설정으로 정의 가능하다.
2.4. 비교 (Compare)#
- DB는 기본 키의 값으로 각 로우를 구분한다.
- 반면 객체는 동일성과 동성성이라는 두 가지 비교방법이 있다.
==동일성 비교로 인스턴스 주소가 동일한지 비교한다.equals()동등성 비교로 인스턴스 내부의 값을 비교한다.
- JDBC API를 이용해서 값을 매핑 시킬 경우 동일한 값으로 조회하더라도 동일한 객체가 아닌 동등한 객체가 된다.
- 같은 로우를 조회할 때마다 같은 인스턴스를 반환하도록 구현하는 것은 쉽지 않다.
- 트랜잭션이 동시에 실행되는 상황까지 고려하면 문제는 더 어려워진다.
- JPA는 같은 트랜잭션일 때 같은 객체가 조회되는 것을 보장한다.
2.5. 정리#
- 객체 모델과 RDB 모델은 지향하는 패러다임이 서로 다르다.
- 문제는 이 패러다임의 차를 극복하기 위해 개발자가 너무 많은 시간과 코드를 소비한다는 점이다.
- 패러다임의 불일치로 객체 모델링은 힘을 잃고 점점 데이터 중심의 모델로 변해간다.
- JPA는 패러다임의 불일치 문제를 해결해주고 정교한 객체 모델링을 유지하게 도와준다.
3. JPA란 무엇인가?#
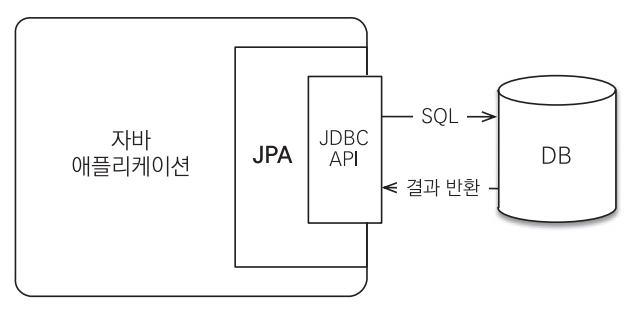
- JPA(Java Persistence API)는 자바 진영의 ORM 기술 표준으로 애플리케이션과 JDBC 사이에서 동작한다.
- 그렇다면 ORM은 무엇인가?
- Object-Relational Mapping은 이름 그대로 객체와 RDB를 매핑한다는 뜻이다.
- ORM 프레임워크를 사용한다면 패러다임 불일치 문제를 개발자 대신 해결해준다.
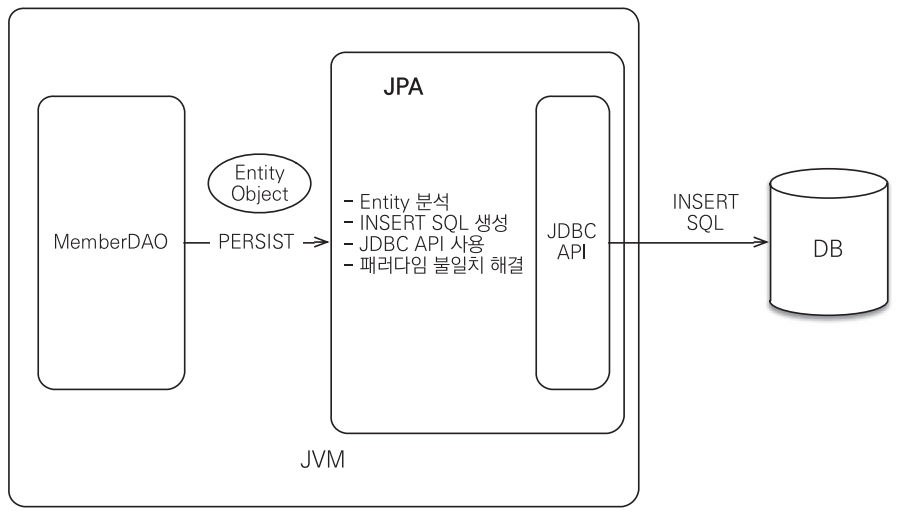
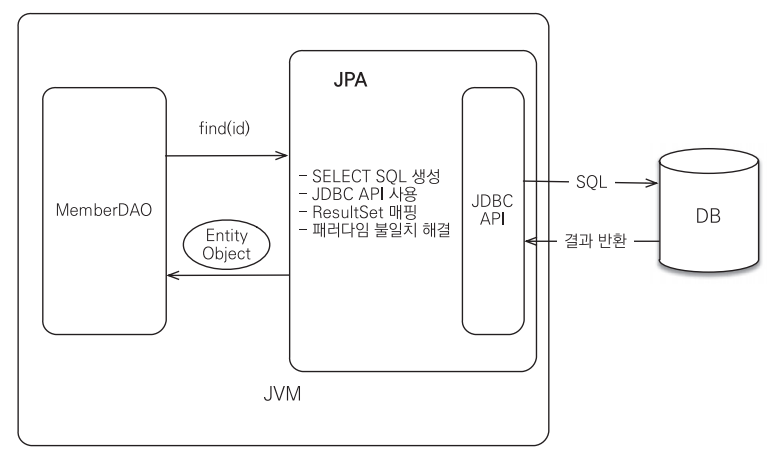
java
jpa.persist(member); // 저장
jpa.find(member); // 조회- ORM 프레임워크는 단순히 SQL을 개발자 대신 생성해 데이터베이스에 전달해주는 것뿐만 아니라 앞서 이야기한 다양한 패러다임의 불일치 문제들도 해결해준다.
- 객체 측면에서는 정교한 객체 모델링 가능
- 객체와 모델링간 매핑은 ORM에게만 알려주면 된다.
- 개발자는 데이터 중심인 RDB를 사용해도 객체지향 애플리케이션 개발에 집중 가능
- 성숙한 객체지향 언어들은 대다수 ORM 프레임워크들이 있고, 단순 CRUD 기능만 제공하거나 패러다임 불일치 문제를 대부분 해결해주는 프레임워크도 존재한다.
- 자바 진형은 하이버네이트가 거의 대부분의 패러다임 불일치 문제를 해결해준다.
3.1. JPA 소개#
- 과거 자바 진영은 자바 빈즈(EJB)라는 표준 기술을 만들었는데 그 안에는 엔티티 빈이라는 ORM 기술도 포함되어 있었다.
- But. 너무 복잡, 성숙도 떨어짐 J2EE 환경에서만 동작했다는 단점이 존재했다.
- 이때 하이버네이트가 등장했고 EJB 3.0에서 하이버네이트를 기반으로 새로운 자바 ORM 표준이 만들어진게 JPA다.
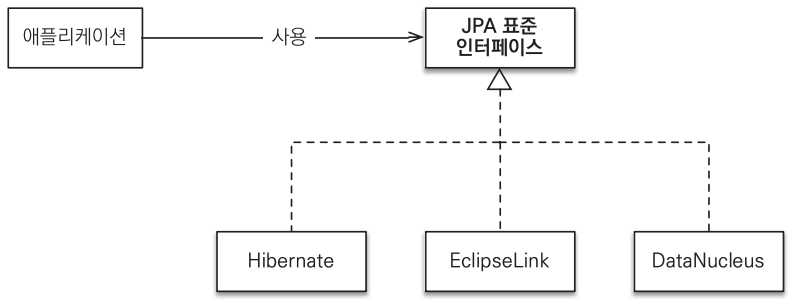
- JPA는 자바 ORM 기술에 대한 API 표준 명세다.
- 쉽게 이야기 인터페이스를 모아놓은 것
- JPA 2.1 를 구현한 ORM 구현체는 아래와 같다.
- 하이버네이트, EclipseLink, DataNucleus
- JPA의 버전별 특징
- JPA 1.0 (JSR 220) = 2006년 출시된 초기버전, 복합 키와 연관관계 기능이 부족
- JPA 2.0 (JSR 317) = 2009년 대부분의 orm 기능을 포함하고 JPA Criteria가 추가
- JPA 2.1 (JSR 338) = 2013년 스토어드 프로시저 접근, 컨버터, 엔티티 그래프 기능 추가
3.2 왜 JPA를 사용해야 하는가?#
3.2.1. 생산성#
- JPA를 사용하면 자바 컬력센에 객체를 저장하듯 JPA에게 저장할 객체를 전달하면 된다.
- SQL을 작성하고 JDBC API를 사용하는 지루하고 반복적인 작업을 JPA가 대신 처리한다.
- 더 나아가 JPA는
CREATE TABLE과 같은 DDL문을 자동으로 생성해주는 기능도 있다.- 이런 기능을 활용해 데이터베이스 설계 중심의 패러다임을 객체 설계 중심으로 역전할 수 있다.
3.2.2. 유지보수#
- SQL을 직접 다루면 엔티티에 필드를 하나만 추가해도 관련된 CRUD SQL과 결과를 매핑하기 위한 코드를 모두 변경해야 했다.
- JPA를 사용하면 이런 과정을 JPA가 대친 처리해주므로 필드를 추가하거나 삭제해도 수정해야할 코드가 줄어든다.
- 즉 유지보수 해야하는 코드 수가 줄어든다.
- JPA가 패러다음 불일치를 해결해주므로 객체지향 언어가 가진 장점을 활용해 유연하고 유지보수 하기 좋은 도메인 모델을 설계할 수 있다.
3.2.3. 패러다임 불일치 해결#
- JPA는 상속, 연관관계, 객체 그래프 탐색, 비교하기와 같은 패러다임의 불일치 문제를 해결해준다.
3.2.4. 성능#
- JPA는 애플리케이션과 데이터베이스 사이에서 다양한 성능 최적화 기회를 제공한다.
- 예를 들어 각은 키의 값을 통해 조회시 같은 트랜잭션 내라면 추가적인 통신없이 기존 객체를 재사용할 수 있다.
- 하이버네이트는 SQL 힌트를 넣을 수 있는 기능도 제공한다.
3.2.5. 데이터 접근 추상화와 벤더 독립성#
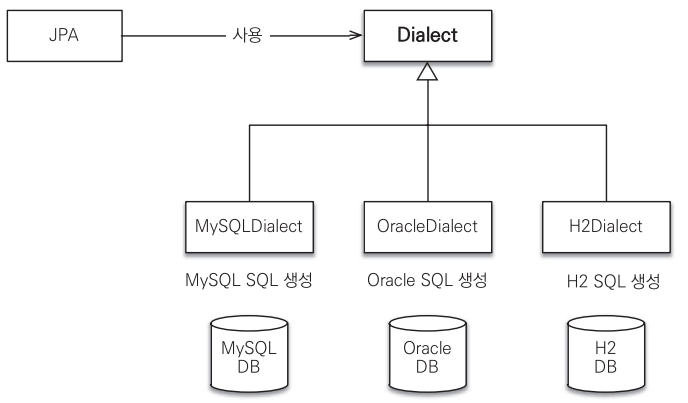
- RDB는 같은 기능도 벤더마다 사용법이 다른경우가 많은데 SQL을 직접 다루는 경우 다른 벤더로의 변경은 매우 어렵다.
- JPA를 사용하면 특정 기술에 종속적이지 않기 때문에 손쉽게 변경할 수 있다.
3.2.6. 표준#
- JPA는 자바 진영의 ORM 표준 기술이기 때문에 다른 구현 기술로 손쉽게 변경 가능하다.