10. 객체지향 쿼리 언어
- 생성 일시
- 2023년 5월 31일 PM 3:35
1. 객체지향 쿼리 소개#
EntityManager.find()메소드를 사용하면 식별자로 엔티티 하나를 조회할 수 있다.- 식별자로 조회
EntityManager.find() - 객체 그래프 탐색
- 현실의 애플리케이션은 복잡하기 때문에
- ORM을 사용하면 데이터베이스 테이블이 아닌 엔티티 객체를 대상으로 개발하므로 검색도 테이블이 엔티티 객체를 대상으로 하는 방법이 필요하다. JPQL은 이런 문제를 해결하기 위해 다음과 같은 특징이 있다.
- 테이블이 아닌 객체를 대상으로 검색하는 객체지향 쿼리다
- SQL을 추상화해서 특정 데이터베이스 SQL에 의존하지 않는다
- 다음은 JPA가 공식 지원하는 기능이다.
- JPQL
- Criteria 쿼리 : JPQL을 편하게 작성하도록 도와주는 API, 빌더 클래스 모음
- 네이티브 SQL : JPA에서 JPQL 대신 직접 SQL을 사용할 수 있다.
2. JPQL#
- JPQL의 특징
- JPQL은 객체지향 쿼리 언어로 테이블을 대상으로 쿼리하는 것이 아닌 엔티티 객체를 대상으로 쿼리한다.
- JPQL은 SQL을 추상화해 특정 데이터베이스 SQL에 의존하지 않는다.
- JPQL은 결국 SQL로 변환된다.
2.1. 기본 문법과 쿼리 API#
- JPQL도 SQL과 비슷하게
SELECT,UPDATE,DELETE문을 사용할 수 있다.
2.1.1. SELECT 문#
sql
SELECT m FROM Member AS m WHERE m.username = 'Hello'- 대소문자 구분
- 엔티티와 속성은 대소문자를 구분한다.
- 엔티티 이름
- JPQL에서 사용하는 객체는 클래스 명이 아니라 엔티티 명이다.
- 엔티티 명은 @Entity(name = "xxx")로 지정할 수 있다.
- 별칭은 필수
- JPQL은 별칭은 필수로 사용해야 한다.
2.1.2. TypeQuery, Query#
- JPQL을 실행하려면 쿼리 객체를 만들어야 한다.
- 쿼리 객체는 TypeQuery와 Query가 있다.java
TypedQuery<Member> query = em.createQuery("SELECT m FROM Member m", Member.class);반환할 타입을 명확하게 TypeQuery 객체를 사용 javaQuery query = em.createQuery("SELECT m.username, m.age FROM Member m");반환할 타입을 명확히 지정할 수 없으면 Query 객체를 사용
2.1.3. 결과 조회 API#
- 다음 메소드들을 호출하면 실제 쿼리를 실행해서 데이터베이스를 조회한다.
query.getResultList(): 결과가 하나 이상일 때, 리스트 반환- 결과가 없으면 빈 리스트 반환
query.getSingleResult(): 결과가 정확히 하나, 단일 객체 반환- 결과가 없으면 :
javax.persistence.NoResultException - 둘 이상이면 :
javax.persistence.NonUniqueResultException
2.2. 파라미터 바인딩#
- JDBC는 위치 기준 기준 파라미터 바인딩만 지원하지만 JPQL은 이름 기준 파라미터 바인딩도 지원한다.
- 이름 기준 파라미터
- 이름 기준 파라미터는 파라미터를 이름으로 구분하는 방법이다.
- 이름 기준 파라미터는 앞에
:를 사용한다.
- 위치 기준 파라미터
- 위치 기준 파라미터를 사용하려면
?다음에 위치 값을 주면된다.
- 위치 기준 파라미터 방식보다는 이름 기준 파라미터 바인딩 방식을 사용하는 것이 더 명확하다.
2.3. 프로젝션#
- SELECT 절에 조죄할 대상을 지정하는 것을 프로젝션이라 하고
SELECT {프로젝션 대상} FROM으로 대상을 선택한다. - 프로젝션 대상은 엔티티, 임베디드 타입, 스칼라 타입이 있다.
- 엔티티 프로젝션
SELECT m FROM Member mSELECT m.team FROM Member m
- 임베디드 타입 프로젝션
SELECT m.address FROM Member m
- 스칼라 타입 프로젝션
SELECT m.username, m.age FROM Member m
- 여러 값 조회
- 꼭 필요한 데이터들만 선택해 조회해야할 경우 Query를 사용해야 한다.
em.createQuery("SELELCT m.username, m.age FROM Member m");
- NEW 명령어
- 의미 있는 객체로 리턴받고 싶을 경우 이용한다.
SELECT new UserDTO(m.username, m.age) FROM Member m- 사용시 주의사항
- 패키지 명을 포함한 전체 클래스 명 입력
- 순서와 타입이 일치하는 생성자 필요
2.4. 페이징 API#
- JPA는 페이징을 두 API로 추상화 했다.
- setFirstResult(int startPosition) : 조회 시작 위치(0부터 시작)
- setMaxResults(int maxResult) : 조회할 데이터 수
java
TypedQuery<Member> query = em.createQuery("select m from Member m order by m.age desc", Member.class);
query.setFirstResult(0)
query.setMaxResults(10)
query.getResultList();- JPA는 방언 덕분에 각 데이터베이스별로 손쉽게 대응이 가능하다.
- 페이징 SQL을 더 최적화 하고 싶다면 JPA가 제공하는 페이징 API가 아닌 네이티브 SQL을 직접 사용해야 한다.
2.5. 집합과 정렬#
- 집합은 집합함수와 함께 통계 정보를 구할 때 사용한다.
2.5.1. 집합 함수#
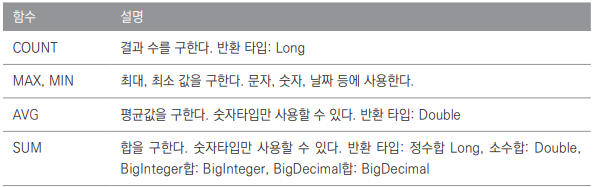
2.5.2. 집합 함수 사용 시 참고사항#
NULL값은 무시하므로 통계에 잡히지 않는다.DISTINCT가 정의되어 있어도 무시된다.
- 만약 값이 없는데
SUM,AVG,MAX,MIN함수를 사용하면NULL값이 된다.- 단 COUNT는 0이 된다.
DISTINCT를 집합 함수 안에 사용해서 중복된 값을 제거하고 나서 집합을 구할 수 있다.- ex)
select COUNT(DISTINCT m.age) from Member m
DISTINCT를COUNT에서 사용할 때 임베디드 타입은 지원하지 않는다.
2.5.3. GROUP BY, HAVING#
GROUP BY는 통계 데이터를 구할 때 특정 그룹끼리 묶어준다.
sql
select t.name, COUNT(m.age), SUM(m.age), AVG(m.age), MAX(m.age), MIN(m.age)
from Member m LEFT JOIN m.team t
GROUP BY t.nameHAVING은GROUP BY와 함께 사용하는데GROUP BY로 그룹화한 통계 데이터를 기준으로 필터링한다.
sql
select t.name, COUNT(m.age), SUM(m.age), AVG(m.age), MAX(m.age), MIN(m.age)
from Member m LEFT JOIN m.team t
GROUP BY t.name
HAVING AVG(m.age) >= 10- 이런 쿼리들을 보통 리포팅 쿼리나 통계 쿼리라 한다.
- 이러한 통계 쿼리를 잘 활용하면 애플리케이션으로 수십 라인을 작성할 코드도 단 몇 줄이면 처리할 수 있다.
- But. 통계 쿼리는 보통 전체 데이터를 기준으로 처리하므로 실시간으로 사용하기엔 부담이 많다.
2.5.4. 정렬(ORDER BY)#
- ORDER BY는 결과를 정렬할 때 사용한다.
sql
select m from Member m order by m.age DESC, m.username ASC- ASC : 오름차순(기본값)
- DESC : 내림차순
2.6. JPQL 조인#
- JPQL도 조인을 지원하는데 SQL 조인과 기능은 같고 문법만 약간 다르다.
2.6.1. 내부 조인#
- 내부 조인은
INNER JOIN을 사용한다.
java
String teamName = "팀A";
String query = "SELECT m FROM Member m INNER JOIN m.team t WHERE t.name = :teamName";

List<Member> members = em.createQuery(query, Member.class)
                         .setParameter("teamName", teamName)
.getResultList();- JPQL 내부 조인을 보면 SQL의 조인과 약간 다른 것을 확인할 수 있다.
- JPQL 조인의 가장 큰 특징은 연관 필드를 사용한다는 것이다.
FROM Member m: 회원을 선택하고m이라는 별칭을 주었다.Member m JOIN m.team t: 회원이 가지고 있는 연관 필드로 팀과 조인하고 조인한 팀에는t라는 별칭을 주었다.- 혹시라도 JPQL 조인을 SQL 조인처럼 사용하면 문법 오류가 발생한다.
2.6.2. 외부 조인#
sql
SELECT m FROM Member m LEFT [OUTER] JOIN m.team t- 외부 조인은 기능상 SQL의 외부 조인과 같다.
OUTER는 생략 가능해서 보통LEFT JOIN으로 사용한다.
2.6.3. 컬렉션 조인#
- 일대다 관계나 다대다 관계처럼 컬렉션을 사용하는 곳에 조인하는 것을 컬렉션 조인이라 한다.
- [회원 -> 팀]으로의 조인은 다대일 조인이면서 단일 값 연관 필드(m.team)를 사용한다.
- [팀 -> 회원]은 반대로 일대다 조인이면서 컬렉션 값 연관 필드(m.members)를 사용한다.
sql
SELECT t, m FROM Team t LEFT JOIN t.members m- 팀과 팀이 보유한 회원목록을 컬렉션 값 연관 필드로 외부 조인했다.
2.6.4. 세타 조인#
- WHERE 절을 사용해서 세타 조인을 할 수 있다. 참고로 세타 조인은 내부 조인만 지원한다.
- 세타 조인을 사용하면 아래 예제처럼 전혀 관계없는 엔티티도 조인할 수 있다.
sql
// JPQL
select count(m) from Member m, Team t where m.username = t.name

// SQL
SELECT COUNT(M.ID)
FROM
    MEMBER M CROSS JOIN TEAM T
WHERE
    M.USERNAME=T.NAME
2.6.5. JOIN ON 절(JPA 2.1)#
- JPA 2.1부터 조인할 때 ON 절을 지원한다.
- ON 절을 사용하면 조인 대상을 필터링하고 조인할 수 있다.
- 참고로 내부 조인의 ON 절은 WHERE 절을 사용할 때와 결과가 같으므로 보통 ON 절은 외부 조인에서만 사용한다.
sql
// JPQL
select m,t from Member m left join m.team on t.name = 'A'

// SQL
SELECT m.*, t.* FROM Member m
LEFT JOIN Team t ON m.TEAM_ID=t.id and t.name='A'
2.7. 페치 조인#
- 페치(fetch) 조인은 SQL에서 이야기하는 조인의 종류는 아니고 JPQL에서 성능 최적화를 위해 제공하는 기능이다.
- 이것은 연관된 엔티티나 컬렉션을 한 번에 같이 조회하는 기능인데
join fetch명령어로 사용할 수 있다.페치 조인 ::= [ LEFT [OUTER] | INNER ] JOIN FETCH 조인경로
2.7.1. 엔티티 페치 조인#
sql
select m from Member m join fetch m.team

// 실제 실행
SELECT
    M.*, T.*
FROM MEMBER M
INNER JOIN TEAM T ON M.TEAM_ID=T.ID- 예제를 보면 join 다음에 fetch라 적었다.
- 이렇게 하면 연관된 엔티티나 컬렉션을 함께 조회하는데 여기서는 회원(m)과 팀(m.team)을 함께 조회한다.
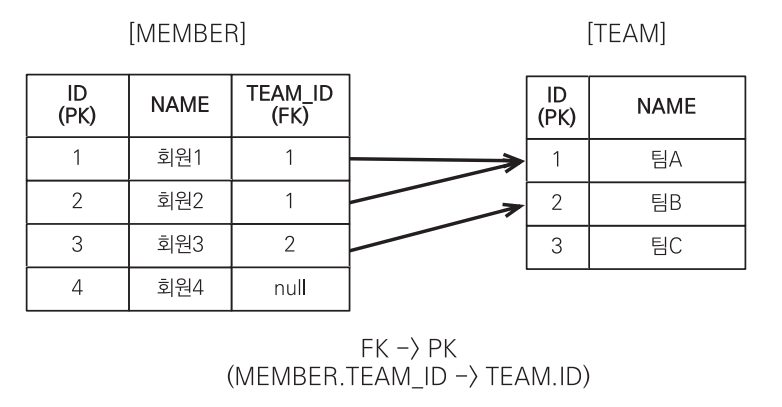
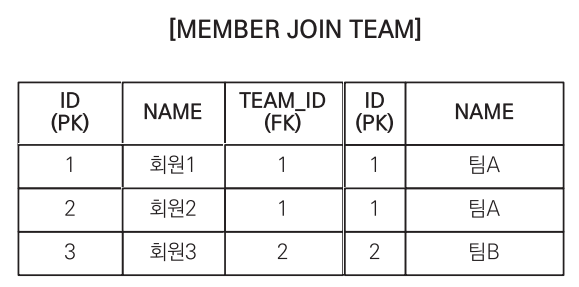
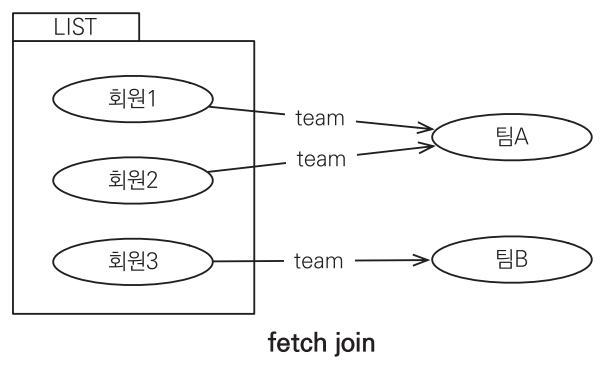
- 엔티티 페치 조인 JPQL에서 select m으로 회원 엔티티만 선택했는데 실행된 SQL을 보면 SELECT M.*, T.*로 회원과 연관된 팀도 함께 조회된 것을 확인할 수 있다.
- 회원을 조회할 때 페치 조인을 사용해서 팀도 함께 조회했으므로 연관된 팀 엔티티는 프록시가 아닌 실제 엔티티다.
2.7.2. 컬렉션 페치 조인#
sql
select t from Team t join fetch t.members where t.name = '팀A'

// 실제 실행
SELECT
    T.*, M.*
FROM TEAM T
INNER JOIN MEMBER M ON T.ID = M.TEAM_ID
WHERE T.NAME = '팀A'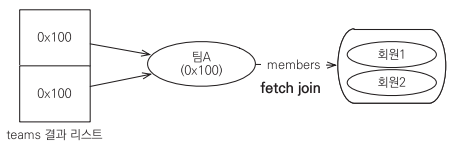
- 컬렉션을 페치 조인한 JPQL에서 select t로 팀만 선택했는데 실행된 SQL을 보면 T.*, M.*로 팀과 연관된 회원도 함께 조회한 것을 확인할 수 있다.
- 일대다 조인은 결과가 증가할 수 있지만 일대일, 다대일 조인은 결과가 증가하지 않는다.
2.7.3. 페치 조인과 DISTINT#
- SQL의 DISTINCT는 중복된 결과를 제거하는 명령이다.
- JPQL의 DISTINCT 명령어는 SQL에 DISTINCT를 추가하는 것은 물론이고 애플리케이션에서 한 번 더 중복을 제거한다.
sql
select distinct t
from Team t join fetch t.members
where t.name = '팀A'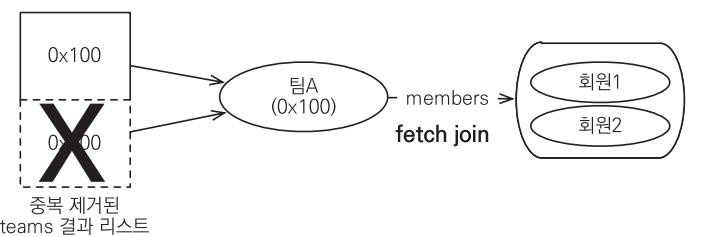
2.7.4. 페치 조인과 일반 조인의 차이#
sql
select t
from Team t join t.members m
where t.name = '팀A'

// 실제 실행
SELECT
    T.*
FROM TEAM T
INNER JOIN MEMBER M ON T.ID = M.TEAM_ID
WHERE T.NAME = '팀A'- 위의 예제의 JPQL에서 팀과 회원 컬렉션을 조인했으므로 회원 컬렉션도 함께 조회할 것으로 기대해선 안 된다.
- 실행된 SQL의 SELECT 절을 보면 팀만 조회하고 조인했던 회원은 전혀 조회하지 않는다.
- JPQL은 결과를 반환할 때 연관관계까지 고려하지 않는다.
- 단지 SELECT 절에 지정한 엔티티만 조회할 뿐이다.
- 따라서 팀 엔티티만 조회하고 연관된 회원 컬렉션은 조회하지 않는다.
- 만약 회원 컬렉션을 지연 로딩으로 설정하면 아래 그림처럼 프록시나 아직 초기화되지 않은 컬렉션 래퍼를 반환한다.
- 즉시 로딩으로 설저하면 회원 컬렉션을 즉시 로딩하기 위해 쿼리를 한 번 더 실행한다.
2.7.5. 페치 조인의 특징과 한계#
- 페치 조인을 사용하면 SQL 한 번으로 연관된 엔티티들을 함께 조회할 수 있어서 SQL 호출 횟수를 줄여 성능을 최적화할 수 있다.
- 다음처럼 엔티티에 직접 적용하는 로딩 전략은 애플리케이션 전체에 영향을 미치므로 글로벌 로딩 전략이라 부른다.
- 페치 조인은 글로벌 로딩 전략보다 우선한다.
- 최적화를 위해 글로벌 로딩 전략을 즉시 로딩으로 설정하면 애플리케이션 전에체서 항상 즉시 로딩이 일어난다.
- 물론 일부는 빠를 수는 있지만 전체로 보면 사용하지 않는 엔티티를 자주 로딩하므로 오히려 성능에 악영향을 미칠 수 있다.
- 따라서 글로벌 로딩 전략은 될 수 있으면 지연 로딩을 사용하고 최적화가 필요하면 페치 조인을 적용하는 것이 효과적이다.
- 페치 조인을 사용하면 연관된 엔티티를 쿼리 시점에 조회하므로 지연 로딩이 발생하지 않는다.
- 따라서 준영속 상태에서도 객체 그래프를 탐색할 수 있다.
- 페치 조인은 다음과 같은 한계가 있다.
- 페치 조인 대상에는 별칭을 줄 수 없다.
- SELECT, WHERE 절, 서브 쿼리에 페치 조인 대상을 사용할 수 없다.
- JPA 표준에서는 지원하지 않지만 하이버네이트를 포함한 몇몇 구현체들은 페치 조인에 별칭을 지원한다.
- 하지만 별칭을 잘못 사용하면 연관된 데이터 수가 달라져서 데이터 무결성이 깨질 수 있으므로 조심해서 사용해야 한다.
- 둘 이상의 컬렉션을 페치할 수 없다.
- 구현체에 따라 되기도 하는데 컬렉션 * 컬렉션의 카테시안 곱이 만들어지므로 주의해야 한다.
- 컬렉션을 페치 조인하면 페이징 API(setFirstResult, setMaxResults)를 사용할 수 없다.
- 컬렉션(일대다)이 아닌 단일 값 연관 필드(일대일, 다대일)들은 페치 조인을 사용해도 페이징 API를 사용할 수 있다.
- 하이버네이트에서 컬렉션을 페치 조인하고 페이징 API를 사용하면 경고 로그를 남기면서 메모리에서 페이징 처리를 한다.
- 데이터가 적으면 상관없겠지만 데이터가 많으면 성능 이슈와 메모리 초과 예외가 발생할 수 있어서 위험하다.
- 엔티티가 가진 모양이 아닌 전혀 다른 결과를 내야 한다면 억지로 페치 조인을 사용하기보다는 여러 테이블에서 필요한 필드들만 조회해서 DTO로 반환하는 것이 더 효과적일 수 있다.
2.8. 경로 표현식#
- 경로 표현식이라는 것은 쉽게 이야기해서 .(점)을 찍어 객체 그래프를 탐색하는 것이다.
sql
select m.username
from Member m
    join m.team t
    join m.orders o
where t.name = '팀A'- 여기서 m.username, m.team, m.orders, t.name이 모두 경로 표현식을 사용한 예다.
2.8.1. 경로 표현식의 용어 정리#
- 상태 필드(state field)
- 단순히 값을 저장하기 위한 필드(필드 or 프로퍼티)
- 연관 필드(association field)
- 연관관계를 위한 필드, 임베디드 타입 포함(필드 or 프로퍼티)
- 단일 값 연관 필드 : @ManyToOne, @OneToOne, 대상이 엔티티
- 컬렉션 값 연관 필드 : @OneToMany, @ManyToMany, 대상이 컬렉션
2.8.2. 경로 표현식과 특징#
- 상태 필드 경로
- 경로 탐색의 끝이다. 더는 탐색할 수 없다.
sqlselect m.username, m.age from Member m - 단일 값 연관 경로
- 묵시적으로 내부 조인이 일어난다.
- 단일 값 연관 경로는 계속 탐색할 수 있다.
sqlselect o.member from Order o - 컬렉션 값 연관 경로
- 묵시적으로 내부 조인이 일어난다. 더는 탐색할 수 없다.
- 단 FROM 절에서 조인을 통해 별칭을 얻으면 별칭으로 탐색할 수 있다.
sqlselect t.members from Team t // 성공 select t.members.username from Team t // 실패
2.8.3. 경로 탐색을 사용한 묵시적 조인 시 주의사항#
- 경로 탐색을 사용하면 묵시적 조인이 발생해서 SQL에서 내부 조인이 일어날 수 있다.
- 이때의 주의사항
- 항상 내부 조인이다.
- 컬렉션은 경로 탐색의 끝이다.
- 컬렉션에서 경로 탐색을 하려면 명시적으로 조인해서 별칭을 얻어야 한다.
- 경로 탐색은 주로 SELECT, WHERE(다른 곳에서도 사용됨)에서 사용하지만 묵시적 조인으로 인해 SQL의 FROM 절에 영향을 준다.
- 조인이 성능상 차지하는 부분은 아주 크다.
- 묵시적 조인은 조인이 일어나는 상황을 한눈에 파악하기 어렵다는 단점이 있다.
- 따라서 단순하고 성능에 이슈가 없으면 크게 문제가 안 되지만 성능이 중요하면 분석하기 쉽도록 묵시적 조인보다는 명시적 조인을 사용하자.
2.9. 서브 쿼리#
- JPQL도 SQL처럼 서브 쿼리를 지원한다.
- 여기에는 몇 가지 제약이 있는데, 서브 쿼리를 WHERE, HAVING 절에서만 사용할 수 있고 SELECT, FROM 절에서는 사용할 수 없다.
2.9.1. 서브 쿼리 함수#
- [NOT] EXISTS(subquery)
- 문법 : [NOT] EXISTS (subquery)
- 설명 : 서브 쿼리에 결과가 존재하면 참이다. NOT은 반대
sqlselect m from Member m where exists (select t from m.team t where t.name = '팀A') - {ALL | ANY | SOME}(subquery)
- 문법 : {ALL | ANY | SOME} (subquery)
- 설명 : 비교 연산자와 같이 사용한다. {= | > | >= | < | <= | <>}
- ALL : 조건을 모두 만족하면 참이다.
- ANY 혹은 SOME : 둘은 같은 의미다. 조건을 하나라도 만족하면 참이다.
sqlselect o from Order o where o.orderAmount > ALL (select p.stockAmount from Product p) select m from Member m where m.team = ANY (select t from Team t) - [NOT] IN (subquery)
- 문법 : [NOT] IN (subquery)
- 설명 : 서브쿼리의 결과 중 하나라도 같은 것이 있으면 참이다. 참고로 IN은 서브쿼리가 아닌 곳에서도 사용한다.
sqlselect t from Team t where t IN (select t2 FROM Team t2 JOIN t2.members m2 where m2.age >= 20)
2.10. 조건식#
2.10.1. 타입 표현#
| 종류 | 설명 | 예제 |
| 문자 | 작은 따옴표 사이에 표현작은 따옴표를 표현하고 싶으면 작은 따옴표 연속 두 개('') 사용 | 'HELLO''She''s' |
| 숫자 | L(Long 타입 지정)D(Double 타입 지정)F(Float 타입 지정) | 10L10D10F |
| 날짜 | DATE{d'yyyy-mm-dd'}TIME{t'hh-mm-ss'}DATETIME{ts'yyyy-mm-dd hh:mm:ss:f'} | {d'2012-03-24'}{t'10-11-11'}{ts'2012-03-24 10-11-11.123'}m.createDate={d'2012-03-24'} |
| Boolean | TRUE,FALSE | |
| Enum | 패키지명을 포함한 전체 이름을 사용해야 한다. | jpabook.MemberType.Admin |
| 엔티티 타입 | 엔티티 타입을 표현한다. 주로 상속과 관련해서 사용한다. | TYPE(m) = Member |
2.10.2. 연산자 우선 순위#
- 경로 탐색 연산 (.)
- 수학 연산 : +, -(단항 연산자), *, /, +, -
- 비교 연산 : =, >, >=, <, <=, <>(다름), [NOT] BETWEEN, [NOT] LIKE, [NOT] INT, IS [NOT] NULL, IS [NOT] EMPTY, [NOT] MEMBER [OF], [NOT] EXISTS
- 논리 연산 : NOT, AND, OR
2.10.3. 논리 연산과 비교식#
- 논리 연산
- AND : 둘 다 만족하면 참
- OR : 둘 중 하나만 만족해도 참
- NOT : 조건식의 결과 반대
- 비교식
- = | > | >= | < | <= | <>
2.10.4. Between, IN, Like, NULL 비교#
- Between 식
- 문법 : X [NOT] BETWEEN A AND B
- IN 식
- 문법 : X [NOT] IN(예제)
- Like 식
- 문법 : 문자표현식 [NOT] LIKE 패턴값 [ESCAPE 이스케이프문자]
- NULL 비교식
- 문법 : {단일값 경로 | 입력 파라미터} IS [NOT] NULL
2.10.5. 컬렉션 식#
- 컬렉션 식은 컬렉션에만 사용하는 특별한 기능이다. 참고로 컬렉션은 컬렉션 식 이외에 다른 식은 사용할 수 없다.
- 빈 컬렉션 비교 식
- 문법 : {컬렉션 값 연관 경로} IS [NOT] EMPTY
sqlselect m from Member m where m.orders is not empty - 컬렉션의 멤버 식
- 문법 : {엔티티나 값} [NOT] MEMBER [OF] {컬렉션 값 연관 경로}
sqlselect t from Team t where :memberParam member of t.members
2.11. 다형성 쿼리#
- JPQL로 부모 엔티티를 조회하면 그 자식 엔티티도 함께 조회한다.
java
@Entity
@Inheritance(strategy = InheritanceType.SINGLE_TABLE)
@DiscriminatorColumn(name = "DTYPE")
public abstract class Item {...}

@Entity
@DiscriminatorValue("B")
public class Book extends Item {
    ...
    private String author;
}

// Album, Movie 생략- 단일 테이블 전략(InheritanceType.SINGLE_TABLE)을 사용할 때 실행되는 SQL은 다음과 같다.sql
SELECT * FROM ITEM - 조인 전략(InheritanceType.JOINED)을 사용할 때 실행되는 SQL은 다음과 같다.sql
SELECT
    i.ITEM_ID, i.DTYPE, i.name, i.price, i.stockQuantity,
    b.author, b.isbn,
    a.artist, a.etc,
    m.actor, m.director
FROM
    Item i
left outer join
    Book b on i.ITEM_ID=b.ITEM_ID
left outer join
    Album a on i.ITEM_ID=a.ITEM_ID
left outer join
    Movie m on i.ITEM_ID=m.ITEM_ID
2.11.1. TYPE#
- TYPE은 엔티티의 상속 구조에서 조회 대상을 특정 자식 타입으로 한정할 때 주로 사용한다.
sql
// JPQL
select i from Item i
where type(i) IN (Book, Movie)

// SQL
SELECT i FROM Item i
WHERE i.DTYPE in ('B', 'M')
2.11.2. TREAT(JPA 2.1)#
- TREAT는 JPA 2.1에 추가된 기능인데 자바의 타입 캐스팅과 비슷하다.
- 상속 구조에서 부모 타입을 특정 자식 타입으로 다룰 때 사용한다.
- JPA 표준은 FROM, WHERE 절에서 사용할 수 있지만 하이버네이트는 SELECT 절에서도 TREAT를 사용할 수 있다.
sql
// JPQL
select i from Item i where treat(i as Book).author = 'kim'

// SQL
select i.* from Item i
where
    i.DTYPE='B'
    and i.author='kim'
2.14. 엔티티 직접 사용#
2.14.1. 기본 키 값#
- 객체 인스턴스는 참조 값으로 식별하고 테이블 로우는 기본 키 값으로 식별한다.
- 따라서 JPQL에서 엔티티 객체를 직접 사용하면 SQL에서는 해당 엔티티의 기본 키 값을 사용한다.
sql
select count(m.id) from Member m   // 엔티티의 아이디를 사용
select count(m) from Member m // 엔티티를 직접 사용- count(m)을 보면 엔티티의 별칭을 직접 넘겨주었지만 엔티티를 직접 사용하면 JPQL이 SQL로 변환될 때 해당 엔티티의 기본 키를 사용한다.
2.14.2. 외래 키 값#
java
Team team = em.find(Team.class, 1L);

String qlString = "select m from Member m where m.team = :team";
List resultList = em.createQuery(qlString)
                    .setParameter("team", team)
.getResultList();java
String qlString = "select m from Member m where m.team.id = :teamId";
List resultList = em.createQuery(qlString)
                    .setParameter("teamId", 1L)
.getResultList();sql
select m.*
from Member m
where m.team_id=? (팀 파라미터의 ID 값)m.team.id를 보면 Member와 Team 간에 묵시적 조인이 일어날 것 같지만 MEMBER 테이블이team_id외래 키를 가지고 있으므로 묵시적 조인은 일어나지 않는다.- 물론
m.team.name을 호출하면 묵시적 조인이 일어난다. - 따라서 위 두 코드는 모두 같은 SQL이 생성된다.
2.15. Named 쿼리 : 정적 쿼리#
- JPQL 쿼리는 크게 동적 쿼리와 정적 쿼리로 나눌 수 있다.
- 동적 쿼리
em.createQuery("select ..")처럼 JPQL을 문자로 완성해도 직접 넘기는 것을 동적 쿼리라 한다.- 런타임에 특정 조건에 따라 JPQL을 동적으로 구성할 수 있다.
- 정적 쿼리
- 미리 정의한 쿼리에 이름을 부여해서 필요할 때 사용할 수 있는데 이것을 Named 쿼리라 한다.
- Named 쿼리는 한 번 정의하면 변경할 수 없는 정적인 쿼리다.
- Named 쿼리는 애플리케이션 로딩 시점에 JPQL 문법을 체크하고 미리 파싱해 둔다.
- 오류를 빨리 확인할 수 있고, 사용하는 시점에는 파싱된 결과를 재사용하므로 성능상 이점도 있다.
- 정적 SQL이 생성되므로 데이터베이스의 조회 성능 최적화에도 도움이 된다.
- Named 쿼리는
@NamedQuery어노테이션을 사용해서 자바 코드에 작성하거나 또는 XML 문서에 작성할 수 있다.
2.15.1. Named 쿼리를 어노테이션에 정의#
java
@Entity
@NamedQuery(
    name = "Member.findByUsername",
    query = "select m from Member m where m.username = :username")
public class Member {
    ...
}
java
List<Member> resultLIst = em.createNamedQuery("Member.findUsername", Member.class)
                            .setParameter("username", "회원1")
.getResultList();@NamedQuery.name에 쿼리 이름을 부여하고@NamedQuery.query에 사용할 쿼리를 입력한다.
java
@Entity
@NamedQueries({
    @NamedQuery(
        name = "Member.findByUsername",
        query = "select m from Member m where m.username = :username"),
    @NamedQuery(
        name = "Member.count",
        query = "select count(m) from Member m")
})
public class Member {...}java
@Target({TYPE})
public @interface NamedQuery {

    String name();     // Named 쿼리 이름 (필수)
    String query();    // JPQL 정의 (필수)
    LockModeType lockMode() default NONE;   // 쿼리 실행 시 락모드를
                                            // 설정할 수 있다.
QueryHint[] hints() default {}; // JPA 구현체에 쿼리 힌트를 줄 수 있다.- lockMode : 쿼리 실행 시 락을 건다.
- hints : 여기서 힌트는 SQL 힌트가 아니라 JPA 구현체에게 제공하는 힌트다. 예를 들어 2차 캐시를 다룰 때 사용한다.
2.15.2. Named 쿼리를 XML에 정의#
- Named 쿼리를 작성할 때는 XML을 사용하는 것이 더 편리하다.
xml
<?xml version="1.0" encoding="UTF-8"?>
<entity-mappings xmlns="http://xmlns.jcp.org/xml/ns/persistence/orm"
                 version="2.1">

  <named-query name="Member.findByUsername">
    <query><CDATA[
        select m
        from Member m
        where m.username = :username
    ]></query>
  </named-query>

  <named-query name="Member.count">
    <query>select count(m) from Member m</query>
  </named-query>

</entity-mappings>- XML에서 &, <, >는 XML 예약문자다.
- 대신에 &, < >를 사용해야 한다.
<![CDATA[]]>를 사용하면 그 사이에 문장을 그대로 출력하므로 예약문자도 사용할 수 있다.
- 그리고 정의한 ormMember.xml을 인식하도록 META-INF/persistence.xml에 다음 코드를 추가해야 한다.xml
<persistence-unit name="jpabook"> <mapping-file>META-INF/ormMember.xml</mapping-file> ... - META-INF/orm.xml은 JPA가 기본 매핑파일로 인식해서 별도의 설정을 하지 않아도 된다.
2.15.3. 환경에 따른 설정#
- 만약 XML과 어노테이션에 같은 설정이 있으면 XML이 우선권을 가진다.
- 애플리케이션이 운영 환경에 따라 다른 쿼리를 실행해야 한다면 각 환경에 맞춘 XML을 준비해두고 XML만 변경해서 배포하면 된다.