메모리관리
- Created
- 2022년 9월 3일 PM 8:08
메모리관리에 대해서#
우리가 사용하는 메모리는 크게 논리적 주소와 물리적 주소로 나뉜다.
- 논리적 주소
- 물리적 주소
- 주소 바인딩
- 상징적 주소 → 논리적 주소 → 물리적 주소
- 프로그래밍을 할때 우리는 상징적(Symbolic) 주소를 이용하여 프로그래밍을 진행한다.
- 우리는 변수를 이용하지 직접 메모리 주소를 작성하지 않음
주소 바인딩#
주소를 실제 메모리에 연결하는 방법은 크게 3가지로 나뉜다.
- Compile time binding
- 컴파일시 물리적 주소가 정해지는 방식
- 시작 위치 변경시 재컴파일
- 컴파일러는 절대 코드(absolute code) 생성
- Load time Binding
- Loader의 책임하에 물리적 메모리 주소 부여
- 컴파일러가 재배치가능코드를 생성한 경우 가능
- Run time Binding
- 수행이 시작된 이후에도 프로세스의 메모리 상 위치를 옮길 수 있음
- CPU가 주소를 참조할 때마다 binding을 점검
- 하드웨어적인 지원필요 (MMU)
MMU (Memory Management Unit)#
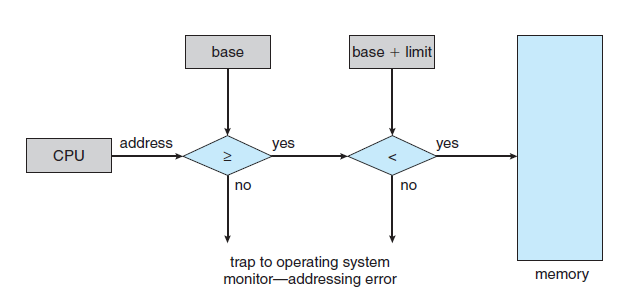
Run time Binding을 지원하기 위한 하드웨어 장치로 2개의 레지스터를 가지고 있다.
- Relocation Register
- 프로세스 메모리의 시작 주소를 가르킨다.
- Limit Register
- 프로세스 메모리의 길이를 나타낸다.
- Dynamic Relocation
- 논리 주소를 물리적 메모리에 재배치 해주는 방식
- Hardware Support for Address Translation
- 자신의 메모리 범위를 벗어난 접근을 하려고 하면 에러발생
Dynamic Loading#
- 프로세스 전체를 메모리에 미리 다 올리는 것이 아니라 해당 루틴이 불려질 때 메모리에 Load 하는 것
- 메모리 활용성의 향상
- 가끔씩 사용되는 많은 양의 코드의 경우 유용
- 운영체제의 특별한 지원 없이 프로그램 자체에서 구현 가능 (OS는 라이브러리를 통해 지원)
- 프로그래머가 직접 동적 로딩을 하도록 만드는 것
Overlay#
- 메모리에 프로세스의 부분 중 필요한 정보만을 올림
- 작은 공간의 메모리를 사용하던 초창기 시스템에서 수 작업으로 프로그래머가 구현
- Menual Overlay
- 프로그래밍이 매우 복잡
- OS 지원 없이 사용자가 모든것을 직접 구현해야한다.
Swapping#
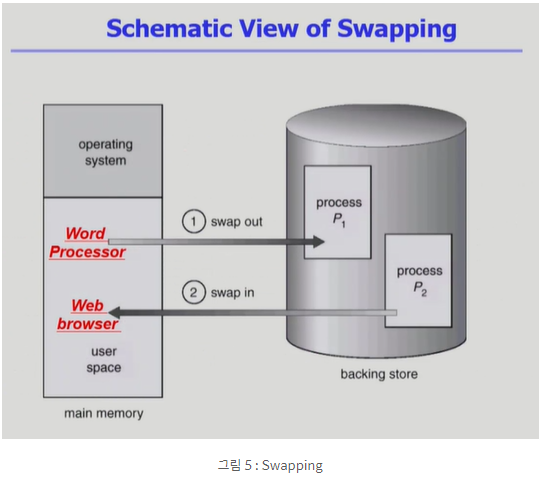
- 스와핑(Swapping)이란? 프로세스를 일시적으로 메모리에서 Backing store로 쫓아내는 것
- Backing store (=swap area)
- 디스크) 많은 사용자의 프로세스 이미지를 담을 만큼 충분히 빠르고 큰 저장 공간
- Swap in / Swap out
- 일반적으로 중기 스케줄러에 의해 Swap out 시킬 프로세스 선정
- priority-based CPU scheduling algorithm
- Compile time or Load time binding에서는 원래 메모리 위치로 swap in 해야 함
- Run time Binding에서는 추후 빈 메모리 영역 아무 곳에서나 올릴 수 있음
- swap time은 대부분 transfer time(swap되는 양에 비례하는 시간)임
Linking#
링킹이란 여러 군데 존재하는 목적 파일들을 묶어서 하나의 실행 파일을 만드는 과정을 뜻한다.
Static Linking#
- 라이브러리가 프로그램 실행 파일 코드에 포함
- 실행 파일의 크기가 커짐
- 동일한 라이브러리를 각각의 프로세스가 메모리에 올리므로 메모리 낭비
Dynamic Linking#
- 링킹을 실행시간 까지 미루는 기법
- 라이브러리가 실행 시 연결 됨
- 라이브러리 호출 부분에 라이브러리 루틴의 위치를 찾기위한 stub이라는 작은 코드를 둠
- 라이브러리가 이미 메모리에 있으면 그 루틴의 주소로 가고 없으면 디스크에서 읽어옴
- 운영체제의 도움이 필요함
- 다이나믹 링킹을 해주는 라이브러리를 Shared Library라고 한다
- 리눅스의 경우 shared object, 윈도우의 경우 dll
물리 메모리 관리 (Allocation of Physical Memory)#
물리적 메모리 관리를 어떻게 관리할 것인가?
- 메모리는 일반적으로 두 영역으로 나뉘어 사용
- OS 상중 영역 = Interrupt vector와 함께 낮은 주소 영역 사용
- 사용자 프로세스 영역 = 높은 주소 영역 사용
메모리 단편화#
- 외부 조각 (External fragmentation)
- 프로그램의 크기보다 분할의 크기가 작아서 다른 분할로 들어가야하는 문제
- 내부 조각 (Internal fragmentation)
- 프로그램의 크기보다 분할의 크기가 큰 문제
연속 할당 방식(Configuous allocaion)#
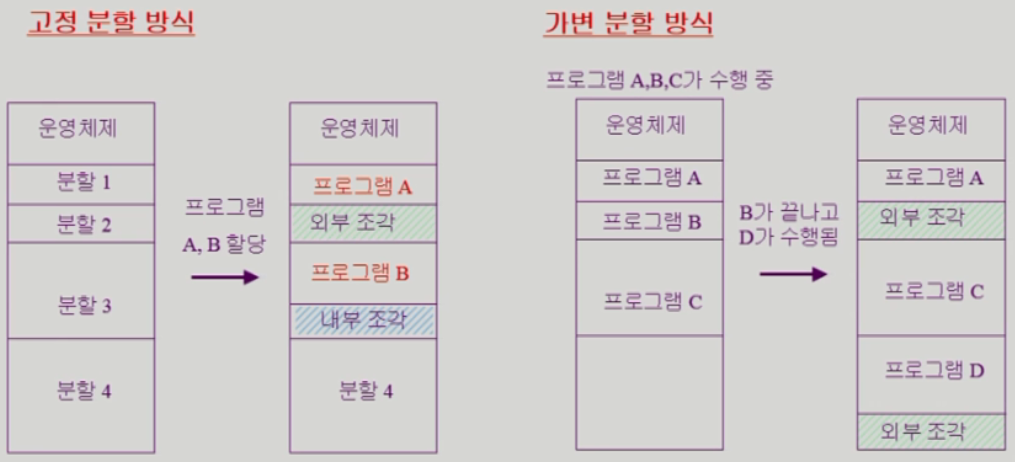
- 고정 분할 방식
- 물리적 메모리를 몇 개의 영구적 분할로 나누어 사용하는 방식
- 분할의 크기가 모두 동일한 방식과 서로 다른 방식이 존재
- 분할당 하나의 프로그램 적재
- 융통성이 없음
- 동시에 메모리에 로드되는 프로그램수가 고정, 최대 수행 가능 프로그램 제한
- Internal fragmentation 발생 (External fragmentation도 발생)
- 가변 분할 방식
- 프로그램의 크기를 고려해서 할당
- 분할의 크기 개수가 동적으로 변함
- 기술적 관리 기법 필요
- External fragmentation 발생
- Hole
- 가용 메모리 공간을 의미한다.
- 다양한 크기의 Hole들이 메모리 곳곳에 흩어져 있다.
- 프로세스가 도착하면 수용 가능한 Hole을 할당한다.
- Dynamic Storage-Allocation Problem
- First-fit
- size가 n이상인 것 중에 최초로 찾아지는 hole에 할당
- Best-fit
- size가 n이상인 가장 작은 hole을 찾아서 할당
- hole들의 리스트가 크기순으로 정렬되지 않을 경우 모든 hole의 리스트를 탐색
- 많은 수의 아주 작은 hole들이 생성
- Worst-fit
- 가장 큰 hole에 할당, 모든 리스트를 탐색, 상대적으로 아주 큰 hole들이 생성
- first-fit과 best-fit이 worst-fit보다 속도와 공간 측면에서 효과적이다.
- Compaction
- 메모리 단편화 문제를 해결하는 방법
- 사용중인 메모리 영역을 한군데로 몰고, hole들을 다른 한곳으로 몰아서 큰 block을 만든다.
- 매우 비용이 많이 든다 → 바인딩을 다 관리해야되서
- 최소한의 메모리 이동으로 compaction을 하는 방법 → 매우 복잡한 문제
- compaction은 프로세스의 주소가 실행 시간에 동적으로 재배치 가능한 경우에만 수행될 수 있다.
비연속 할당 방식(Conconfiguous allocaion)#
비연속 할당방식은 연속 할당방식의 단편화 문제에서 비교적 자유로울 수 있는 현대적인 방법이다.
Paging#
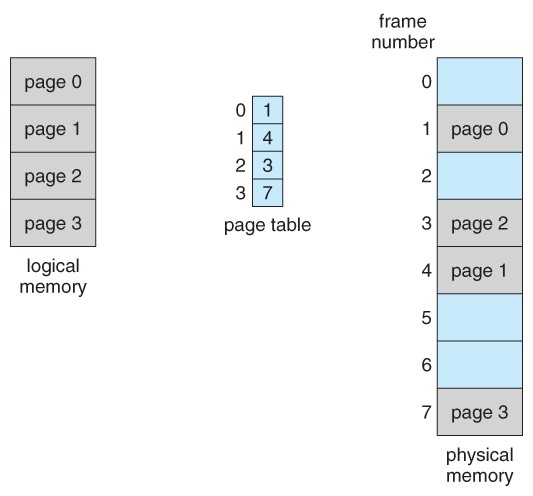
프로세스가 구성하는 주소 공간을 같은 크기의 Page로 잘라서 관리하는 기법
Paging 기법은 Logical address를 Page 단위로, Physical address를 같은 크기인 Frame 단위로 나누어 올리고 접근
- Page Table
- 왜 Page Table이 필요한가?
- 프로세스를 일정한 크기의 페이지로 쪼갰기 때문에 이를 접근하기 위해서는 메모리 변환과정이 필요하기 때문에 페이지의 위치를 저장해두는 테이블이 필요하다.
- 페이지테이블은 각각의 프로세스마다 존재
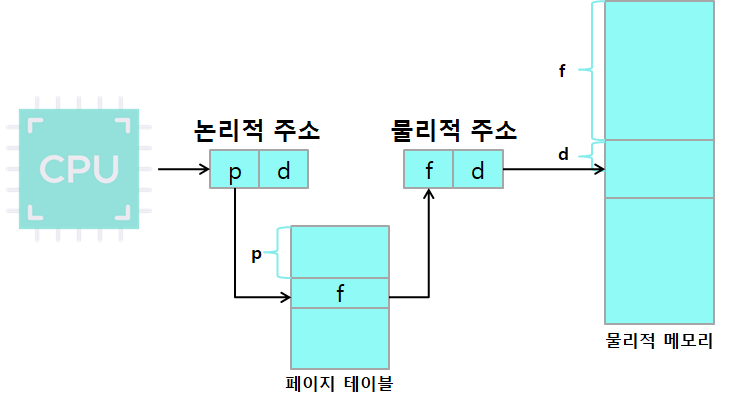
- Page기법 이용시의 MMU 레지스터는 무슨 역할을 하는가?
- page-table base register(PTBR)가 page table을 가리킨다
- page-table length register(PTLR)이 테이블의 크기를 보관
- Page Table은 어디에 위치해 있는가?
- Page Table은 물리 메모리에 존재한다.
- 이유인 즉슨, 관리해야하는 엔트리의 수가 많아서 레지스터로는 감당이 안된다.
- 때문에 메모리 변환과정에서 물리메모리 접근 → 물리메모리 접근이라는 오버헤드가 발생한다!
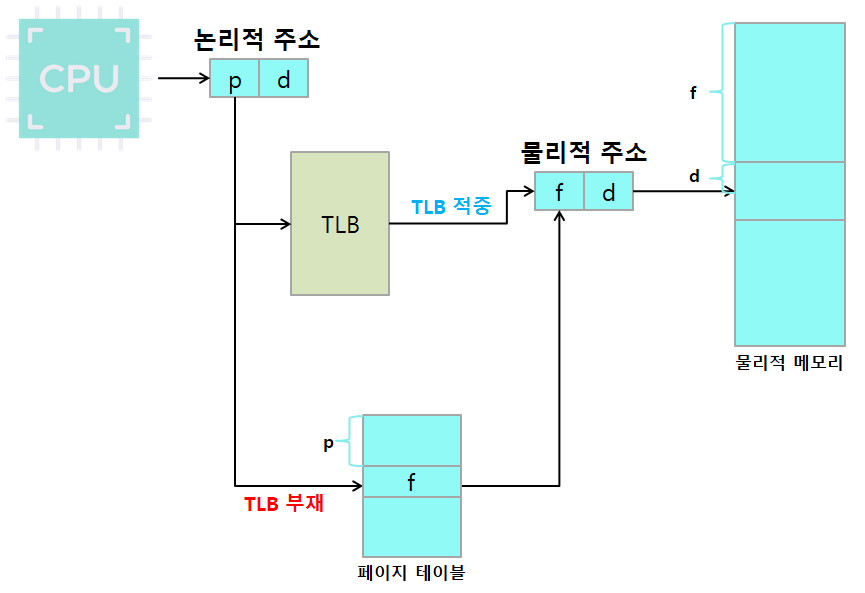
- TLB(Translation Look-aside Buffer)이란 무엇인가?
- Page 고속 접근을 위한 일종 Cache - 변환의 오버헤드가 존재하기 때문에 이용한다.
- 병렬탐색 레지스터인 Associative register를 통해서 보다 빠르게 이용이 가능하다.
- TLB는 context switch 때 flush(오래된 엔트리를 비운다)
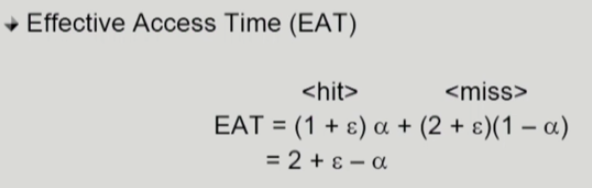
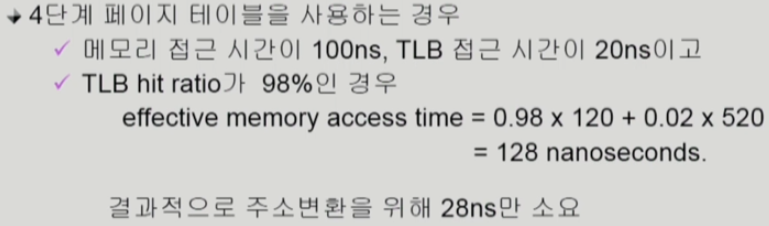
- Two-Level Page Table
참고이미지
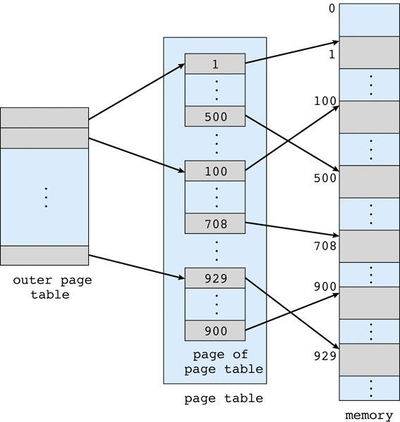
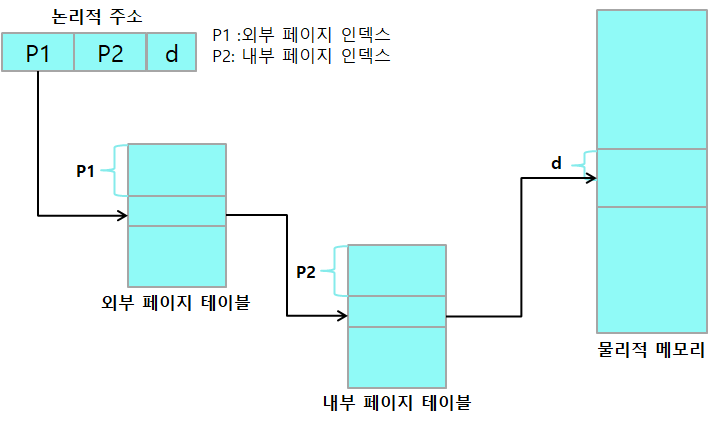
- 현대의 컴퓨터는 매우 큰 주소체계를 가진다. (32, 64 Bit)
- Page Table은 모든 프로세스가 하나씩 가지지만 사용하는 Page는 일부에 불과하다.
결과적으로 사용하지 않는 Page Table은 메모리의 낭비로 이어지게 된다.- 32Bit 시스템 기준으로 4G의 주소 공간 표현이 가능하다.
- 이 시스템에서 Page size가 4KB라면 1MB 개의 페이지 엔트리가 필요하고, 한개의 엔트리는 4Byte 정도기 때문에 프로세스마다 4MB의 Page Table이 필요함.
- 때문에 이런 메모리 낭비를 막아보고자 등장한것이 이중 페이지 테이블이다.
- 메모리 낭비를 막는 이론
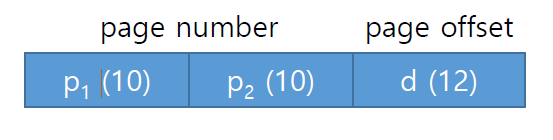
- 32bit 중 12bit는 offset을 표현하는 데 사용함
- 남은 20bit로 페이지를 접근하면 4Byte로 프로세스마다 4MB의 페이지 테이블이 필요한데 사실 다쓰는것도 아니고 미리 할당하기에는 너무 낭비가 많음
- 여기서 앞서 20Bit를 다시 10Bit 씩 나누어 두 계층으로 테이블 구조를 사용하게 됨
- Outer 페이지 테이블이 Inner 페이지 테이블을 Null 값으로 설정해서 메모리 낭비를 막을 수 있음
- 단, 변환 과정을 2번 거치는 만큼 오버헤드가 크다.
- Valid / Invalid Bit
- 페이지 테이블이 사용되고 있다면 V(Valid)
- 페이지 테이블이 사용되고 있지 않다면 I(Invalid)
- Inverted Page Table
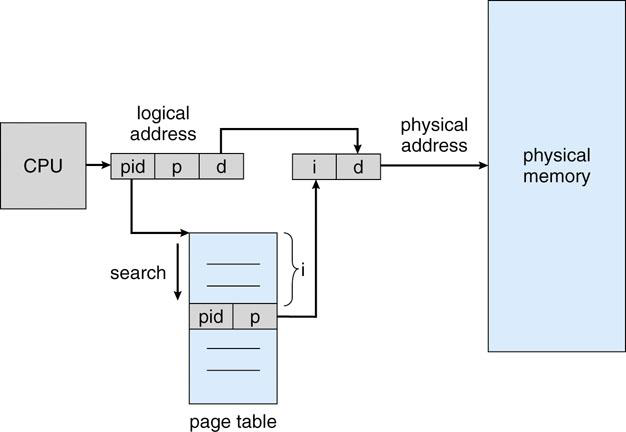
- 메모리 구조의 역전
- 시스템 내에 페이지 테이블이 하나만 존재하게 됨
- 프로세스 기준이 아닌 물리 메모리의 frame 갯수만큼 존재하게 된다.
- 따라서 어떤 프로세스의 페이지인지 알기 위해서 PID가 함께 저장되어야 한다.
- CPU는 논리 주소의 pid와 p와 맞는 entry를 찾기 위해 page table을 모두 서치한다.
- 공간적 이득은 큼 하지만 모든 엔트리에 접근하기 때문에 병렬적으로 서치해야한다. (오버헤드 발생 가능성이 크다)
- Shared Page
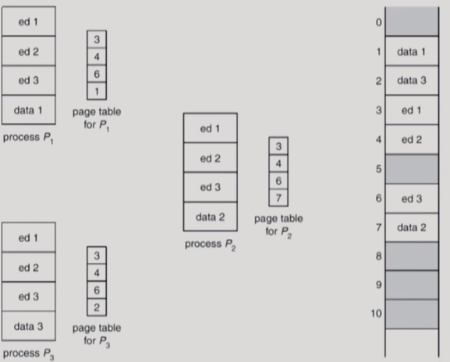
- 공유 페이지가 되기 위한 조건 2가지
- ReadOnly 여야만 한다.
- Logical Memory의 위치가 동일해야만 한다.
- Memory Protection
- 보호비트를 통해서 메모리의 연산 접근에 대해서 제한을 둘수 있다.
- Read / Write / ReadOnly
Segmentation#
참고이미지
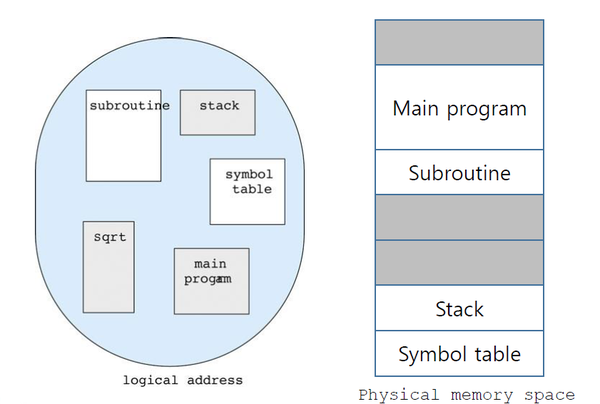
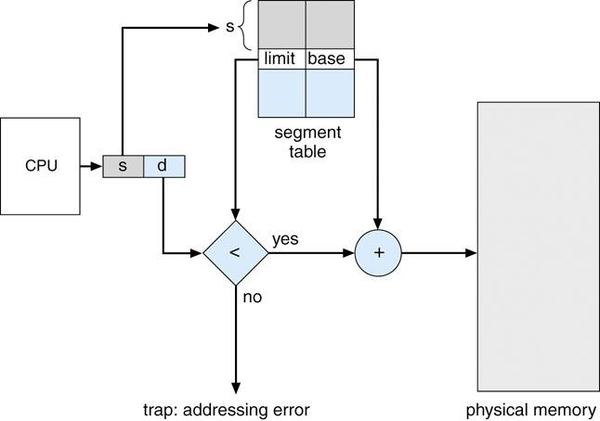
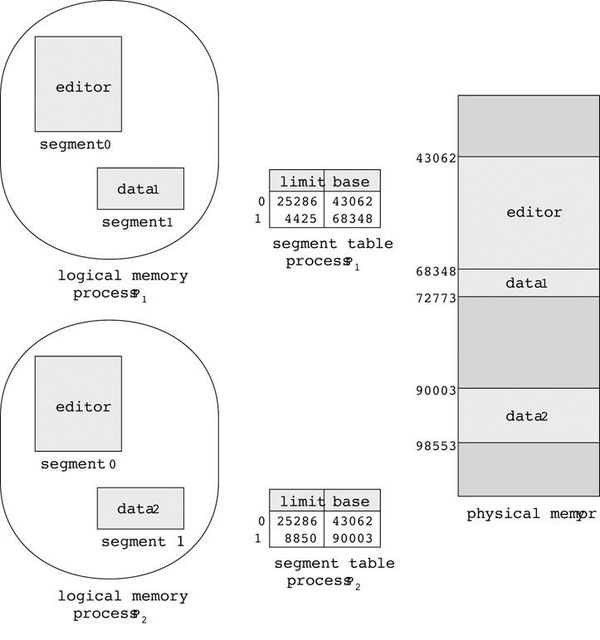
- 의미가 있는 블록으로 메모리를 나누는 기법(정적 변수, 메소드, 심볼 등등)
- 페이징과는 달리 각 세그먼트의 크기가 다르다.
- Segmentation Table에 접근하는 S 값에 대해서 먼저 Limit를 초과하는지 검사
를 통해 잘못된 주소 접근을 막는다. - Segmentation 기법에서 MMU의 레지스터는 뭘로 이용될까?
- Segment-table base register (STBR)
- 세그먼트 테이블의 시작위치를 담고있다.
- Segment-table length register(STLR)
- 프로그램이 사용하는 세그먼트의 수를 담고 있다.
- Page 기법에 비해서 얻을 수 있는 장점은 뭘까?
- 논리적 단위로 나뉘기 때문에 보안, 메모리 상태, 쉐어링 등의 장점을 얻을 수 있음
- 메모리 배치
- First-fit or Best-fit을 이용한다
- 외부조각 발생 가능성이 있다.
Paged-Segmentation#
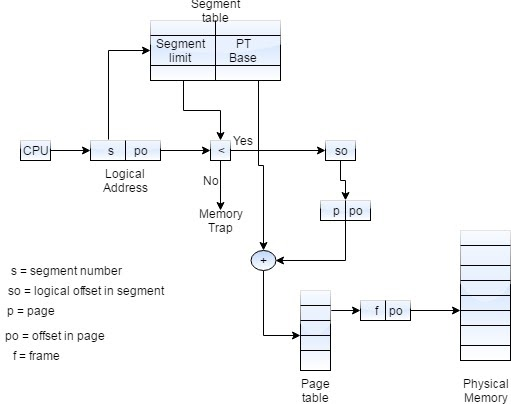
논리적 단위인 세그먼트로 먼저 메모리를 나누고 한번더 페이지로 나누어 관리하는 기술
- 세그먼트 하나당 페이지 테이블이 하나 존재함
- 때문에 세그먼트를 얻어오면 페이지 테이블의 시작주소를 가져올 수 있음
- 세그먼트 길이가 페이지 테이블의 길이기 때문에 세그먼트 길이를 통해서 Trap 발생 가능
- 세그먼트 길이보다 Offset 길이가 크다면 잘못된 메모리 접근으로 Trap
- 세그먼트 Offset을 잘라서 앞부분은 페이지 번호로, 뒷부분은 페이지 오프셋으로 사용한다.