8장 - 인덱스
- Created
- 2022년 9월 3일 PM 8:32
- 각 인덱스의 특성과 차이는 상당히 중요
- 물리 수준의 모델링을 할 때도 중요한 요소가 됨
- 아무리 서버의 옵티마이저가 발전하고 성능이 개선되어도 여전히 관리자의 역할은 매우 중요
- 인덱스에 대한 기본 지식은 지금도 앞으로도 개발자나 관리자에게 매우 중요한 부분
- 쿼리 튜닝의 기본이 될것
8.1 디스크 읽기 방식#
데이터베이스의 성능 튜닝은 어떻게 디스크 I/O를 줄이느냐가 관건일 때가 상당히 많음
8.1.1 HDD와 SSD#
- 컴퓨터에서 CPU나 메모리 같은 주요 장치는 대부분 전자식 장치지만 HDD는 기계식 장치
- 때문에 DB에서 디스크는 늘 병목이 됨
- HDD를 대체하기 위해 전자식 저장장치인 SSD가 많이 출시되고 있음
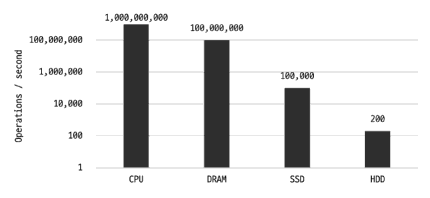
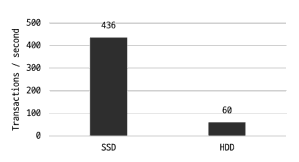
- 초당 처리 가능한 연산의 횟수를 의미하므로 이 값이 클수록 처리 속도가 빠르다는 것을 의미
- 메모리와 디스크의 처리 속도는 10만 배 이상의 차이를 보임
- 디스크의 헤더를 움직이지 않고 한 번에 많은 데이터를 읽는 순차 I/O
- SSD가 하드 디스크 드라이브보다 조금 빠르거나 거의 비슷한 성능을 보이기도 함
- 하지만 SSD의 장점은 기존 HDD보다 랜덤 I/O가 훨씬 빠르다는 것
- DB에선 순차 I/O 작업의 비중이 크지 않고 랜덤 I/O를 통해 작은 데이터를 읽고 쓰는 작업이 대부분
- 일반적인 웹 서비스 환경의 데이터베이스에서는 SSD가 HDD 보다 훨씬 빠르다.
8.1.2 랜덤 I/O와 순차 I/O#
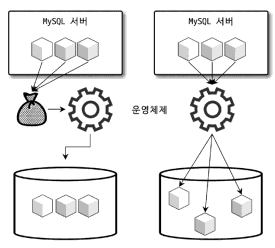
- 랜덤 I/O는 HDD의 플래터(원판)를 돌려서 데이터가 저장된 위치로 디스크 헤더를 이동시킨 다음 데이터를 읽는 것을 의미
- 3개의 페이지를 기록하기 위한 시스템콜 요청 횟수 차이
- 순차 I/O는 1번 시스템 콜을 요청
- 1번의 헤더를 이동한 것을 의미
- 랜덤 I/O는 3번 시스템 콜을 요청
- 3번의 헤더를 이동한 것을 의미
- 디스크의 성능은 헤더의 위치 이동 없이 얼마나 많은 데이터를 한 번에 기록하느냐에 의해 결정 된다고 볼 수 있음
- 때문에 헤더를 많이 이동하는 랜덤 I/O 작업이 작업 부하가 훨씬 더 큼
- SSD는 랜덤 I/O와 순차 I/O의 차이가 없을 것으로 예측하지만, 실제로는 그렇지 않다.
- SSD도 랜덤 I/O는 순차 I/O 보다 전체 스루풋이 떨어진다.
- 사실 쿼리를 튜닝해서 랜덤 I/O를 순차 I/O로 바꿔서 실행할 방법은 그다지 많지 않음
- 일반적으로 쿼리를 튜닝하는 것은 랜덤 I/O 자체를 줄여주는 것이 목적!
8.2 인덱스란?#
- 많은 사람이 인덱스를 언급할 때는 항상 책의 맨 끝에 있는 찾아보기(A.K.A. 색인)로 설명함
- 찾아보기가 인덱스라면 내용은 데이터 파일임
- DBMS도 테이블의 모든 데이터를 검색해서 원하는 결과를 가져오려면 시간이 오래 걸림
- 그래서 칼럼의 값과 해당 레코드가 저장된 주소를 키와 값으로 삼아 인덱스를 만들어 두는 것
- 찾아보기와 인덱스의 공통점 가운데 중요한 것이 바로 정렬
- 인덱스는 칼럼의 값을 주어진 순서로 미리 정렬 후 보관함
- DBMS에서 인덱스는 데이터의 저장(INSERT, UPDATE, DELETE) 성능을 희생하고 그 대신 데이터의 읽기 속도를 높이는 기능
- 데이터의 저장 속도를 어디까지 희생할 수 있는지, 읽기 속도를 얼마나 더 빠르게 만들어야 하느냐에 따라 결정해야 한다.
- 검색 쿼리 문장의 조건절에 사용되는 칼럼이라고 해서 전부 인덱스로 생성하면 데이터 저장 성능이 떨어지고 인덱스의 크기가 비대해져 오히려 역효과만 불러올 수 있다.
- 인덱스는 데이터를 관리하는 방식(알고리즘)과 중복 값의 허용 여부 등에 따라 여러 가지로 나눠볼 수 있다.
- 인덱스를 역할별로 구분해 본다면 프라이머리 키(Primary key)와 보조 키(세컨더리 인덱스, Secondary key)로 구분할 수 있다.
- 프라이머리 키는 이미 잘 아는 것처럼 그 레코드를 대표하는 칼럼의 값으로 만들어진 인덱스를 의미
- 프라이머리 키를 제외한 나머지 모든 인덱스는 세컨더리 인덱스(Secondary Index)로 분류한다.
- 해당 레코드를 식별할 수 있는 기준값이 됨 우리는 이를 식별자라고도 부른다.
- 프라이머리 키는 NULL 값을 허용하지 않으며 중복을 허용하지 않는 것이 특징
- 인덱스는 대표적으로 B-Tree 인덱스와 Hash 인덱스로 구분할 수 있다
- 최근에는 Fractal-Tree 인덱스나 로그 기반의 Merge-Tree 인덱스와 같은 알고리즘을 사용하는 DBMS도 개발되고 있다
- B-Tree 알고리즘은 가장 일반적으로 사용되는 인덱스 알고리즘
- 오래전 도입되어 상당히 성숙한 상태
- 칼럼의 값을 변형하지 않고 원래의 값을 이용해 인덱싱하는 알고리즘이다.
- Hash 인덱스 알고리즘은 칼럼의 값으로 해시값을 계산해서 인덱싱하는 알고리즘
- 범위 검색시 인덱싱 사용 불가
- 메모리 기반 DB에서 많이 사용 됨
- 인덱스는 유니크/논유니크 인덱스로 구분할 수 있음
- 단순히 데이터가 1개만 존재하는지 아닌지를 의미하지만 옵티마이저에겐 상당히 중요
8.3 B-Tree 인덱스#
B-Tree는 데이터베이스의 인덱싱 알고리즘 가운데 가장 일반적으로 사용되고, 가장 먼저 도입된 알 고리즘이다. 하지만 아직도 가장 범용적인 목적으로 사용되는 인덱스 알고리즘이다.
- 일반적으로 DBMS에서는 주로 B+-Tree 또는 B*-Tree 가 사용된다.
- B-Tree의 B는 Binary가 아닌 Balanced다!
- 칼럼의 원래 값을 변형시키지 않고 인덱스 구조체 내에서는 항상 정렬된 상태로 유지
- 전문 검색이 아닌 경우 대다수의 인덱스는 B-Tree를 사용
8.3.1 구조 및 특성#
B-Tree는 트리 구조의 최상위에 하나의 Root Node가 존재하고 그 하위에 자식노드가 붙어 있는 형태
- 가장 하위에 있는 노드를 Leaf Node라 한다.
- 루트도 리프도 아닌 노드를 Branch Node라고 한다.
- 인덱스의 리프 노드는 항상 실제 데이터 레코드를 찾아가기 위한 주솟값을 가지고 있다.
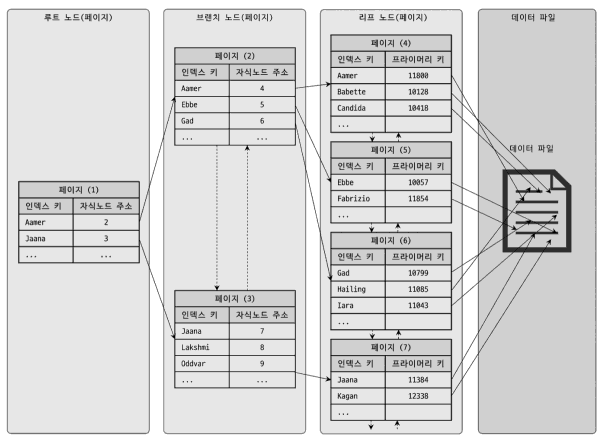
- 인덱스는 정렬되어 있지만, 데이터 파일은 그렇지 않다.
- 파일의 레코드는 INSERT된 순서대로 저장되는 것으로 생각하지만 그렇지 않다.
- 만약 테이블의 레코드를 전혀 삭제하거나 변경하지 않고 INSERT만 수행한다면 맞을 수도 있다
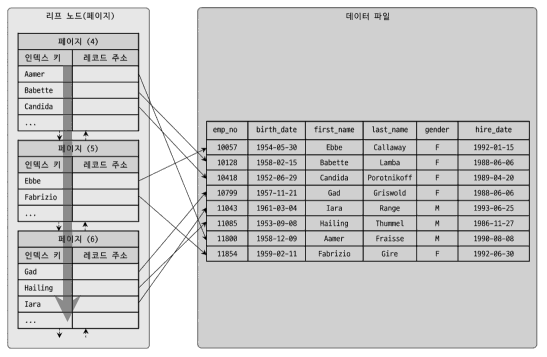
- 레코드 주소는 MyISAM 테이블의 생성 옵션에 따라 레코드가 테이블에 INSERT된 순번이거나 데이터 파일 내의 위치
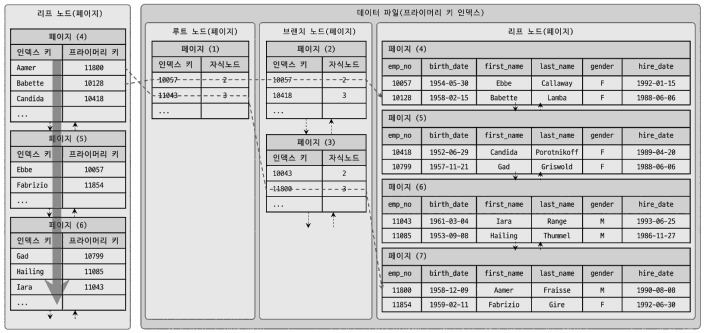
- InnoDB 스토리지 엔진을 사용하는 테이블에서는 프라이머리 키가 ROWID의 역할을 함
- 두 스토리지 엔진의 인덱스에서 가장 큰 차이점은 세컨더리 인덱스를 통해 데이터 파일의 레코드를 찾아가는 방법
- MyISAM 테이블은 세컨더리 인덱스가 물리적인 주소를 가짐
- InnoDB 테이블은 프 라이머리 키를 주소처럼 사용하기 때문에 논리적인 주소를 가짐
- InnoDB는 인덱스를 통해 파일을 바로 찾아기는게 아닌 PK를 이용해 리프 페이지를 검색해 레코드를 읽어야 한다.
- InnoDB 스토리지 엔진에서는 모든 세컨더리 인덱스 검색에서 데이터 레코드를 읽기 위해 서는 반드시 프라이머리 키를 저장하고 있는 B-Tree를 다시 한번 검색해야 함
8.3.2 B-Tree 인덱스 키 추가 및 삭제#
8.3.2.1 인덱스 키 추가#
새로운 키 값이 B-Tree에 저장될 때 테이블의 스토리지 엔진에 따라 새로운 키 값이 즉시 인덱스에 저장될 수도 있고 그렇지 않을 수도 있음
- 저장될 위치가 결정되면 레코드의 키 값과 대상 레코드의 주소 정보를 B-Tree의 리프 노드에 저장 함
- 리프 노드가 꽉 차서 더는 저장할 수 없을 때는 리프 노드가 분리해야 함
- 이는 상위 브랜치 노드까지 처리의 범위가 넓어 짐
- 이러한 작업 탓에 B-Tree는 상대적으로 쓰기 작업에 비용이 많이 드는 것으로 알려졌다.
- 일반적으로 테이블에 인덱스가 3개가 있다면
- 이때 테이블에 인덱스가 하나도 없는 경우는 작업 비용이 1이고, 3개인 경우에는 5.5 정도의 비용(1.5 * 3 + 1) 정도로 예측
- 중요한건 대다수 디스크로 인덱스 페이지를 읽고 쓰는 비용이 오래걸림
- MyISAM/MEMORY 스토리지 엔진을 사용하는 테이블에서는 INSERT 문장이 실행되면 즉시 새로 운 키 값을 B-Tree 인덱스에 변경한다.
- InnoDB 스토리지 엔진은 이 작업을 조금 더 지능적으로 처리함
- 필요하다면 인덱스 키 추가 작업을 지연시켜 나중에 처리할 수 있다.
- 하지만 프라이 머리 키나 유니크 인덱스의 경우 중복 체크가 필요하기 때문에 즉시 B-Tree에 추가하거나 삭제한다.
8.3.2.2 인덱스 키 삭제#
B-Tree의 키 값이 삭제되는 경우는 상당히 간단
- 해당 키 값이 저장된 B-Tree의 리프 노드를 찾아서 그냥 삭제 마크만 하면 작업이 완료된다.
- 인덱스 키 삭제로 인한 마킹 작업 또한 디스크 쓰기가 필요하므로 이 작업 역 시 디스크 I/O가 필요한 작업이다.
- InnoDB에선 이 작업 또한 버퍼링 되어 지연 처리될 수 있음
- MyISAM/MEMORY 스토리지 엔진의 테이블에서는 체인지 버퍼와 같은 기능이 없으므로 인덱스 키 삭제가 완료된 후 쿼리 실행이 완료됨
8.3.2.3 인덱스 키 변경#
인덱스의 키 값은 그 값에 따라 저장될 리프 노드의 위치가 결정됨
- B-Tree의 키 값이 변경되는 경우에는 단순히 인덱스상의 키 값만 변경하는 것은 불가능
- B-Tree의 키 값 변경 작업은 먼 저 키 값을 삭제 후, 다시 새로운 키 값을 추가하는 형태로 처리 됨
- 키 값 변경시 앞서 말한 삭제/추가 작업의 절차대로 처리 됨
- InnoDB에선 이 작업을 모두 체인지 버퍼를 활용해 지연처리 가능
8.3.2.4 인덱스 키 검색#
앞서 여러 작업을 실행한 이유는 빠른 검색을 위해서 임
- 인덱스를 검색시 B-Tree의 루트 노드부터 시작해 브랜치 노드를 거쳐 최종 리프 노드까지 이동하면서 비교 작업을 수행
- 이 작업을 트리 탐색이라 함
- 트리 탐색은 SELECT뿐만 아니라 UPDATE 나 DELETE를 처리하기 위해 항상 해당 레코드를 먼저 검색해야 할 경우에도 사용됨
- B-Tree 인덱스를 이용한 검색은 100% 일치 또는 값의 앞부분만 일치하는 경우에 사용할 수 있다
- 부등호비교 조건에서도 인덱스를 활용할 수 있음
- 인덱스를 구성하는 키 값의 뒷부분만 검색하는 용도로는 인덱스를 사용할 수 없다
- 인덱스의 키 값에 변형이 가해진 후 비교 되는 경우에는 절대 B-Tree의 빠른 검색 기능을 사용할 수 없음
- 이미 변형된 값은 B-Tree 인덱스에 존재하는 값이 아니다.
- 따라서 함수나 연산을 수행한 결과로 정렬한다거나 검색하는 작업은 B-Tree의 장점을 이용할 수 없으므로 주의
- InnoDB에서 지원하는 레코드 잠금이나 넥스트 키락(갭락)이 검색을 수행한 인덱스를 잠근 후 테이블의 레코드를 잠그는 방식으로 구현돼 있다.
8.3.3 B-Tree 인덱스 사용에 영향을 미치는 요소#
B-Tree 인덱스는 인덱스를 구성하는 칼럼의 크기와 레코드의 건수, 그리고 유니크한 인덱스 키 값의 개수 등에 의해 검색이나 변경 작업의 성능이 영향을 받는다.
8.3.3.1 인덱스 키 값의 크기#
InnoDB 스토리지 엔진은 디스크에 데이터를 저장하는 가장 기본 단위를 Page or Block이라고 하며, 디스크의 모든 읽기 및 쓰기 작업의 최소 작업 단위가 된다.
- Page는 InnoDB의 버퍼 풀에서 데이터를 버퍼링하는 기본 단위기도 함
- 이진트리는 각 노드가 자식 노드를 2개만 가짐
- DBMS의 B-Tree가 이진 트리라면 인덱스 검색이 상당히 비효율적일 것
- 일반적으로 DBMS의 B-Tree는 자식 노드의 개수가 가변적인 구조
- B-Tree의 자식의 개수는 인덱스 페이지 크기와 키 값의 크기에 따라 결정 됨
- InnoDB의 기본 페이지 값은 16KB
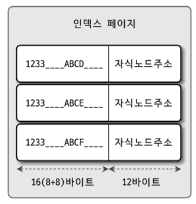
- 자식 노드의 주소 영역이 12바이트로 구성된다고 가정
- 계산해 보면 16*1024/(16+12) = 585개 저장할 수 있다.
- 키 값의 크기가 두 배인 32바이트로 늘어났다고 가정하면 한 페이지에 인덱스 키를 16*1024/(32+12) = 372
- 검색쿼리가 500개의 데이터를 읽어야 한다고 가정한다면 앞에선 한번의 스캔으로 끝나지만, 후자는 두번의 스캔이 필요함 = 그만큼 느려짐
- 인덱스 키 값의 길이가 길어진다는 것은 전체적인 인덱스의 크기가 커진다는 것을 의미
- 인덱스를 캐시해 두는 InnoDB의 버퍼 풀이나 MyISAM의 키 캐시 영역은 크기가 제한적
- 인덱스 크기가 커지면 커질수록 메모리에 캐시해 둘 수 있는 레코드 수는 줄어듬
- 메모리의 효율이 떨어지는 결과를 가져온다.
8.3.3.2 B-Tree 깊이#
B-Tree 인덱스의 깊이(Depth)는 상당히 중요하지만 직접 제어할 방법은 없다.
B-Tree의 깊이는 MySQL에서 값을 검색할 때 몇 번이나 랜덤하게 디스크를 읽어야 하는지와 직결되는 문제
- B-Tree 깊이가 3인 경우
- 키 값이 16바이트인 경우에는 최대 2억(585 * 585 * 585)개 정도
- 키 값이 32바이트로 늘어나면 5천만(372 * 372 * 372)개 정도
- 실제로는 아무리 대용량 데이터베이스라도 B-Tree의 깊이가 5단계 이상까지 깊어 지는 경우는 흔치 않다.
8.3.3.3 선택도 (기수성)#
인덱스에서 선택도(Selectivity) 또는 기수성(Cardinality)은 거의 같은 의미로 사용됨
- 모든 인덱스 키 값 가운데 유니크한 값의 수를 의미
- 전체 인덱스 100 중 유니크 값이 10이라면 기수성은 10임
- 인덱스 키 값 가운데 중복된 값이 많아질수록 기수성은 낮아지고 동시에 선택도 또한 떨어짐
- 선택도가 좋지 않다고 하더라도 정렬이나 그루핑과 같은 작업을 위해 인덱스를 만드는 것이 훨씬 나은 경우도 많다.
- 인덱스가 항상 검색에만 사용되는 것은 아니므로 여러 가지 용도를 고려해 적절히 인덱스를 설계할 필요가 있다.
8.3.3.4 읽어야 하는 레코드의 건수#
인덱스를 통해 테이블의 레코드를 읽는 것은 인덱스를 거치지 않고 바로 테이블의 레코드를 읽는 것보 다 높은 비용이 드는 작업이다.
- 일반적인 DBMS의 옵티마이저에서는 인덱스를 통해 레코드 1건을 읽는 것이 테이블에서 직접 레코드 1건을 읽는 것보다 4~5배 정도 비용이 더 많이 드는 작업인 것으로 예측한다.
- 인덱스를 통해 읽어야 할 레코드의 건수가 전체 테이블 레코드의 20~25%를 넘어서면?
- 인덱스를 이용하지 않고 테이블을 모두 직접 읽어서 필요한 레코드만 필터링하는것이 효율적
- 이렇게 많은 레코드를 읽을 때는 강제로 인덱스를 사 용하도록 힌트를 추가해도 성능상 얻을 수 있는 이점이 없다.
- 물론 이러한 작업은 MySQL의 옵티마이 저가 기본적으로 힌트를 무시하고 테이블을 직접 읽는 방식으로 처리하겠지만 기본으로 알고 있어야 할 사항
8.3.4 B-Tree 인덱스를 통한 데이터 읽기#
8.3.4.1 인덱스 레인지 스캔#
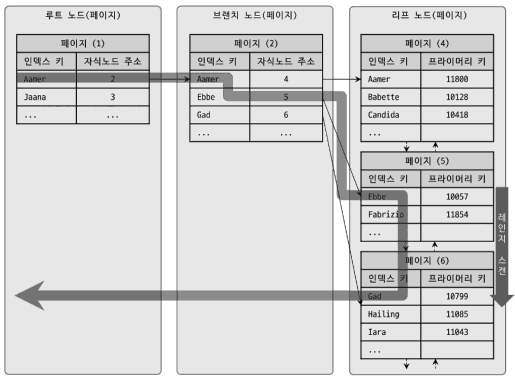
인덱스 레인지 스캔은 인덱스의 접근 방법 가운데 가장 대표적인 접근 방식으로, 뒤에서 설명할 나머지 두 가지 접근 방식보다는 빠른 방법이다.
- 인덱스 레인지 스캔은 검색해야 할 인덱스의 범위가 결정됐을 때 사용하는 방식이다.
- 검색하려는 값의 수나 검색 결과 레코드 건수와 관계없이 레인지 스캔이라고 표현
- 루트 노드에서부터 비교를 시작해 브랜치 노드를 거치고 최종적으로 리프 노드까지 찾아 들어가야만 비로소 필요한 레코드의 시작 지점을 찾을 수 있다.
- 일단 시작해야 할 위치를 찾으면 그때부 터는 리프 노드의 레코드만 순서대로 읽으면 된다.
- 최종적으로 스캔을 멈춰야 할 위치에 다다르면 지금까지 읽은 레코드를 사용 자에게 반환하고 쿼리를 끝낸다
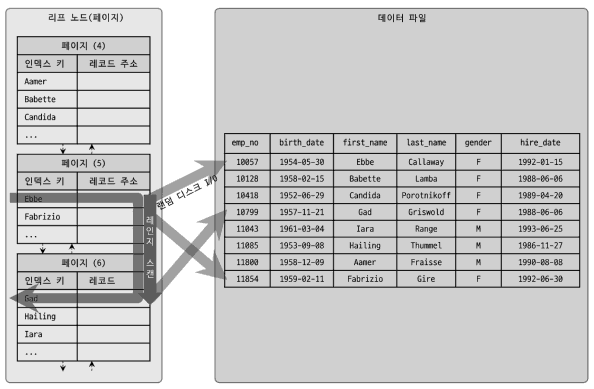
- B-Tree 인덱스에서 루트와 브랜치 노드를 이용해 스캔 시작 위치를 검색
- 그 지점부터 필요한 방향(오름차순 또는 내림차순)으로 인덱스를 읽어 나감
- 중요한 것은 어떤 방식으로 스캔하든 관계없이, 해당 인덱스를 구성하는 칼럼의 정순/역순으로 정렬된 상태로 레코드를 가져온다는 것
- 인덱스의 리프 노드에서 검색 조건에 일치하는 건들은 데이터 파 일에서 레코드를 읽어오는 과정이 필요하다는 것
- 인덱스 스캔의 3단계
- 인덱스에서 조건을 만족하는 값이 저장된 위치를 찾는다.
- 이 과정을 인덱스 탐색(Index seek)이라고 한다.
- 1번에서 탐색된 위치부터 필요한 만큼 인덱스를 차례대로 쭉 읽는다.
- 이 과정을 인덱스 스캔(Index scan)이라고 한다.
- 1번과 2번 합쳐서 인덱스 스캔으로 통칭하기도 한다.
- 2번에서 읽어 들인 인덱스 키와 레코드 주소를 이용해 레코드가 저장된 페이지를 가져오고, 최종 레코드를 읽어 온다.
8.3.4.2 인덱스 풀 스캔#
인덱스 레인지 스캔과 마찬가지로 인덱스를 사용
- 인덱스 레인지 스캔과는 달리 인덱스의 처음부터 끝까지 모두 읽는 방식
- 인덱스 풀 스캔이라고 한다.
- 대표적으로 쿼리의 조건절에 사용된 칼럼이 인덱스의 첫 번째 칼럼이 아닌 경우 인덱스 풀 스캔 방식이 사용 됨
- 일반적으로 인덱스의 크기는 테이블의 크기보다 작으므로 직접 테이블을 처음부터 끝까지 읽는 것보다 는 인덱스만 읽는 것이 효율적
- 쿼리가 인덱스에 명시된 칼럼만으로 조건을 처리할 수 있는 경우 주로 이 방식이 사용
- 레코드까지 모두 읽어야 한다면 이 방식으로 처리되지 않음
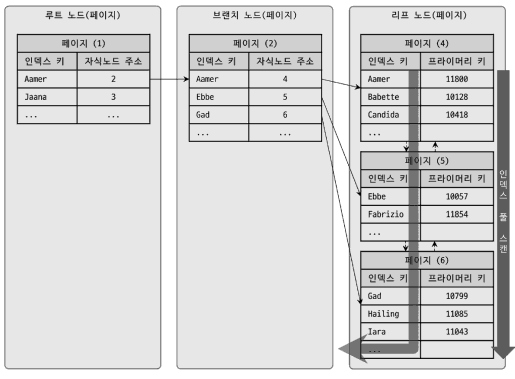
- 인덱스 리프 노드의 제일 앞 또는 제일 뒤로 이동한 후, 인덱스의 리프 노드를 연결하는 링크드 리스트를 따라 처음부터 끝까지 스캔하는 방식을 인덱스 풀 스캔이라고 한다.
- 레인지 스캔보다는 느리지만 테이블 풀 스캔보다는 효율적
8.3.4.3 루스 인덱스 스캔#
많은 사용자에게 루스(Loose) 인덱스 스캔 이라는 단어는 상당히 생소할 것
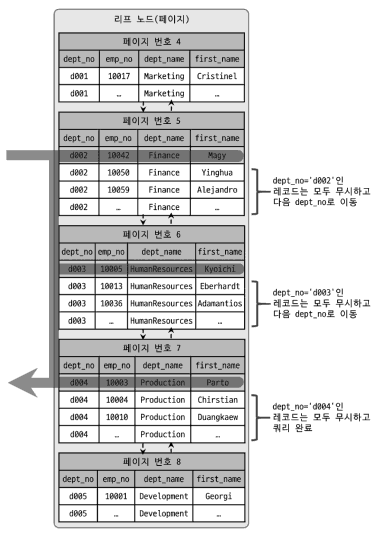
루스 인덱스 스캔 이란 말 그대로 느슨하게 또는 듬성듬성하게 인덱스를 읽는 것을 의미
- 앞에서 소개한 두 가지 접근 방법은 루스 인덱스 스캔과는 상반된 의미에서 타이트 인덱스 스캔으로 분류
- 레인지 스캔과 비슷하지만 중간에 필요하지 않은 인덱스는 무시하며 다음으로 넘어가는 형태로 처리
- 일반적으로 GROUP BY 또는 집합 함수 가운데 MAX() 또는 MIN() 함수에 대해 최적화를 하는 경우에 사용
8.3.4.4 인덱스 스킵 스캔#
데이터베이스 서버에서 인덱스의 핵심은 값이 정렬돼 있다는 것이며, 이로 인해 인덱스를 구성하는 칼 럼의 순서가 매우 중요하다.
- 이 인덱스를 사용하려면 WHERE 조건절에 칼럼에 대한 비교 조건이 필수
mysql> ALTER TABLE employees ADD INDEX ix_gender_birthdate (gender, birth_date);

-- // 인덱스를 사용하지 못하는 쿼리
mysql> SELECT * FROM employees WHERE birth_date>='1965-02-01';

-- // 인덱스를 사용할 수 있는 쿼리
mysql> SELECT * FROM employees WHERE gender='M' AND birth_date>='1965-02-01';- 주로 이런 경우에는 birth_date 칼럼부터 시작하는 인덱스를 새로 생성해야만 했다.
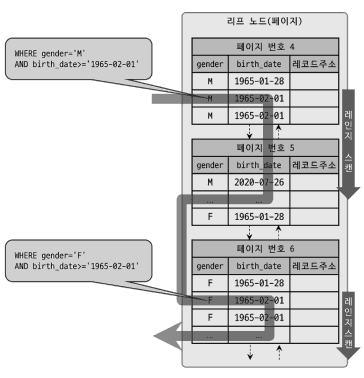
- MySQL 8.0부터는 옵티마이저가 gender 칼럼을 건너뛰어서 birth_date 칼럼만으로도 인덱스 검 색이 가능하게 해주는 인덱스 스킵 스캔(Index skip scan) 최적화 기능이 도입
- 이전 버전에도 인덱스 스킵 스캔과 비슷한 최적화를 수행하는 루스 인덱스 스캔이라는 기능이 있었다.
- 루스 인덱스 스캔은 GROUP BY 작업을 처리하기 위해 인덱스를 사용하는 경우에 만 적용할 수 있었다.
- 인덱스 스킵 스캔은 WHERE 조건절의 검색을 위해 사용 가능하도록 용도가 훨씬 넓어진 것
mysql> SET optimizer_switch='skip_scan=off';
mysql> EXPLAIN SELECT gender, birth_date FROM employees WHERE birth_date>='1965-02-01';
+----+-----------+-------+---------------------+--------------------------+
| id | table     | type  | key                 | Extra                    |
+----+-----------+-------+---------------------+--------------------------+
| 1  | employees | index | ix_gender_birthdate | Using where; Using index |
+----+-----------+-------+---------------------+--------------------------+- 위의 실행 계획에서 type 칼럼이 index라고 표시된 것은 인덱스를 처음부터 끝까지 모두 읽었다.
- 인덱스를 비효율적으로 사용한 것
- 이 쿼리는 gender 칼럼과 birth_date 칼럼만 있으면 처리를 완료할 수 있기 때문에 ix_gender_birthdate 인덱스를 풀 스캔한 것
mysql> SET optimizer_switch='skip_scan=off';
mysql> EXPLAIN SELECT gender, birth_date FROM employees WHERE birth_date>='1965-02-01';
+----+-----------+-------+---------------------+--------------------------+
| id | table     | type  | key                 | Extra                    |
+----+-----------+-------+---------------------+--------------------------+
| 1  | employees | range | ix_gender_birthdate | Using where; Using index |
+----+-----------+-------+---------------------+--------------------------+- type 칼럼의 값이 range로 표시됨, 이는 인덱스에서 꼭 필요한 부분만 읽었다는 것을 의미
- 그리고 실행 계획의 Extra 칼럼에
Using index for skip scan이라는 문구가 표시됨- 이는
ix_gender_birthdate인덱스에 대해 인덱스 스킵 스캔을 활용해 데이터를 조회했다는 것을 의미
- 인덱스 스킵 스캔은 MySQL 8.0 버전에 새로이 도입된 기능이어서 아직 다음과 같은 단점이 있다.
- WHERE 조건절에 조건이 없는 인덱스의 선행 칼럼의 유니크한 값의 개수가 적어야 함
- 인덱스 스킵 스캔은 인덱스의 선행 칼럼이 가진 유니크한 값의 개수가 소량일 때만 적용 가능한 최적화
- 쿼리가 인덱스에 존재하는 칼럼만으로 처리 가능해야 함(커버링 인덱스)
8.3.5 다중 칼럼 인덱스#
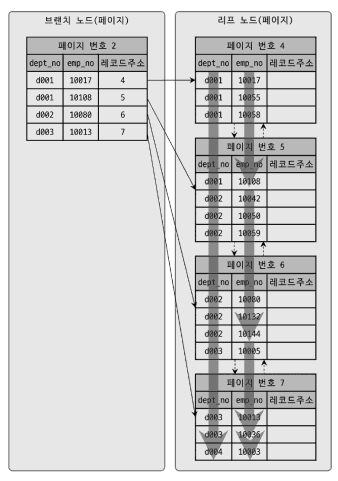
- 지금까지 살펴본 인덱스들은 모두 1개의 칼럼만 포함된 인덱스
- 하지만 실제 서비스용 데이터베이스에서는 2개 이상의 칼럼을 포함하는 인덱스가 더 많이 사용
- 두 개 이상의 칼럼으로 구성된 인덱스를 다중 칼럼 인덱스라고 하며, 또한 2개 이상의 칼럼이 연결됐다고 해서
Concatenated Index라고도 한다. - 그림에서는 생략 했으나 루트 노드와 리프 노드는 항상 존재
- 그림에서 중요한 것은 인덱스의 두 번째 칼럼은 첫 번째 칼럼에 의존해서 정렬돼 있다는 것
- 두 번 째 칼럼의 정렬은 첫 번째 칼럼이 똑같은 레코드에서만 의미가 있다는 것
- 예제에서
emp_no값의 정렬 순서가 빠르다고 하더라도dept_no칼럼의 정렬 순서가 늦다면 인덱스의 뒤쪽에 위치 - 예제에서
emp_no값이10003인 레코드가 인덱스 리프 노드의 제일 마지막에 위치하는 것
- 다중 칼럼 인덱스에서는 인덱스 내에서 각 칼럼의 위치(순서)가 상당히 중요하며, 그것을 아주 신중히 결정해야 함
8.3.6 B-Tree 인덱스의 정렬 및 스캔 방향#
인덱스를 생성할 때 설정한 정렬 규칙에 따라 인덱스의 키 값은 항상 오름차순이거나 내림차순으로 정렬되어 저장된다.
But. 인덱스가 오름차순으로 생성되었다고 하더라도 오름차순으로만 읽을 수 있는건 아님
인덱스를 어느 방향으로 읽을지는 쿼리에 따라 옵티마이저가 만드는 실행계획에 의해 결정됨
8.3.6.1 인덱스의 정렬#
- 일반적 사용 DBMS에서는 인덱스를 생성하는 시점에 인덱스를 구성하는 각 칼럼의 정렬을 오름/내림 차순으로 설정할 수 있다.
- MySQL 5.7 버전까지는 칼럼 단위로 정렬 순서를 혼합(ASC/DESC)해서 생성할 수 없었음
- 이런 문제 해결을 위해 숫자 칼럼의 경우 -1을 곱해 저장하는 우회방법을 사용했었음
- MySQL 8.0 부터는 다음과 같은 형태의 정렬 순서를 혼합한 인덱스도 생성할 수 있게 되었음
mysql> CREATE INDEX ix_teamname_userscore ON employees (team_name ASC, user_score DESC);5.3.6.1.1 인덱스 스캔 방향#
first_name칼럼에 대한 인덱스가 포함된employees테이블에 대해 아래 쿼리를 실행할때
mysql> SELECT * FROM employees ORDER BY first_name DESC LIMIT 1;- 인덱스는 항상 오픔차순으로만 정렬돼 있지만 인덱스를 최솟값부터 읽으면 오름차순으로 값을 가져올 수 있음
- 최대값부터 거꾸로 읽으면 내림차순으로 값을 가져올 수 있다는 것을 MySQL 옵티마이저는 이미 알고있음
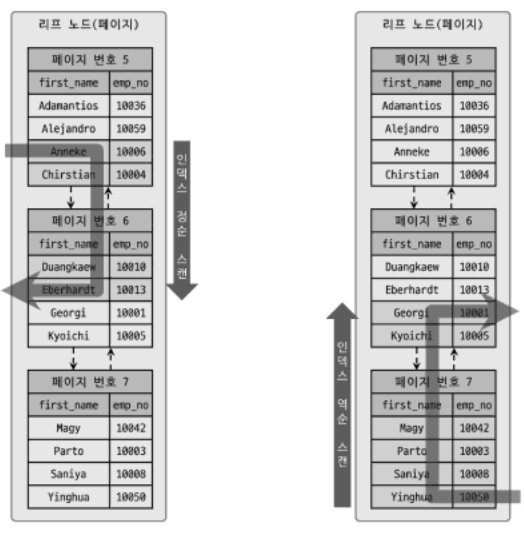
- 인덱스 생성 시점에 오름차순/내침차순으로 정렬이 결정되지만 쿼리가 그 인덱스를 사용하는 시점에 읽는 방향에 따라 오름/내림차순 정렬 효과를 얻을 수 있음!
- 쿼리의
ORDER BY처리나MIN()또는MAX()함수 등의 최적화가 필요한 경우에도 옵티마이저는 인덱스의 읽기 방향을 전환해 사용하도록 실행계획을 만듦
8.3.6.1.2 내림차순 인덱스#
MySQL 서버에서는 인덱스가 내림차순인지 오름차순인지 관계 없이 읽는 순서만 변경해서 해결이 가능하다.
mysql> CREATE INDEX ix_teamname_userscore ON employees (team_name ASC, user_score DESC);- 칼럼이 2개 이상으로 구성된 복합 인덱스는 각각의 칼럼이 내림/오름차순이 홉합된 경우 MySQL8.0의 내림차순 인덱스로만 해결이 가능하다.
first_name칼럼을 역순으로 정렬하는 요건만 있다면 다음 2개 인덱스 중 어떤 것을 선택하는게 좋을까?
8.3.7 B-Tree 인덱스 가용성과 효율성#
쿼리의 WHERE 조건이나 GROUP BY, 또는 ORDER BY 절이 어떤 경우에 인덱스를 사용할 수 있고 어떤 방식으로 사용할 수 있는지 식별할 수 있어야 한다.
8.3.7.1 비교 조건의 종류와 효율성#
다중 칼럼 인덱스에서 각 칼럼의 순서와 그 칼럼에 사용된 조건이 동등(=) 비교, 아니면 크다(>) 또는 작다(<) 같은 범위 조건인지에 따라 각 인덱스 칼럼의 활용 형태가 달라지면 그 효율 또한 달라짐
mysql> SELECT * FROM dept_emp WHERE dept_no='d002' AND emp_no >= 10114;해당 쿼리를 처리하기 위해 두 가지 케이스의 인덱스를 비교해보자
- A : INDEX (dept_no, emp_no)
dept_no=’d002’ AND emp_no10114인 레코드를 찾는다- 이후
dept_no가 d002가 아닐때 까지 쭉 읽는다.
- B : INDEX (emp_no, dept_no)
- `emp_no>=10144 AND depth_no='d002' 인 레코드를 찾는다.
- 이후 모든 레코드에 대해 dept_no가 d002인이 비교하는 과정을 거친다.
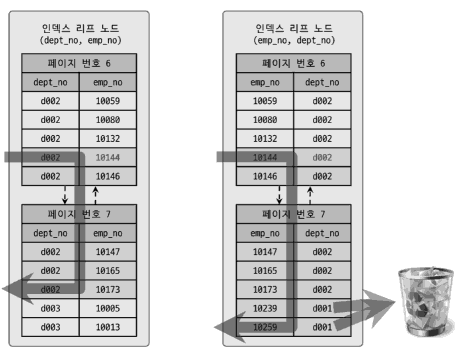
- 인덱스를 통해 읽은 레코드가 나머지 조건에 맞는지 비교하면서 선택하는 작업 = 필터링
- A와 B의 인덱스 비교가 다른이유
- 다중 칼럼 인덱스의 정렬 방식 때문
- 인덱스의 N번째 키 값은 N-1번째 키 값에 대해서 다시 정렬됨
- A인덱스의 경우 2번째 컬럼인
emp_no는 비교작업의 범위를 좁히는 데 도움을 줌- 작업 범위 결정 조건
- B인덱스의 경우 2번째 칼럼인
dept_no는 비교 작업의 범위를 좁히는 데 아무런 도움 X- 범위를 줄이지 못하고 단순히 거름종이 역할만 하는 조건
- 필터링 조건 또는 체크 조건
8.3.7.2 인덱스의 가용성#
B-Tree 인덱스의 특징은 왼쪽 값에 기준해서 오른쪽 값이 정렬돼 있다는 것
- 왼쪽이란 하나의 칼럼 내에서뿐만 아니라 다중 칼럼 인덱스의 칼럼에 대해서도 함께 적용 됨
- 인덱스 키 값의 이런 정렬 특성은 빠른 검색의 전제 조건
- 하나의 칼럼으로 검색해도 값의 왼쪽 부분이 없으면 인덱스 레인지 스캔 방식의 검색이 불가능
A : INDEX(first_name_
B : INDEX(dept_no, emp_no)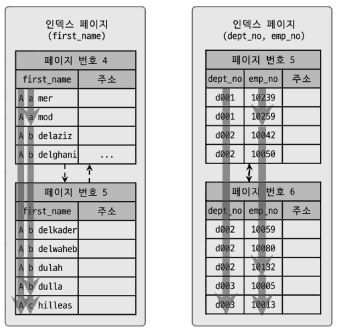
mysql> SELECT * FROM employees WHERE first_name LIKE '%mer';- 해당 쿼리는 인덱스 레인지 스캔 방식으로 이용 불가
first_name칼럼의 왼쪽부터 비교해야함- 해당 쿼리는 왼쪽값이 고정되 있지 않음
- 정렬 우선순위가 낮은 뒷부분의 값만으로는 왼쪽 기준 정렬 기반의 인덱스인 B-tree에서는 인덱스의 효과를 얻을 수 없다.
mysql> SELECT * FROM dpet_emp WHERE emp_no >= 10144;- 인덱스의 선행 칼럼인
dept_no조건 없이emp_no값으로만 검색하면 인덱스를 효율적으로 사용할 수 없다.dept_no칼럼에 대해 먼저 정렬 후 다시emp_no칼럼으로 정렬되기 때문
- 간단히
WHERE조건절에 대한 내용만 언급했지만 인덱스의 왼쪽 값 기준 규칙은GROUP BY절이 나ORDER BY절에도 동일 적용
8.3.7.3 가용성과 효율성 판단#
기본적으로 B-Tree 인덱스의 특성상 다음 조건에서는 사용 불가
- 사용할 수 없다는 것은 작업 범위 결정 조건으로 사용할 수 없다는 것을 의미
- 경우에 따라서는 체크 조건으로 인덱스 사용 가능
NOT-EQUAL로 비교된 경우 (<>,NOT IN,NOT BETWEEN,IS NOT NULL)
...WHERE column <> 'N'
...WHERE column NOT IN (10, 11, 12)
...WHERE column IS NOT NULL
LIKE ‘%??’앞부분이 나닌 뒷부분 일치 형태로 문자열 패턴이 비교된 경우
...WHERE column LIKE '%승환'- 스토어드 함수나 다른 연산자로 인덱스 칼럼이 변형된 후 비교된 경우
...WHERE SUBSTRING(column, 1, 1) = 'X'- NOT-DEERMINISTIC 속성의 스토어드 함수가 비교 조건으로 사용된 경우
...WHERE column = deterministic_function()- 데이터 타입이 서로 다른 비교 (인덱스 칼럼의 타입을 변환해야 비교가 가능한 경우)
...WHERE char_column = 10- 문자열 데이터 타입의 콜레이션이 다른 경우
...WHERE utf_bin_char_column = euckr_bin_char_column- 다른 일반적 DBMS에서는 NULL 값이 인덱스에 저장되지 않음
- MySQL에서는 NULL 값도 인덱스에 저장됨!
INDEX ix_test (column_1, column_2, column_3 ..., column_n)- 작업 범위 결정 조건으로 인덱스를 사용하지 못하는 경우
- column_1 칼럼에 대한 조건이 없는 경우
- column_1 칼럼의 비교 조건이 위의 인덱스 사용 불가 조건 중 하나일 경우
- 작업 범위 결정 조건으로 인덱스 사용이 가능한 경우
- column_1 ~ column_(i-1) 칼럼까지 동등 비교 형태로 비교
- column_1 칼럼에 대해 다음 연산자 중 하나로 비교
- 동등 비교, 크다 작다 형태, LIKE로 좌측 일치 패턴
- 위의 두 가지 조건을 모두 만족하는 쿼리는 column_1부터 column_i까지는 작업 범위 결정 조건으로 사용
- column_(i+1)부터 column_n까지의 조건은 체크 조건으로 사용
8.4.1 구조 및 특성#
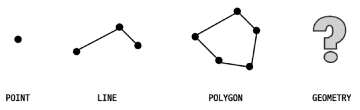
공간 정보의 저장 및 검색을 위한 여러 기하학적 도형 정보 관리타입을 제공함
- GEOMETRY 타입은 나머지 3개 타입의 슈퍼 타입
- POINT와 LINE, POLYGON 객체를 모두 저장 가능
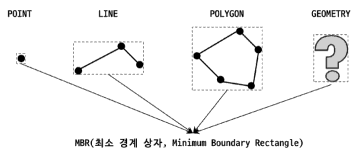
공간 정보의 검색을 위한 R-Tree 알고리즘을 이해하려면 MBR이라는 개념을 알고 있어야 한다.
- MBR이란
Minimum Bounding Rectangle의 약자- 해당 도형을 감싸는 최소 크기의 사각형을 의미
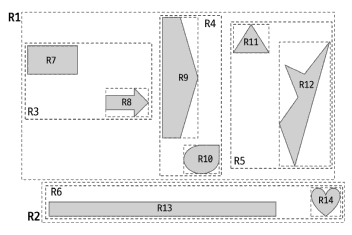
- 공간 데이터를 MBR 3개의 레벨로 나눔
- 최상위 (R1, R2), 차상위 (R3, R4, R5, R6), 최하위 (R7~R14)
- 최상위 MVR은 R-Tree의 루트노드에 저장되는 정보
- 차상위는 브랜치 노드
- 도형 객체는 리프 노드에 저장됨
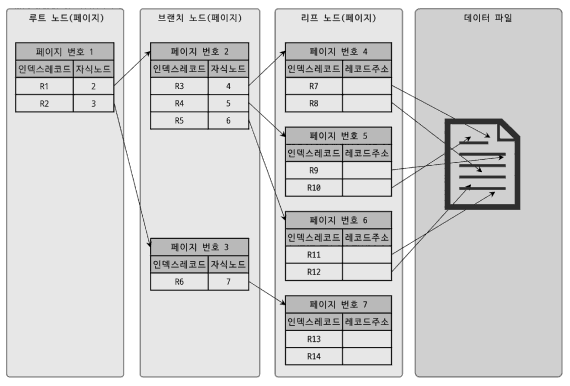
8.4.2 R-Tree 인덱스의 용도#
R-Tree는 MBR 정보를 이용해 B-Tree 형태로 인덱스를 구축하므로 Rectangle의 ‘R’ 과 B-Tree의 ‘Tree’를 섞어서 R-Tree라고 부르며, 공간(Spatial) 인덱스라고도 한다.
일반적으로는 GPS 기준의 위도, 경도 좌표 저장에 주로 사용된다.
- 하지만 위도, 경도 좌표뿐 아니라 CAD/CAM 소프트웨어 또는 회로 디자인 등과 같이 좌표 시스템에 기반을 둔 정보에 대해서는 모두 적용할 수 있다.
- R-Tree는
ST_Contains()또는ST_Within()과 같은 포함 관계 비교함수로 인덱스 활용 가능ST_Distance()와ST_Distance_Sphere()함수는 공간 인덱스를 효율적으로 사용하지 못함
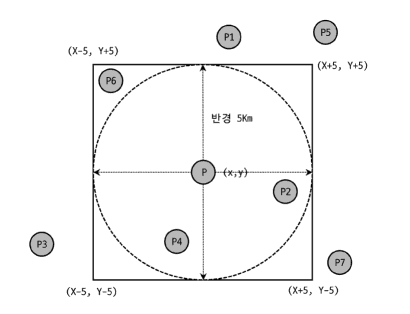
- 기준점(P)으로부터 반경 거리 5km 이내의 점(위치)들을 검색하려면?
- 우선 사각 점선의 상자에 포함되는 점들을 검색 하면 된다.
- 여기서
ST_Contains()나ST_Within()연산은 사각형 박스와 같은 다각형(Polygon)으로만 연 산할 수 있음- 반경 5km를 그리는 원을 포함하는 최소 사각형(MBR)으로 포함 관계 비교를 수행
ST_Contains()함수와ST_Within()함수는 거의 동일한 비교를 수행하지만 두 함수의 파라미터는 반대로 사용해야 함
8.5 전문 검색 인덱스#
문서 전체에 대한 분석과 검색을 위한 이러한 인덱싱 알고리즘을 전문 검색(Full Text search) 인덱스 라고 함
전문 검색 인덱스는 일반화된 기능의 명칭이지 전문 검색 알고리즘의 이름을 지칭하는 것은 아님
8.5.1 인덱스 알고리즘#
전문 검색에서는 문서 본문의 내용에서 사용자가 검색하게 될 키워드를 분석해 내고, 빠른 검색용으로 사용할 수 있게 키워드로 인덱스를 구축
8.5.1.1 어근 분석 알고리즘#
불용어 처리는 검색에서 별 가치가 없는 단어를 모두 필터링해서 제거하는 작업을 의미
- 불용어의 개수는 많지 않아 알고리즘을 구현한 코드에 모두 상수로 정의해 사용하는 경우가 많움
- 유연성을 위해 불용어 자체를 데이터베이스화해 사용자가 추가/삭제할 수 있게 구현현한 경우도 있음
- 어근 분석은 검색어로 선정된 단어의 뿌리인 원형을 찾는 작업
- MySQL 서버에서는 오픈소스 형태소 분석 라이브러리인 MeCab을 플러그인 형태로 사용할 수 있게 지원
- 하지만 MeCab이 제대로 작동하려면 단어 사전과 품사를 식별할 수 있는 구조 인식과정이 필요함
- 이 과정은 상당한 시간이 필요한 작업
- MeCab을 MySQL 서버에 적용하는 방법은 어렵지 않지만 한글에 맞게 완성도를 갖추는 작업은 많은 시간과 노력이 필요하다.
8.5.1.2 n-gram 알고리즘#
n-gram이란 본문을 무조건 몇 글자씩 잘라서 인덱싱하는 방법이다.
- 2-gram 방식으로 문장을 토큰화 한다면?
to be or not to be. That is the question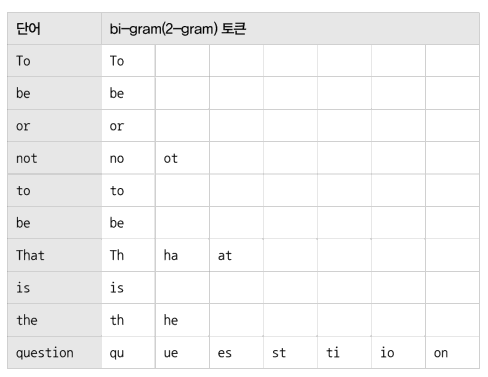
전문 검색을 더 빠르게 하기 위해 2단계 인덱싱과 같은 방법도 있지만 MySQL 서버는 이렇게 구분된 토큰을 단순한 B-Tree 인덱스에 저장
8.5.1.3 불용어 변경 및 삭제#
- 전문 검색 인덱스의 불용어 처리 무시
- 스토리지 엔진에 관계없이 MySQL 서버의 모든 전문 검색 인덱스에 대해 불용어를 완전히 제거
- MySQL 서버의 설정 파일(my.cnf)의 ft_stopword_file 시스템 변수에 빈 문자열을 설정
- InnoDB 스토리지 엔진을 사용하는 테이블의 전문 검색 인덱스에 대해서만 불용어 처리 무시
innodb_ft_enable_stopword시스템 변수를 OFF로 설정
- 사용자 정의 불용어 사전
- 사용자가 직접 정의한 불용어 사용 가능
- 불용어 목록을 파일로 저장하고, MySQL 서버 설정 파일에서 파일의 경로를
ft_stopword_file설정에 등록
- InnoDB 스토리지 엔진을 사용하는 테이블의 전문 검색 엔진에서 불용어의 목록을 테이블로 저장
- 불용어 테이블을 생성하고,
innodb_ft_ server_stopword_table시스템 변수에 불용어 테이블을 설정
8.5.2 전문 검색 인덱스의 가용성#
전문 검색 인덱스를 이용하기 위한 두 가지 조건
- 쿼리 문장이 전문 검색을 위한 문법(MATCH … AGAINST …)를 사용
- 테이블 전문 검색 대상 칼럼에 대해 전문 인덱스 보유
8.6 함수 기반 인덱스#
- 일반적인 인덱스는 칼럼의 값 일부(칼럼의 값 앞부분) 또는 전체에 대해서만 인덱스 생성이 허용
- 하지만 때로는 칼럼의 값을 변형해서 만들어진 값에 대해 인덱스를 구축해야 할 때도 있음
- 이러한 경우 함수 기반의 인덱스를 활용하면 됨
- MySQL 서버에서 함수 기반 인덱스를 구현하는 방법
- 가상 컬럼을 이용한 인덱스
- 함수를 이용한 인덱스
- 가상 칼럼이 VIRTUAL이나 STORED 옵션 중 어떤 옵션으로 생성됐든 관계없이 해당 가상 칼럼에 인덱스를 생성 가능
- 가상 칼럼은 테이블에 새로운 칼럼을 추가하는 것과 같은 효과를 내기 때문에 실제 테이블의 구조가 변경된다는 단점
8.6.2 함수를 이용한 인덱스#
- 가상 칼럼은 MySQL 5.7 버전에서도 사용할 수 있었지만 함수를 직접 인덱스 생성 구문에 사용할 수는 없었다.
- 함수를 직접 사용하는 인덱스는 테이블의 구조는 변경하지 않고, 계산된 결괏값에 검색을 빠르게 만들어 줌
mysql> CREATE TABLE user ( user_id BIGINT, first_name VARCHAR(10), last_name VARCHAR(10), PRIMARY KEY (user_id), INDEX ix_fullname ((CONCAT(first_name,' ',last_name))));- 함수 생성 시 명시된 표현식과 쿼리의 WHERE 조건절에 사용된 표현식이 다르다면 옵티마이저는 다른 표현식으로 간주해 함수 기반 인덱스 사용 불가
mysql> EXPLAIN SELECT * FROM user WHERE CONCAT(first_name, ' ', last_name) = 'Matt Lee';- ix_fullname 인덱스를 사용하지 않는것으로 표기된다면 CONCAT함수에 사용된 공백 문자 리터럴때문일 확률이 높음 3가지 시스템 변수를 동일 콜레이션으로 일치 시켜 다시 테스트
- collation_connection
- collation_database
- collation_server
8.7 멀티 밸류 인덱스#
- 전문 검색 인덱스를 제외한 모든 인덱스는 레코드 1건이 1개의 인덱스 키 값을 가진다
- 인덱스 키와 데이터 레코드는 1:1의 관계를 가진다.
- 멀티 밸류 인덱스는 하나의 데이터 레 코드가 여러 개의 키 값을 가질 수 있는 형태의 인덱스
- 일반적인 DBMS를 기준으로는 정규화에 위배되는 형태
- 최근 RDBMS들이
JSON데이터 타입을 지원하기 시작 하면서JSON의 배열 타입의 필드에 저장된 원소들에 대한 인덱스 요건이 발생한 것
mysql> CREATE TABLE user ( user_id BIGINT AUTO_INCREMENT PRIMARY KEY, first_name VARCHAR(10), last_name VARCHAR(10), credit_info JSON, INDEX mx_creditscores ( (CAST(credit_info->'$.credit_scores' AS UNSIGNED ARRAY))));
mysql> INSERT INTO user VALUES (1, 'Matt', 'Lee', '{"credit_scores":[360, 353, 351]}');- 멀티 밸류 인덱스를 사용하기 위해 아래 함수를 이용해 검색해야 함
- MEMBER OF()
- JSON_CONTAINS()
- JSON)OVERLAPS()
8.8 클러스터링 인덱스#
- 클러스터링이란 여러 개를 하나로 묶는다는 의미
- DB에서 클러스터링은 테이블의 레코드를 비슷한 것들끼리 묶어서 저장하는 형태로 구현
- 주로 비슷한 값들을 동시에 조회하는 경우가 많다는 점에 착안한 것
- MySQL에서 클러스터링 인덱스는 InnoDB 스토리지 엔진에서만 지원
8.8.1 클러스터링 인덱스#
- 클러스터링 인덱스는 테이블의 프라이머리 키에 대해서만 적용되는 내용
- 프라이머리 키 값이 비슷한 레코드 끼리 묶어서 저장하는 것을 클러스터링 인덱스라 함
- 중요한 것은 프라이머리 키 값에 의해 레코드의 저장 위치가 결정된다는 것
- 프라이머리 키가 변경되면 레코드의 물리적 저장 위치가 바뀌어야 함
- 프라이머리 키 값으로 클러스터링된 테이블은 프라이머리 키 값 자체에 대한 의존도가 큼
- 때문에 신중히 프라이머리 키 를 결정해야 함
- 클러스터링 인덱스는 프라이머리 키 값에 의해 레코드의 저장 위치가 결정 됨
- 사실 인덱스 알고리즘이라기보다 테이블 레코드의 저장 방식이라고 볼 수 있다.
- 클러스터링 인덱스 = 클러스터링 테이블 과 동의어로 사용됨
- 클러스터링의 기준이 되는 프라이머리 키는 클러스터링 키라고도 표현
- 일반적으로 InnoDB와 같이 항상 클러스터링 인덱스로 저장되는 테이블은 프라이머리 키 기반의 검색이 매우 빠름
- 대신 레코드의 저장이나 프라이머리 키의 변경이 상대적으로 느림
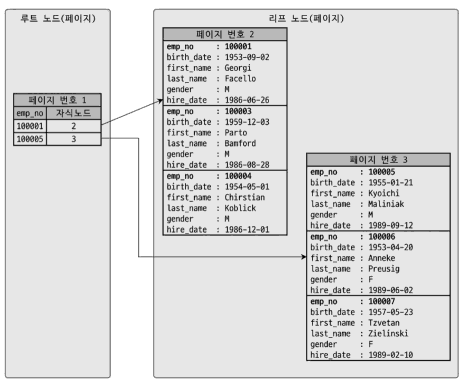
- 일반 B-Tree와 비슷하지만 B-Tree 리프 노드와 달리 클러스터링 인덱스의 리프 노드에는 레코드의 모든 칼럼이 같이 저장돼 있음을 알 수 있음
mysql> UPDATE tb_test SET emp_no=100002 WHERE emp_no=100007;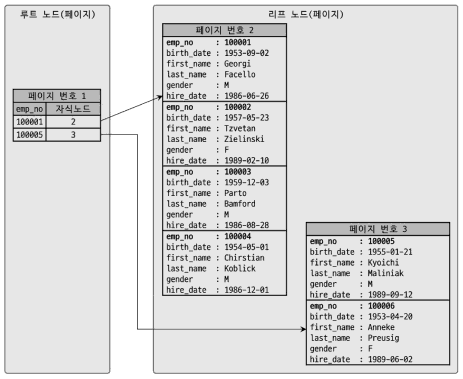
- 업데이트가 실행 된 후 데이터 구조
- 실제로 프라이머 리 키의 값이 변경되는 경우는 거의 없음
- MyISAM이나 기타 InnoDB를 제외한 테이블의 데이터 레코드는 프라이머리 키나 인덱스 키 값이 변경 된다 해서 실제 데이터 레코드의 위치가 변경되지는 않음
- 프라이머리 키가 없는 테이블의 경우 InnoDB 스토리지 엔진이 다음 우선순위대로 프라이머리 키를 대체할 칼럼을 선택 함
1. 프라이머리 키가 있으면 기본적으로 프라이머리 키를 클러스터링 키로 선택
2. NOT NULL 옵션의 유니크 인덱스 중에서 첫 번째 인덱스를 클러스터링 키로 선택
3. 자동으로 유니크한 값을 가지도록 증가되는 칼럼을 내부적으로 추가한 후, 클러스터링 키로 선택- InnoDB 엔진이 적절한 클러스터링 키 후보를 찾지 못하는 경우엔?
- InnoDB 스토리지 엔진이 내부적으로 레코드의 일련번호 칼럼을 생성
- 자동으로 추가된 프라이머리 키는 사용자에게 노출되지 않으며, 쿼리 문장에 명시적으로 사용할 수 없음
- 때문에 아무 의미 없는 숫자를 클러스터링 하는 것이며, 우리에게 아무런 혜택을 주지 못함
- InnoDB 테이블에서 클러스터링 인덱스는 테이블당 단 하나만 가질 수 있는 엄청난 혜택
- 가능하다면 프라이머리 키를 명시적으로 생성하자
8.8.2 세컨더리 인덱스에 미치는 영향#
- MyISAM/MEMORY 테이블 같은 클러스터링되지 않은 테이블은 INSERT될 때 처음 저장된 공간에서 절대 이동하지 않는다.
- 프라이머리 키나 세컨더리 인덱스의 각 키는 주소(ROWID)를 이용 해 실제 데이터 레코드를 찾아온다.
- 때문에 MyISAM/MEMORY 테이블에서는 프라이머리 키와 세컨더리 인덱스는 구조적으로 아무런 차이가 없다.
- InnoDB에서는 클러스터링 키 값이 변경될 때마다 데이터 레코드의 주소가 변경되고 그때마다 테이블의 모든 인덱스에 저장된 주솟값을 변경해야 한다.
- 이런 오버헤드를 제거하기 위해 InnoDB 테이블의 클러스터링 테이블은 모든 세컨더리 인덱 스는 해당 레코드가 저장된 주소가 아닌 프라이머리 키 값을 저장하도록 구현돼 있다.
MyISAM: ix_firstname 인덱스를 검색해서 레코드의 주소를 확인한 후, 레코드의 주소를 이용해 최종 레코드를 가져옴
InnoDB: ix_firstname 인덱스를 검색해 레코드의 프라이머리 키 값을 확인한 후, 프라이머리 키 인덱스를 검색해 서 최종 레코드를 가져옴- InnoDB가 MyISAM보다 조금 더 복잡하게 처리됨
- 하지만 InnoDB 테이블에서 프라이머리 키는 더 큰 장점을 제공하기 때문에 성능 저하에 대해 너무 걱정하지 않아도 된다.
8.8.3 클러스터링 인덱스의 장점과 단점#
장점#
- 프라이머리 키로 검색할 때 처리 성능이 매우 빠름
- 특히, 프라이머리 키를 범위 검색하는 경우 매우 빠름
- 테이블의 모든 세컨더리 인덱스가 프라이머리 키를 가지고 있기 때문에 인덱스만으로 처리될 수 있는 경우가 많음
- 이를 커버링 인덱스라고 함
단점#
- 테이블의 모든 세컨더리 인덱스가 클러스터링 키를 갖기 때문에 클러스터링 키 값의 크기가 클 경우 전체적으로 인덱스의 크기가 커짐
- 세컨더리 인덱스를 통해 검색할 때 프라이머리 키로 다시 한번 검색해야 하므로 처리 성능이 느림
- INSERT할 때 프라이머리 키에 의해 레코드의 저장 위치가 결정되기 때문에 처리 성능이 느림
- 프라이머리 키를 변경할 때 레코드를 DELETE하고 INSERT하는 작업이 필요하기 때문에 처리 성능이 느림
- 대부분 클러스터링 인덱스의 장점은 빠른 읽기이며, 단점은 느린 쓰기라는 것을 알 수 있다.
- 일반적으로 웹 서비스와 같은 온라인 트랜잭션 환경에서는 쓰기와 읽기의 비율이 2:8 또는 1:9 정도이기 때문에 조금 느린 쓰기를 감수하고 읽기를 빠르게 유지하는 것은 매우 중요
8.8.4 클러스터링 테이블 사용 시 주의사항#
8.8.4.1 클러스터링 인덱스 키의 크기#
- 클러스터링 테이블의 경우 모든 세컨더리 인덱스가 프라이머리 키 값을 포함
- 프라이머리 키의 크기가 커지면 세컨더리 인덱스도 자동으로 크기가 커짐
- 일반적으로 테이블에 세컨더리 인덱스가 4~5개 정도 생성된다는 것을 고려하면 세컨더리 인덱스 크기는 급격히 증가
- 인덱스가 커질수록 같은 성능을 내기 위해 그만큼의 메모리가 더 필요해지므로 InnoDB 테이블의 프라이머리 키는 신중하게 선택 해야 함
8.8.4.2 프라이머리 키는 AUTO-INCREMENT 보다는 업무적인 칼럼으로 생성#
- InnoDB의 프라이머리 키는 클러스터링 키로 사용되며, 이 값에 의해 레코드의 위치가 결정
- 프라이머리 키로 검색하는 경우 클러스터링되지 않은 테이블에 비해 매우 빠르게 처리될 수 있음을 의미
- 특히 범위로 많은 레코드를 검색하는 경우
- 설령 그 칼럼의 크기가 크더라도 업무적으로 해당 레코드를 대표할 수 있다면 그 칼럼을 프라이머리 키로 설정하는 것이 좋다.
8.8.4.3 프라이머리 키는 반드시 명시할 것#
- 가끔 프라이머리 키가 없는 테이블을 자주 보게 되는데, 가능하면 AUTO_INCREMENT 칼럼을 이용해서라도 프라이머리 키는 생성하는 것을 권장
- InnoDB 테이블에 프라이머리 키를 정의하지 않는 경우와 AUTO_INCREMENT 칼럼을 생성하고 프라이머리 키로 설정하는 것이 결국 똑같다. (InnoDB 내부적 생성)
- 그렇다면 사용자가 사용할 수 있는 값을 프라이머리 키로 설 정하는 것이 좋을 것
- ROW 기반의 복제나 InnoDB Cluster에서는 모든 테이블이 프라이머리 키를 가져야만 하는 정상적인 복제 성능을 보장하기도 하므로 프라이머리 키는 꼭 생성하자!
8.8.4.4 AUTO-INCREMENT 칼럼을 인조 식별자로 사용할 경우#
- 여러 개의 칼럼이 복합으로 프라이머리 키가 만들어지는 경우 프라이머리 키의 크기가 길어질 때가 있음
- 하지만 프라이머리 키의 크기가 길어도 세컨더리 인덱스가 필요치 않다면 그대로 프라이머리 키를 사용하는 것이 좋다.
- 세컨더리 인덱스도 필요하고 프라이머리 키의 크기도 길다면 AUTO-INCREMENT를 추가하고, 이를 프라이머리 키로 설정하면 됨
- 프라이머리 키를 대체하기 위해 인위적으로 추가된 프라이머리 키를 인조 식별자(Surrogate key)라고 함
- 로그 테이블과 같이 조회보다는 INSERT 위주의 테이블들은 AUTO_INCREMENT를 이용한 인조 식별자를 프라이머리 키로 설정하는 것이 성능 향상에 도움이 됨
8.9 유니크 인덱스#
- 유니크는 사실 인덱스라기보다는 제약 조건에 가깝다고 볼 수 있다.
- 말 그대로 테이블이나 인덱스에 같 은 값이 2개 이상 저장될 수 없음을 의미
- MySQL에서는 인덱스 없이 유니크 제약만 설정할 방법이 없다.
- 질문) 그럼 다른 DB는 있는건가? ⇒ 가능하더라도 굳이?
8.9.1 유니크 인덱스와 세컨더리 인덱스의 비교#
8.9.1.1 인덱스 읽기#
- 많은 사람이 유니크 인덱스가 빠르다고 생각한다. 하지만 이것은 사실이 아니다.
- 유니크하지 않은 세컨더리 인덱스에서 한 번 더 해야 하는 작업은 디스크 읽기가 아니라 CPU에서 칼럼값을 비교하는 작업이기 때문에 이는 성능상 영향이 거의 없다고 볼 수 있다.
- 유니크하지 않은 세컨더리 인덱스는 중복된 값이 허용되므로 읽어야 할 레코드가 많아서 느린 것이지, 인덱스 자체의 특성 때문에 느린 것이 아니라는 것이다.
- 하나의 값을 검색하는 경우, 유니크 인덱스와 일반 세컨더리 인덱스는 사용되는 실행 계획이 다르다.
- 하지만 이는 인덱스의 성격이 유니크한지 아닌지에 따른 차이일 뿐 큰 차이는 없다.
- 한 개의 레코드를 읽느냐 2개 이상의 레코드를 읽느냐의 차이만 있다는 것을 의미할 뿐, 읽어야 할 레코드 건수가 같다면 성능상 차이는 미미
8.9.1.2 인덱스 쓰기#
- 새로운 레코드가 INSERT되거나 인덱스 칼럼의 값이 변경되는 경우에는 인덱스 쓰기 작업이 필요
- 유니크 인덱스의 키 값을 쓸 때는 중복된 값을 체크하는 과정이 한 단계 더 필요
- 그래서 유니크하지 않은 세컨더리 인덱스의 쓰기보다 느리다.
- 중복된 값을 체크할 때는 읽기 잠금을 사용하고, 쓰기를 할 때는 쓰기 잠금을 사용하는데 이 과정에서 데드락이 아주 빈번히 발생한다.
- 유니크 인덱스는 반드시 중복 체크를 해야 하므로 작업 자체를 버퍼링하지 못한다. 이 때문에 유니크 인덱스는 일반 세컨더리 인덱스보다 변경 작업이 더 느리게 작동한다.
8.9.2 유니크 인덱스 사용 시 주의사항#
- 꼭 필요한 경우라면 유니크 인덱스를 생성하는 것은 당연하다.
- 하지만 더 성능이 좋아질 것으로 생각하고 불필요하게 유니크 인덱스를 생성하지는 않는 것이 좋다.
- 유니크 인덱스도 일반 세컨더리 인덱스와 같은 역할을 동일하게 수행할 수 있으므로 세컨더리 인덱스를 중복으로 만들어 줄 필요는 없다.
- 가끔 똑같은 칼럼에 대해 프라이머리 키와 유니크 인덱스를 동일하게 생성한 경우도 있는데, 이 또한 불필요한 중복이므로 주의하자.
결론적으로 유일성이 꼭 보장돼야 하는 칼럼에 대해서는 유니크 인덱스를 생성하되, 꼭 필요하지 않다면 유니크 인덱스보다는 유니크하지 않은 세컨더리 인덱스를 생성하는 방법도 한 번씩 고려
8.10 외래키#
- MySQL에서 외래키는 InnoDB 스토리지 엔진에서만 생성할 수 있으며, 외래키 제약이 설정되면 자동 으로 연관되는 테이블의 칼럼에 인덱스까지 생성
- 외래키가 제거되지 않은 상태에서는 자동으로 생성된 인덱스를 삭제할 수 없다.
- InnoDB의 왜래키 관리에는 중요한 두 가지 특징이 있음
- 테이블의 변경(쓰기 잠금)이 발생하는 경우에만 잠금 경합(잠금 대기)이 발생
- 외래키와 연관되지 않은 칼럼의 변경은 최대한 잠금 경합(잠금 대기)을 발생시키지 않음
- 데이터베이스에서 외래 키를 물리적으로 생성하려면 이러한 현상으로 인한 잠금 경합까지 고려해 모델 링을 진행하는 것이 좋다.
mysql> CREATE TABLE tb_parent ( id INT NOT NULL, fd VARCHAR(100) NOT NULL, PRIMARY KEY (id) ) ENGINE=InnoDB;
mysql> CREATE TABLE tb_child ( id INT NOT NULL, pid INT DEFAULT NULL, fd VARCHAR(100) DEFAULT NULL, PRIMARY KEY (id), KEY ix_parentid (pid), CONSTRAINT child_ibfk_1 FOREIGN KEY (pid) REFERENCES tb_parent (id) ON DELETE CASCADE ) ENGINE=InnoDB;
mysql> INSERT INTO tb_parent VALUES (1, 'parent-1'), (2, 'parent-2');
mysql> INSERT INTO tb_child VALUES (100, 1, 'child-100');
8.10.1 자식 테이블의 변경이 대기하는 경우#
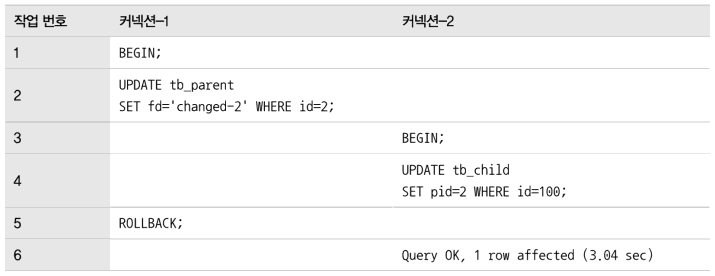
- 자식 테이블의 외래 키 칼럼의 변경은 부모 테이블의 확인이 필요
- 이 상태에서 부모 테이블의 해당 레코드가 쓰기 잠금이 걸려 있으면 해당 쓰기 잠금이 해제될 때까지 기다리게 되는 것
- 자식 테이블의 외래키(pid)가 아닌 칼럼의 변경은 외래키로 인한 잠금 확장이 발생하지 않는다.
8.10.2 부모 테이블의 변경 작업이 대기하는 경우#
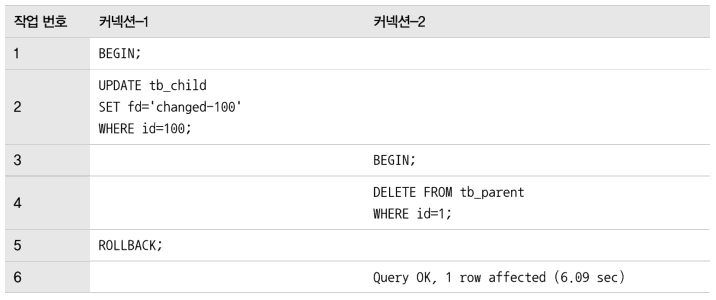
- 첫 번째 커넥션에서 부모 키 1을 참조하는 자식 테이블의 레코드를 변경하면 tb_child 테이블의 레코드에 대해 쓰기 잠금을 획득
- 이 상태에서 2번 커넥션이 tb_parent 테이블에서 id가 1인 레코드를 삭제하는 경우
- 이 쿼리(작업번호 4번) 는 tb_child 테이블의 레코드에 대한 쓰기 잠금이 해제될 때까지 기다려야 함
- 이는 자식 테이블이 생성될 때 정의된 외래키 특성 때문에 부모 레코드가 삭제되면 자식 레코드도 동식에 삭제되는 식으로 작동하기 때문