9장 - 옵티마이저와 힌트
- Created
- 2022년 9월 3일 PM 8:34
MySQL에서 쿼리를 최적으로 실행하기 위해 각 테이블의 데이터가 어떤 분포로 저장돼 있는지 통계 정보를 참조하며, 그러한 기본 데이터를 비교해 최적의 실행 계획을 수립하는 작업이 필요하다.
MySQL 서버를 포함한 대부분의 DBMS에서는 옵티마이저가 이러한 기능을 담당한다.
9.1 개요#
- 어떤 DBMS든지 쿼리의 실행 계획을 수립하는 옵티마이저는 가장 복잡한 부분으로 알려져 있으며, 옵티마이저가 만들어 내는 실행 계획을 이해하는 것 또한 상당히 어려운 부분
- 하지만 실행 계획을 이해할 수 있어야만 실행 계획의 불합리한 부분을 찾아내고, 더 최적화된 방법으로 실행 계획을 수립하도록 유도할 수 있다.
9.1.1 쿼리 실행 절차#
- MySQL 서버에서 쿼리가 실행되는 과정은 크게 세 단계로 나눌 수 있음
- 사용자로부터 요청된 SQL 문장을 잘게 쪼개서 MySQL 서버가 이해할 수 있는 수준으로 분리(파스 트리)한다.
- SQL의 파싱 정보(파스 트리)를 확인하면서 어떤 테이블부터 읽고 어떤 인덱스를 이용해 테이블을 읽을지 선택한다.
- 두 번째 단계에서 결정된 테이블의 읽기 순서나 선택된 인덱스를 이용해 스토리지 엔진으로부터 데이터를 가져온다.
- 첫 단계를
SQL 파싱이라 하며, MySQL 서버의SQL 파서라는 모듈로 처리한다.- SQL 문장이 문법적으로 잘못됐다면 이 단계에서 걸러진다.
- 이 단계에서
SQL 파스 트리가 만들어진다.
- 두 번째 단계는 첫 번째 단계에서 만들어진
SQL 파스 트리를 참조하면서 아래 같은 내용을 처리- 불필요한 조건 제거 및 복잡한 연산의 단순화
- 여러 테이블의 조인이 있는 경우 어떤 순서로 테이블을 읽을지 결정
- 각 테이블에 사용된 조건과 인덱스 통계 정보를 이용해 사용할 인덱스를 결정
- 가져온 레코드들을 임시 테이블에 넣고 다시 한번 가공해야 하는지 결정
- 두 번째 단계가 완료되면 실행 계획이 만들어짐
- 세 번째 단계는 수립된 실행 계획대로 스토리지 엔진에 레코드를 읽어오도록 요청하고, 스토리지 엔진으로부터 받은 레코드를 조인하거나 정렬하는 작업을 수행한다.
- 세 번째 단계는 MySQL엔진과 스토리지 엔진이 동시에 참여한다.
9.1.2 옵티마이저의 종류#
- 옵티마이저는 데이터베이스 서버에서 두뇌와 같은 역할을 담당으로 크게 2가지로 나눌 수 있음
- 옵티마이저는 현재 대부분의 DBMS가 선택하고 있는 비용 기반 최적화(Cost-based optimizer, CBO)
- 비용 기반 최적화는 쿼리를 처리하기 위한 여러 가지 가능한 방법을 만들고, 각 단위 작업의 비용(부하) 정보와 대상 테이블의 예측된 통계 정보를 이용해 실행 계획별 비용을 산출
- 이렇게 산출된 실행 방법별로 비용이 최소로 소 요되는 처리 방식을 선택해 최종적으로 쿼리를 실행
- 예전 초기 버전의 오라클 DBMS에서 많이 사용했던 규칙 기반 최적화 방법(Rule-based optimizer, RBO)
- 규칙 기반 최적화는 기본적으로 대상 테이블의 레코드 건수나 선택도 등을 고려하지 않고 옵티마이저에 내장된 우 선순위에 따라 실행 계획을 수립하는 방식을 의미
- 이 방식에서는 통계 정보를 조사하지 않고 실행 계획이 수립되기 때문에 같은 쿼리에 대해서는 거의 항상 같은 실행 방법을 만들 어냄
- 하지만 사용자의 데이터는 분포도가 매우 다양하기 때문에 규칙 기반의 최적화는 이미 오래전부터 많은 DBMS에서 거의 사용되지 않음
- 규칙 기반의 경우 상대적으로 느린 CPU 연산 탓에 비용 계산 과정이 부담스럽다는 이유로 사용되던 최적화 방법
9.2 기본 데이터 처리#
- MySQL 서버를 포함한 모든 RDBMS는 데이터를 정렬하거나 그루핑하는 등의 기본 데이터 가공 기능을 가지고 있다.
- 결과물은 동일하더라도 RDBMS별로 그 결과를 만들어 내는 과정은 천차만별이다.
9.2.1 풀 테이블 스캔과 풀 인덱스 스캔#
- 풀 테이블 스캔은 인덱스를 사용하지 않고 테이블의 데이터를 처음부터 끝까지 읽어서 요청된 작업을 처리하는 작업을 의미한다.
- MySQL 옵티마이저는 다음과 같은 조건이 일치할 때 주로 풀 테이블 스캔을 선택한다.
- 테이블의 레코드 건수가 너무 작아서 인덱스를 통해 읽는 것보다 풀 테이블 스캔을 하는 편이 더 빠른 경우
- WHERE 절이나 ON 절에 인덱스를 이용할 수 있는 적절한 조건이 없는 경우
- 인덱스 레인지 스캔을 사용할 수 있는 쿼리라고 하더라도 옵티마이저가 판단한 조건 일치 레코드 건수가 너무 많은 경우
- 일반적으로 테이블의 전체 크기는 인덱스보다 훨씬 크기 때문에 테이블을 처음부터 끝까지 읽는 작업은 상당히 많은 디스크 읽기가 필요
- 대부분 DBMS는 풀 테이블 스캔을 실행할 때 한꺼번에 여러 개의 블록이나 페이지를 읽어오는 기능을 내장하고 있다.
- 하지만 MySQL에는 풀 테이블 스캔을 실행할 때 한꺼번에 몇 개씩 페이지를 읽어올지 설정하는 시스템 변수는 없다.
- 때문에 많은 사람들이 MySQL은 풀 테이블 스캔을 실행할 때 디스크로부터 페이지를 하나씩 읽어 오는 것으로 생각한다.
- MyISAM 일때는 맞는 이야기지만 InnoDB에서는 틀린 말이다.
- InnoDB 스토리지 엔진은 특정 테이블의 연속된 데이터 페이지가 읽히면 백그라운드 스레드에 의해 리드 어헤드 작업이 자동으로 시작됨
- 리드 어헤드란 어떤 영역의 데이터가 앞으로 필요해지리라는 것을 예측해 요청이 오기 전 미리 디스크에서 읽어 InnoDB의 버퍼 풀에 가져다 두는 것을 의미
- 풀 테이블 스캔이 실행되면 처음 몇 개의 데이터 페이지는 포그라운드 스레드가 페이지 읽기를 실행하지만 특정 시점부터는 읽기 작업을 백드라운드 스레드로 넘긴다.
- 백그라운드 스레드가 읽기를 넘겨받는 시점부터는 한 번에 4개 또는 8개씩의 페이지를 읽으면서 계속 그 수를 증가시킨다.
- 이때 한 번에 최대 64개의 데이터 페이지까지 읽어서 버퍼 풀에 저장해 둔다.
- 포그라운드 스레드는 미리 버퍼 풀에 준비된 데이터를 가져다 사용하기만 하면되므로 쿼리 가 상당히 빨리 처리되는 것
- MySQL 서버에서는
innodb_read_ahead_threshold시스템 변수를 이용해 InnoDB 스토리지 엔진이 언제 리드 어헤드를 시작할지 임계값을 설정할 수 있다.- 이 옵션이 낮을 수록 더 빨리 리드 어헤드가 시작되게 유도할 수 있다.
- 리드 어헤드는 풀 테이블 스캔에서만 사용되는 것이 아니라 풀 인덱스 스캔에서도 동일하게 사용된다.
9.2.2 병렬 처리#
- MySQL 8.0 버전부터는 용도가 한정돼 있긴 하지만 처음으로 쿼리의 병렬 처리가 가능해졌다.
- 여기서 설명하는 병렬 처리는 하나의 쿼리를 여러 스레드가 작업을 나누어 동시에 처리한다는 것을 의미
- MySQL 8.0에서는
innodb_parallel_read_threads라는 시스템 변수를 이용해 하나의 쿼리를 최대 몇 개의 스레드를 이용해서 처리할지를 변경할 수 있다.- 아직 MySQL 서버에서는 쿼리를 여러 개의 스레드 를 이용해 병렬로 처리하게 하는 힌트나 옵션은 없다.
- 병렬 처리용 스레드 개수를 아무리 늘리더라도 서버에 장착된 CPU의 코어 개수를 넘어서는 경우에는 오히려 성능이 떨어질 수도 있으니 주의
9.2.3 ORDER BY 처리 (Using filesort)#
- 레코드 1~2건을 가져오는 쿼리를 제외하면 대부분의 SELECT 쿼리에서 정렬은 필수적으로 사용된다.
- 정렬을 처리하는 방법은 인덱스를 이용하는 방법과 쿼리가 실행될 때 Filesort라는 별도의 처리를 이용하는 방법으로 나눌 수 있다.
| 장점 | 단점 | |
| 인덱스 이용 | - INSERT, UPDATE, DELETE 쿼리가 실행될 때 이미 인 덱스가 정렬돼 있어서 순서대로 읽기만 하면 되므로 매 우 빠르다. | - INSERT, UPDATE, DELETE 작업 시 부가적인 인덱 스 추가/삭제 작업이 필요하므로 느리다. - 인덱스 때문에 디스크 공간이 더 많이 필요하다. - 인덱스의 개수가 늘어날수록 InnoDB의 버퍼 풀을 인덱스 이용 위한 메모리가 많이 필요하다. |
| Filesort 이용 | - 인덱스를 생성하지 않아도 되므로 인덱스를 이용할 때 Filesort 이용 의 단점이 장점으로 바뀐다. - 정렬해야 할 레코드가 많지 않으면 메모리에서 Filesort 가 처리되므로 충분히 빠르다. | - 정렬 작업이 쿼리 실행 시 처리되므로 레코드 대상 건수가 많아질수록 쿼리의 응답 속도가 느리다. |
- 물론 레코드를 정렬하기 위해 항상 Filesort라는 정렬 작업을 거쳐야 하는 것은 아니다.
- 하지만 다음과 같은 이유로 모든 정렬을 인덱스를 이용하도록 튜닝하기란 거의 불가능하다.
- 정렬 기준이 너무 많아서 요건별로 모두 인덱스를 생성하는 것이 불가능한 경우
- GROUP BY의 결과 또는 DISTINCT 같은 처리의 결과를 정렬해야 하는 경우
- UNION의 결과와 같이 임시 테이블의 결과를 다시 정렬해야 하는 경우
- 랜덤하게 결과 레코드를 가져와야 하는 경우
- MySQL 서버에서 인덱스를 이용하지 않고 별도의 정렬 처리를 수행했는지는 실행 계획의 Extra 칼럼에
Using filesort메시지가 표시되는지 여부로 판단할 수 있다.
9.2.3.1 소트 버퍼#
- MySQL은 정렬을 수행하기 위해 별도의 메모리 공간을 할당받아서 사용하는데, 이 메모리 공간을 소트 버퍼(Sort buffer)라고 한다.
- 소트 버퍼를 위한 메모리 공간은 쿼리의 실행이 완료되면 즉시 시스템으로 반납된다.
- 정렬해야 할 레코드가 아주 소량이어서 메모리에 할당된 소트 버퍼만으로 정렬할 수 있다면 아주 빠르게 정렬이 처리될 것
- 하지만 정렬해야 할 레코드의 건수가 소트 버퍼로 할당된 공간보다 크다면 어떨까?
- 이때 MySQL은 정렬해야 할 레코드를 여러 조각으로 나눠서 처리하는데, 이 과정에서 임시 저장을 위해 디스크를 사용
- 메모리의 소트 버퍼에서 정렬을 수행하고, 그 결과를 임시로 디스크에 기록해 둔다.
- 다음 레코드를 가져와서 다시 정렬해서 반복적으로 디스크에 임시 저장한다.
- 각 버퍼 크기만큼 정렬된 레 코드를 다시 병합하면서 정렬을 수행해야 한다.
- 이 병합 작업을 멀티 머지라고 표현한다.
- 이 작업들이 모두 디스크의 쓰기와 읽기를 유발하며, 레코드 건수가 많을수록 이 반복 작업의 횟수가 많아진다.
- 소트 버퍼를 크게 설정하면 디스크를 사용하지 않아서 더 빨라질 것으로 생각할 수도 있지만
- 실제 벤치마크 결과로는 큰 차이를 보이진 않았다.
sort_buffer_size시스템 변수의 설정값이 무조건 크면 메모리에서 모두 처리되니 빨라질 것으로 예상 하지만 실제 결과는 그렇지 않다.- 리눅스 계열의 운영체제에서는 너무 큰
sort_buffer_size를 사용하는 경우, 큰 메모리 공간 할당 때문에 성능이 훨씬 떨어질 수도 있다.
- 정렬을 위해 할당하는 소트 버퍼는 세션 메 모리 영역에 해당한다.
- 즉, 소트 버퍼는 여러 클라이언트가 공유해서 사용할 수 있는 영역이 아니다.
- 커넥션이 많으면 많을수록, 정렬 작업이 많으면 많을수록 소트 버퍼로 소비되는 메모리 공간이 커짐을 의미
9.2.3.2 정렬 알고리즘#
레코드를 정렬할 때 레코드 전체를 소트 버퍼에 담을지 또는 정렬 기준 칼럼만 소트 버퍼에 담을지에 따라 싱글 패스(Single-pass)/투 패스(Two-pass) 2가지 정렬 모드로 나눌 수 있다.
- MySQL 서버의 정렬 방식 3가지
<sort_key, rowid>: 정렬 키와 레코드의 로우 아이디(Row ID)만 가져와서 정렬하는 방식<sort_key, additional_fields>: 정렬 키와 레코드 전체를 가져와서 정렬하는 방식으로, 레코드의 칼럼들은 고정 사이즈로 메모리 저장<sort_key, packed_additional_fields>: 정렬 키와 레코드 전체를 가져와서 정렬하는 방식으로, 레코드의 칼럼 들은 가변 사이즈로 메모리 저장
9.2.3.2.1 싱글 패스#
<sort_key, additional_fields>, <sort_key, packed_additional_fields> 에 해당
SELECT emp_no, first_name, last_name FROM employees ORDER BY first_name;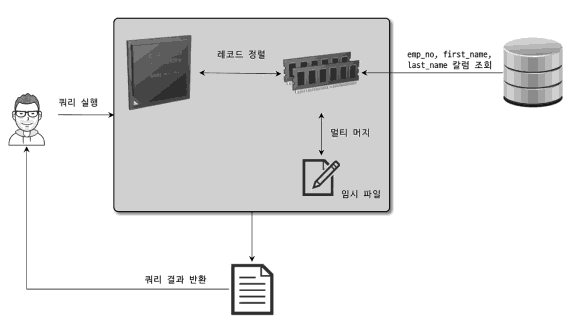
- 소트 버퍼에 정렬 기준 칼럼을 포함해 SELECT 대상이 되는 칼럼 전부를 담아서 정렬을 수행하는 정렬 방식
- 처음 employees 테이블을 읽을 때 정렬에 필요하지 않은 last_name 칼럼까 지 전부 읽어서 소트 버퍼에 담고 정렬을 수행한다.
- 정렬이 완료되면 정렬 버퍼의 내용을 그대 로 클라이언트로 넘겨준다.
9.2.3.2.3 투 패스#
<sort_key, rowid> 에 해당
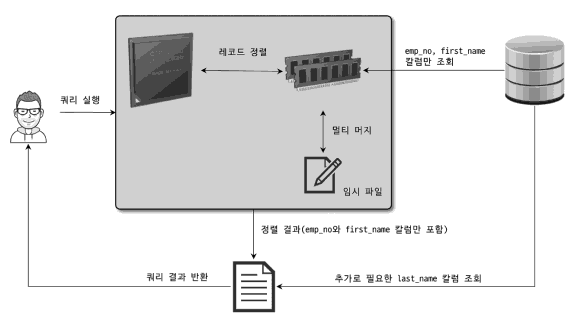
- 정렬 대상 칼럼과 프라이머리 키 값만 소트 버퍼에 담아서 정렬을 수행하고, 정렬된 순서대로 다시 프라이머리 키로 테이블을 읽어서 SELECT할 칼럼을 가져오는 정렬 방식
- 싱글 패스 이전부터 존재하던 방식
- MySQL 8.0에서도 특정 조건에서는 투 패스 정렬 방식을 사용
- 처음
employees테이블을 읽을 때는 정렬에 필요한first_name칼럼과 프라이머리 키인emp_no만 읽 어서 정렬을 수행 - 정렬이 완료되면 그 결과 순서대로
employees테이블을 한 번 더 읽어서last_name을 가져오고, 최종적으로 그 결과를 클라이언트 쪽으로 넘기는 과정을 확인할 수 있다. - 투 패스 방식은 테이블을 두 번 읽어야 하기 때문에 상당히 불합리하지만, 새로운 정렬 방식인 싱글 패스는 이러한 불합리가 없다.
- 싱글 패스 정렬 방식은 더 많은 소트 버퍼 공간이 필요
- 다음 조건의 경우 싱글 패스가 아닌 투 패스 정렬 방식을 사용함
- 레코드의 크기가 max_length_for_sort_data 시스템 변수에 설정된 값보다 클 때
- BLOB나 TEXT 타입의 컬럼을 SELECT 대상에 포함할 때
9.2.3.3 정렬 처리 방법#
- 쿼리에 ORDER BY가 사용되면 3가지 처리 방법 중 하나로 정렬되고 아래로 갈수록 처리 속도가 떨어진다.
- 인덱스를 사용한 정렬
- 조인에서 드라이밍 테이블만 정렬
- 조인에서 조인 결과를 임시 테이블로 저장 후 정렬
- 먼저 옵티마이저는 정렬 처리를 위해 인덱스를 이용할 수 있을지 검토할 것
- 인덱스를 이용할 수 있다면 별도의 Filesort 과정 없이 인덱스를 순서대로 읽어서 결과를 반환
- 하지만 인덱스를 사용할 수 없다면 WHERE 조건에 일치하는 레코드를 검색해 정렬 버퍼에 저장하면서 정렬을 처리(Filesort)할 것
- 옵티마이저는 정렬 대상 레코드를 최소화하기 위해 2가지 방법 중 하나를 선택한다.
- 조인의 드라이빙 테이블만 정렬 한 다음 조인을 수행
- 조인이 끝나고 일치하는 레코드를 모두 가져온 후 정렬을 수행
9.2.3.3.1 인덱스를 이용한 정렬#
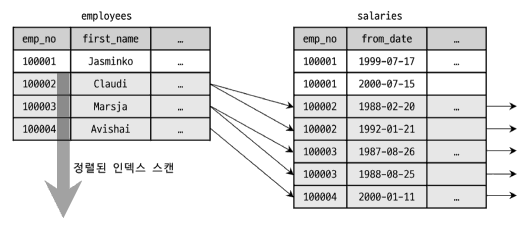
- 인덱스를 이용한 정렬을 위해서는 반드시 ORDER BY에 명시된 칼럼이 제일 먼저 읽는 테이블에 속하고, ORDER BY의 순서대로 생성된 인덱스가 있어야 한다.
- 또한 WHERE 절에 첫 번째로 읽는 테이블의 칼럼에 대한 조건이 있다면 그 조건과 ORDER BY는 같은 인덱스를 사용할 수 있어야 한다.
- 인덱스를 이용해 정렬이 처리되는 경우에는 실제 인덱스의 값이 정렬돼 있기 때문에 인덱스의 순서대 로 읽기만 하면 된다.
- 실제로 MySQL 엔진에서 별도의 정렬을 위한 추가 작업을 수행하지는 않는다
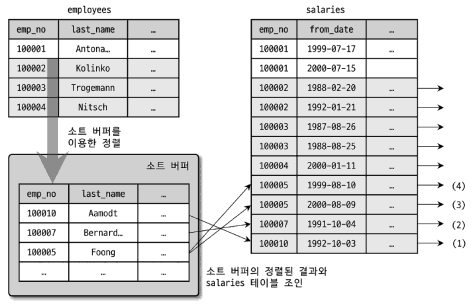
9.2.3.3.2 조인의 드라이빙 테이블만 정렬#
- 일반적으로 조인이 수행되면 결과 레코드의 건수가 몇 배로 불어나고, 레코드 하나하나의 크기도 늘어 난다.
- 그래서 조인을 실행하기 전에 첫 번째 테이블의 레코드를 먼저 정렬한 다음 조인을 실행하는 것 이 정렬의 차선책이 될 것이다.
- 이 방법으로 정렬이 처리되려면 조인에서 첫 번째로 읽히는 테이블(드 라이빙 테이블)의 칼럼만으로 ORDER BY 절을 작성해야 한다.
- Where절이 다음 2가지 조건을 갖추고 있다면 드라이빙 테이블로 선택할 것이다.
- WHERE 절의 검색 조건(“emp_no BETWEEN 100001 AND 100010”)은 employees 테이블의 프라이머리 키를 이용해 검색하면 작업량을 줄일 수 있다.
- 드리븐 테이블(salaries)의 조인 칼럼인 emp_no 칼럼에 인덱스가 있다.
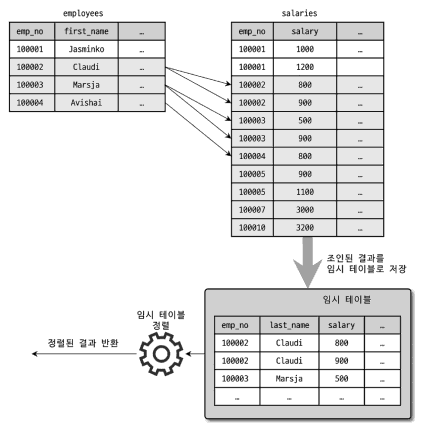
9.2.3.3.3 임시 테이블을 이용한 정렬#
- 쿼리가 여러 테이블을 조인하지 않고, 하나의 테이블로부터 SELECT해서 정렬하는 경우라면 임시 테이블이 필요하지 않다.
- 하지만 2개 이상의 테이블을 조인해서 그 결과를 정렬해야 한다면 임시 테이블이 필요할 수도 있다.
- 이 방법은 정렬의 3가지 방법 가운데 정렬해야 할 레코드 건수가 가장 많기 때문에 가장 느린 정렬 방법
9.2.3.3.4 정렬 처리 방법의 성능 비교#
주로 웹 서비스용 쿼리에서는 ORDER BY와 함께 LIMIT이 거의 필수로 사용되는 경향이 있다.
일반적으로 LIMIT은 테이블이나 처리 결과의 일부만 가져오기 때문에 MySQL 서버가 처리해야 할 작업량이 줄어드는 역할을 한다.
그런데 ORDER BY나 GROUP BY같은 작업은 WHERE 조건을 만족하는 레코드를 LIMIT 건수만큼만 가져와서 처리할 수 없다.
WHERE 조건을 아무리 잘 활용하도록 튜닝해도 잘못된 ORDER BY나 GROUP BY 때문에 느려지는 경우가 발생
9.2.3.3.4.1 스트리밍 방식#
서버 쪽에서 처리할 데이터가 얼마인지에 관계없이 조건에 일치하는 레코드가 검색될 때마다 바로바로 클라이언트로 전송해주는 방식
- 클라이언트는 쿼리를 요청하고 곧바로 원했던 첫 번째 레코드를 전달받음
- 가장 마지막 레코드는 언제 받을지 알 수 없지만, 이는 그다지 중요하지 않다.
- 스트리밍 방식으로 처리되는 쿼리는 쿼리가 얼마나 많은 레코드를 조회하느냐에 상관없이 빠른 응답 시간을 보장
9.2.3.3.4.2 버퍼링 방식#
ORDER BY나 GROUP BY 같은 처리는 쿼리의 결과가 스트리밍되는 것을 불가능하게 함
- 모들 레코드를가져온 후 그루핑 해야하기 때문
- 버퍼링 방식으로 처리되는 쿼리는 먼저 결과를 모아서 MySQL 서버에서 일괄 가공
- 모든 결과를 스토리지 엔진으로부터 가져올 때까지 기다려야 함
- 버퍼링 방식으로 처리되는 쿼리는 LIMIT처럼 결과 건수를 제한하는 조건이 있어도 성능 향상에 별로 도움이 되지 않는다.
- 네트워크로 전송되는 레코드의 건수를 줄일 수는 있지만 MySQL 서버가 해야 하는 작업량에는 그다지 변화가 없기 때문이다.
9.2.4 GROUP BY 처리#
- GROUP BY 또한 ORDER BY와 같이 쿼리가 스트리밍된 처리를 할 수 없게 하는 처리 중 하나
- HAVING 절은 GROUP BY 결과에 대해 필터링 역할을 수행한다.
- GROUP BY 작업도 인덱스를 사용하는 경우와 그렇지 못한 경우로 나눠 볼 수 있다.
- 인덱스를 이용할 때는 인덱스를 차례대로 읽는 인덱스 스캔 방법
- 인덱스를 건너뛰면서 읽는 루스 인덱스 스캔이라는 방법으로 나뉜다.
- 인덱스를 사용하지 못하는 쿼리에서 GROUP BY 작업은 임시 테이블을 사용한다.
9.2.4.1 인덱스 스캔을 이용하는 GROUP BY (타이트 인덱스 스캔)#
ORDER BY의 경우와 마찬가지로 조인의 드라이빙 테이블에 속한 칼럼만 이용해 그루핑할 때 GROUP BY 칼럼으로 이미 인덱스가 있다면 그 인덱스를 차례대로 읽으면서 그루핑 작업을 수행하고 그 결과로 조인을 처리한다.
- GROUP BY가 인덱스를 사용해서 처리된다 하더라도 그룹 함수 등의 그룹값을 처리해야 해서 임시 테이블이 필요할 때도 있다.
- GROUP BY가 인덱스를 통해 처리되는 쿼리 는 이미 정렬된 인덱스를 읽는 것이므로 쿼리 실행 시점에 추가적인 정렬 작업이나 내부 임시 테이블은 필요하지 않다.
- 실행 계획에서는 Extra 칼럼에 GROUP BY 코멘트
Using index for group-by나 임시테이블 사용 또는 정렬 관련 코멘트Using temporary. Using fiulesort가 표시되지 않는다.
9.2.4.2 루스 인덱스 스캔을 이용하는 GROUP BY#
루스인덱스 스캔 방식은 인덱스의 레코드를 건너뛰면서 필요한 부분만 읽어서 가져오는 것을 의미
Using index for group-by코멘트가 표시됨
EXPLAIN SELECT emp_no FROM salaries WHERE from_date=1958-03-01' GROUP BY emp_no;- salaries 테이블의 인덱스는 (emp_no, from_date)로 생성돼 있으므로 위의 쿼리 문장에서 WHERE 조건은 인덱스 레인지 스캔 접근 방식으로 이용할 수 없는 쿼리
- 하지만 실행 계획은 인덱스 레인지 스캔을 이용함
- 해당 쿼리의 실행 순서
- (emp_no, from_date) 인덱스를 차례대로 스캔하면서 emp_no의 첫 번째 유일한 값(그룹 키) "10001"을 찾아낸다.
- (emp_no, from_date) 인덱스에서 emp_no가 '10001'인 것 중에서 from_date 값이 '1985-03-01'인 레코드만 가져온다. 이 검색 방법은 1번 단계에서 알아낸 '10001' 값과 쿼리의 WHERE 절에 사용된 "from_date='1985-03- 01'" 조건을 합쳐서 "emp_no=10001 AND from_date='1985-03-01'" 조건으로 (emp_ no, from_date) 인덱스 를 검색하는 것과 거의 흡사하다.
- (emp_no, from_date) 인덱스에서 emp_no의 그다음 유니크한(그룹 키) 값을 가져온다.
- 3번 단계에서 결과가 더 없으면 처리를 종료하고, 결과가 있다면 2번 과정으로 돌아가서 반복 수행한다.
- MySQL의 루스 인덱스 스캔 방식은 단일 테이블에 대해 수행되는 GROUP BY 처리에 만 사용할 수 있다.
- 프리픽스(컬럼값의 앞쪽 일부만으로 생성된 인덱스) 인덱스는 루스 인덱스 스캔을 사용할 수 없다.
- 루스 인덱스 스캔은 분포도가 좋지 않은 인덱스일수록 더 빠른 결과를 만들어 낸다.
- 루스 인덱스 스캔은 임시 테이블이 필요하지 않다.
- 루스 인덱스 스캔이 사용될 수 있을지 없을지 판단하는 것은 WHERE 절의 조건이나 ORDER BY 절이 인덱스를 사용할 수 있을지 없을지 판단하는 것보다는 더 어렵다.
9.2.4.3 임시 테이블을 사용하는 GROUP BY#
GROUP BY의 기준 칼럼이 드라이빙 테이블에 있든 드리븐 테이블에 있든 관계없이 인덱스를 전혀 사용하지 못할 때는 이 방식으로 처리된다.
EXPLAIN SELECT e.last_name, ABG(s.salary) FROM employees e, salaries s WHERE s.emp_no=emp_no GROUP BY e.last_name;- MySQL 8.0 이전 버전까지는 GROUP BY가 사용된 쿼리는 그루핑되는 칼럼을 기준으로 묵시적인 정렬까지 함께 수행했다.
- MySQL 8.0 버전부터는 묵시적인 정렬은 더 이상 실행되지 않도록 바뀌었다.
- 하지만 MySQL8.0에서도 GROUP BY, ORDER BY 함께 사용시 정렬 작업을 실행
- GROUP BY가 필요한 경우 내부적으로 GROUP BY 절의 칼럼들로 구성된 유니크 인덱스를 가진 임시 테이블을 만들어 중복 제거와 집합 함수 연산을 수행
- 위의 쿼리를 처리하기 위해 같은 임시 테이블을 생성
- 그리고 조인의 결과를 한 건씩 가져와 임시 테이블에서 중복 체크를 하면서 INSERT 또는 UPDATE를 실행한다.
- 즉 별도의 정렬 작업 없이 GROUP BY가 처리된다.
9.2.5 DISTINCT 처리#
- 특정 칼럼의 유니크한 값만 조회하려면 SELECT 쿼리에 DISTINCT를 사용
- DISTINCT는 MIN(), MAX() 또는 COUNT() 같은 집합 함수와 함께 사용되는 경우와 집합 함수가 없는 경우의 2가지로 구분
- 구분한 이유는 각 경우에 DISTINCT 키워드가 영향을 미치는 범위가 달라지기 때문이다.
- 집합 함수와 같이 DISTINCT가 사용되는 쿼리의 실행 계획에서 DISTINCT 처리가 인덱스 사용하지 못할 시 항상 임시테이블이 필요
9.2.5.1 SELECT DISTINCT …#
- 단순히 SELECT되는 레코드 중 유니크한 레코드만 가져오고자 하면 SELECT DISTINCT 형태의 쿼리 문장을 사용
- 이 경우에는 GROUP BY와 동일한 방식으로 처리됨
- MySQL 8.0 버전부터는 GROUP BY를 수행하는 쿼리에 ORDER BY 절이 없으면 정렬을 사용하지 않기 때문에 다음의 두 쿼리는 내부적으로 같은 작업을 수행한다.
SELECT DISTINCT emp_no FROM salaries;
SELECT emp_no FROM salaries GROUP BY emp_no;- DISTINCT는 SELECT하는 레코드를 유니크하게 SELECT하는 것이지, 특정 칼럼만 유니크하게 조회하는 것이 아니다.
9.2.5.2 집합 함수와 함게 사용된 DISTINCT#
- COUNT(), MIN(), MAX() 같은 집합 함수 내에서 DISTINCT 키워드가 사용될 수 있는데, 이 경우에는 일반적으로 SELECT DISTINCT와 다른 형태로 해석된다.
- 집합 함수가 없는 SELECT 쿼리에서 DISTINCT는 조회 하는 모든 칼럼의 조합이 유니크한 것들만 가져온다.
- 하지만 집합 함수 내에서 사용된 DISTINCT는 그 집합 함수의 인자로 전달된 칼럼값이 유니크한 것들을 가져온다.
9.2.6 내부 임시 테이블 사용#
- MySQL 엔진이 스토리지 엔진으로부터 받아온 레코드를 정렬하거나 그루핑할 때는 내부적인 임시 테이블(Internal temporary table)을 사용한다.
- 내부적(Internal)이라는 단어가 포함된 이유는 여기서 이야기하는 임시 테이블은
CREATE TEMPORARY TABLE명령으로 만든 임시 테이블과는 다르기 때문 - 일반적으로 MySQL 엔진이 사용하는 임시 테이블은 처음에는 메모리에 생성됐다가 테이블의 크기가 커지면 디스크로 옮겨진다.
- 물론 특정 예외 케이스에는 메모리를 거치지 않고 바로 디스크에 임시 테이블이 만들어지기도 한다.
- MySQL 엔진이 내부적인 가공을 위해 생성하는 임시 테이블은 다른 세션이나 다른 쿼리에서는 볼 수 없으며 사용하는 것도 불가능
- 임시 테이블은 쿼리의 처리가 완료되면 자동으로 삭제 됨
9.2.6.1 메모리 임시 테이블과 디스크 임시 테이블#
- MySQL 8.0 이전 버전에서
- 메모리 임시 테이블의 경우 MEMORY 사용
- MEMORY 스토리지 엔진은 VARBINARY나 VARCHAR 같은 가변 길이 타입을 지원 X
- 때문에 임시 테이블이 메모리에 만들어지면 가변 길이 타입의 경우 최대 길이만큼 메모리를 할당해서 사용
- 이는 메모리 낭비가 심해지는 문제점을 안고 있었다.
- 디스크 임시 테이블의 경우 MyISAM 사용
- MyISAM 스토리지 엔진은 트랜잭션을 지원하지 못한다는 문제점을 안고 있었다
- MySQL 8.0 이후 버전부터
- 메모리 임시 테이블의 경우 TempTable 스토리지 엔진 사용
- 디스크 임시 테이블의 경우 InnoDB 스토리지 엔진 사용
- 임시 테이블의 크기가 1G보다 커지는 경우 MySQL 서버는 디스크에 기록하는데 2가지 저장방식 중 하나를 선택해야 함
- MMAP 파일로 디스크에 기록
- InnoDB 테이블로 기록
- 메모리의 TempTable을 MMAP 파일로 전환하는 것은 InnoDB 테이블로 전환하는 것보다 오버헤드가 적기 때문에 TempTable을 MMAP 파일로 전환하게 된다.
9.2.6.2 임시 테이블이 필요한 쿼리#
- ORDER BY와 GROUP BY에 명시된 칼럼이 다른 쿼리
- ORDER BY와 GROUP BY에 명시된 칼럼이 조인의 순서상 첫 번째 테이블이 아닌 경우
- DISTINCT와 ORDER BY가 동시에 쿼리에 존재하는 경우 또는 DISTINCT가 인덱스로 처리되지 못하는 쿼리
- UNION이나 UNION DISTINCT가 사용된 쿼리
- 쿼리의 실행 계획에서 select_type이 DERIVED인 쿼리 (파생된 쿼리)
9.2.6.3 임시 테이블이 디스크에 생성되는 경우#
내부 테이블은 기본적으로 메모리상에 만들어짐 하지만 다음 조건을 만족하면 디스크를 사용함
- UNION이나 UNION ALL에서 SELECT되는 칼럼 중 길이가 512바이트 이상인 크기의 칼럼이 있는 경우
- GROUP BY나 DISTINCT 칼럼에서 512바이트 이상인 크기의 칼럼이 있는 경우
- 메모리 임시 테이블 크기가 tmp_table_size, max_heap_table_size 시스템 변수보다 크거나 temptalbe_max_ram 시스템 변수 값보다 큰 경우
9.2.6.4 임시 테이블 관련 상태 변수#
실행 계획상 Using temporary가 표시되면 임시 테이블을 사용했다는 사실을 알 수 있음
9.3 고급 최적화#
- MySQL 서버의 옵티마이저가 실행 계획을 수립할 때 통계 정보와 옵티마이저 옵션을 결합해 최적의 실행 계획을 수립하게 됨
- 옵티마이저 옵션은 크게 조인 관련된 옵티마이저 옵션과 옵티마이저 스위치로 구분할 수 있음
- 조인 관련된 옵티마이저 옵션은 MySQL 초기 버전부터 제공되던 옵션이지만 많은 사람들이 그다지 신경쓰지 않음
- 하지만 조인이 많이 사용되는 서비스에서 알아야 하는 부분임
9.3.1 옵티마이저 스위치 옵션#
- 옵티마이저 스위치 옵션은 optimizer_switch 시스템 변수를 이용해 제어함
- optimizer_switch 시스템 변수에는 여러 옵션을 세트로 묶어서 설정하는 방식으로 사용함
| 옵티마이저 스위치 이름 | 기본값 | 설명 |
| batched_key_access | off | BKA 조인 알고리즘 사용 여부 설정 |
| block_nested_loop | on | Block Nested Loop 조인 알고리즘 사용 여부 설정 |
| engine_condition_pushdown | on | Engine Condition Pushdown 사용여부 설정 |
| index_condition_pushdown | on | Index Condition Pushdown 사용여부 설정 |
- 너무 길어서 생략…
9.3.1.1 MRR 배치 키 엑세스#
- MRR은
Multi-Range Read를 줄여서 부르는 이름- 매뉴얼에서는 DS-MRR(Disk Sweep Multi-Range Read)이라고도 함
- MySQL 서버에서 지금까지 지원하던 조인 방식은 드라이빙 테이블의 레코드를 한 건 읽어서 드리븐 테이블의 일치하는 레코드를 찾아서 조인을 수행하는 것이었다.
- 드라이빙 테이블 - 조인에서 제일 먼저 읽는 테이블
- 드리븐 테이블 - 조인되는 테이블에서 드라이빙이 아닌 테이블들
- 이를 네스티드 루프 조인(Nested Loop Join)이라고 함
- MySQL 서버의 내부 구조상 조인 처리는 MySQL 엔진이 처리
- 실제 레코드를 검색하고 읽는 부분은 스토리지 엔진이 담당
- 이때 드라이빙 테이블의 레코드 건별로 드리븐 테이블의 레코드를 찾으면 레코드를 찾고 읽는 스토리지 엔진에서는 아무런 최적화를 수행할 수가 없다
- 이 같은 단점을 보완하기 위해 조인 대상 테이블 중 하나로부터 레코드를 읽어 조인 버퍼에 버퍼링 한다.
- 즉 드라이밍 테이블의 레코드를 읽어서 드리븐 테이블과의 조인을 즉시 실행하지 않고 조인 대상을 버퍼링 하는 것
- 조인 버퍼에 레코드가 가득 차면 비로소 MySQL 엔진은 버퍼링된 레코드를 스토리지 엔진으로 한 번에 요청 함
- 이렇게 함으로써 스토리지 엔진은 읽어야 할 레코드들을 데이터 페이지에 정렬된 순서로 접근해 디스크의 데이터를 페이지 읽기를 최소화 할 수 있는 것
- 물론 데이터 페이지가 메모리에 있다고 하더라도 버퍼 풀의 접근을 최소화할 수 있는 것
- MRR을 이용해 실행되는 조인 방식을 BKA 조인이라 한다.
- BKA 조인 최적화는 기본적으로 비활성화돼 있음
- BKA 조인의 단점으로 부가적인 정렬 작업이 필요해지면서 오히려 성능에 안좋은 영향을 미치는 경우가 있음
9.3.1.2 블록 네스티드 루프 조인 (block_nested_loop)#
- MySQL 서버에서 사용되는 대부분의 조인은 네스티드 루프 조인
- 조인의 연결 조건이 되는 칼럼에 모두 인덱스가 있는 경우 사용도는 조인 방식
SELECT *
FROM employees e
INNER JOIN salaries s ON s.emp_no = e.emp_no
			AND s.from_date<=NOW()
			AND s.todate>=NOW()
WHERE e.forst_name='Amor';- 이러한 형태의 조인은 중첩된 반복 명령을 사용하는 것처럼 작동한다고 해서 네스티드 루프조인 이라고 한다.
for(row1 IN employees) {
		for(row2 IN slaries) {
				if (condition_matched) return (row1, row2);
		}
}- 네스티드 루프 조인과 블록 네스티드 루프 조인의 가장 큰 차이는 조인 버퍼가 사용되는지 여부와 조인에서 드라이빙 테이블과 드리븐 테이블이 어떤 순서로 조인되느냐 임
- 조인 알고리즘에서 Block이라는 단어가 사용되면 조인용으로 별도 버퍼가 사용됐다는 걸 의미
- 조인은 드라이빙 테이블에서 일치하는 레코드의 건수만큼 드리븐 테이블을 검색하며 처리됨
- 드라이밍 테이블은 한 번에 쭉 읽지만, 드리븐 테이블은 여러 번 읽는 것을 의미
- 드리븐 테이블을 사용할 때 인덱스를 사용할 수 없는 쿼리는 상당히 느려짐
- 옵티마이저는 퇴대한 드리븐 테이블의 검색이 인덱스를 사용할 수 있게 실행 계획을 수립함
- 그런데 어떤 방식으로도 드리븐 테이블의 풀 테이블 스캔이나 인덱스 풀 스캔을 피할 수 없다면 옵티마이저는 드라이빙 테이블에서 읽은 레코드를 메모리에 캐시한 후 드리븐 테이블과 이 메모리 캐시를 조인하는 형태로 처리
- 이때 사용되는 메모리의 캐시를 조인 버퍼(Join buffer)라고 한다.
- 조인이 완료되면 조인 버퍼는 바로 해제된다.
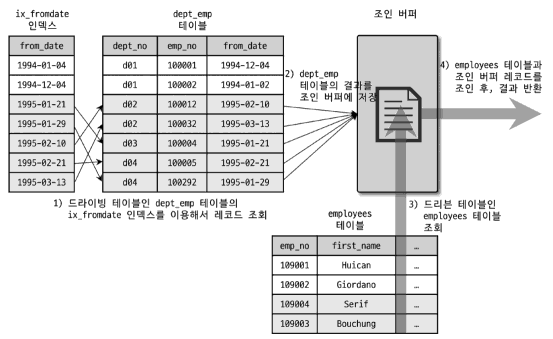
- 조인 버퍼가 어떻게 활용되는지 단계별로 확인
ept_emp테이블의ix_fromdate인덱스를 이용해(from_date>'1995-01-01') 조건을 만족하는 레코드를 검색한다.- 조인에 필요한 나머지 칼럼을 모두 dept_emp 테이블로부터 읽어서 조인 버퍼에 저장한다.
- employees 테이블의 프라이머리 키를 이용해 (emp_no<109004) 조건을 만족하는 레코드를 검색한다.
- 3번에서 검색된 결과(employees)에 2번의 캐시된 조인 버퍼의 레코드(dept_emp)를 결합해서 반환한다.
- MySQL 8.0.20 부터는 블록 네스티드 루프 조인은 더이상 사용되지 않고 해시 조인 알고리즘으로 대체되어 사용된다.
9.3.1.3 인덱스 컨티션 푸시다운#
- MySQL 5.6 버전부터는 인덱스 컨디션 푸시다운이라는 기능이 도입 됨
- 사실 인덱스 컨디션 푸시다운은 너무 비효율적이어서 이미 훨씬 오래전 부터 개선됐어야 할 기능이지만 이제서야 보완된 것
ALTER TABLE employees ADD INDEX ix_lastname_firstname (last_name, first_name);
SET optimizer_switch='index_condition_pushdown=off';
SHOW VARIABLES LIKE 'optimizer_switch' \G
Variable_name : optimizer_switch
Value : ..., index_confition_pushdown=off, ...SELECT * FROM employees WHERE last_name'Action' AND first_name LIKE '%sal';- 해당 쿼리의 실행계획 확인시
Extra컬럼에Using where가 표시된다. Using where는 InnoDB 스토리지 엔진이 읽어서 반환해준 레코드가 인덱스를 사용할 수 없는 WHERE 조건에 일치하는지 검사하는 과정을 의미
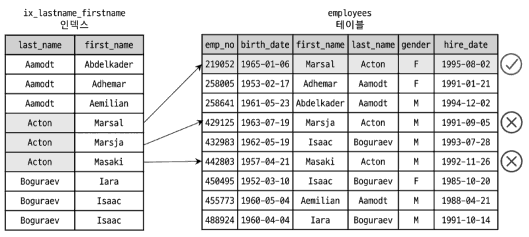
- 인덱스 컨디션 푸시다운이 동작하지 않을 경우
last_name='action'조건이 10만건이고 그 중first_name LIKE '%sal'의 레코드가 한건이라면?- 불필요한 99999건의 레코드를 읽고 작업하게 된다.
fisrt_name칼럼을 이용해 먼저 비교했다면 이런 불필요한 작업이 없었을 것이다.
- 사실
first_name LIKE '%sal'조건을 누가 처리하느냐에 따라 인덱스에 포함된first_name칼럼을 이용할지 또는 테이블의first_name칼럼을 이용할지가 결정 됨 - 인덱스를 비교하는 작업은 실제 InnoDB 스토리지 엔진이 수행하지만 테이블의 레코드에서
first_name조건을 비교하는 작업은 MySQL 엔진이 수행하는 작업
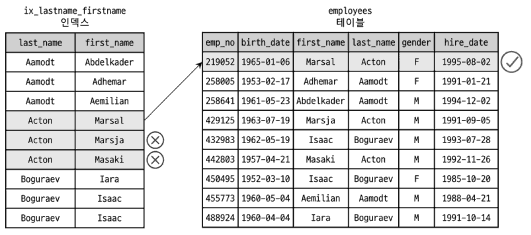
- MySQL 5.6 버전부터는 인덱스를 범위 제한 조건으로 사용하지 못한다고 하더라도 인덱스에 포함된 칼럼의 조건이 있다면 모두 같이 모아서 스토리지 엔진으로 전달할 수 있게 핸들러 API가 개선 됨
- 인덱스 컨디션 푸시다운 기능은 고도의 기술력을 필요로 하는 기능은 아니다.
- 하지만 쿼리의 성능 이 몇 배에서 몇십 배로 향상될 수도 있는 중요한 기능이다.
9.3.1.4 인덱스 확장#
use_index_extensions 옵티마이저 옵션은 InnoDB 스토리지 엔진을 사용하는 테이블에서 세컨더리 인 덱스에 자동으로 추가된 프라이머리 키를 활용할 수 있게 할지를 결정하는 옵션
mysql> CREATE TABLE dept_emp ( emp_no INT NOT NULL, dept_no CHAR(4) NOT NULL, from_date DATE NOT NULL, to_date DATE NOT NULL, PRIMARY KEY (dept_no,emp_no), KEY ix_fromdate (from_date) ) ENGINE=InnoDB;- 프라이머리 키는
dept_no, emp_no - 세컨더리 인덱스
ix_fromdate는from_ date- 그런데 세컨더리 인덱스는 데이터 레코드를 찾아가기 위해 프라이머리 키인 dept_no와 emp_no 칼럼을 순서대로(프라이머리 키에 명시된 순서) 포함한다.
- 최종적으로
ix_fromdate인덱스는from_date, dept_no, emp_no조합으로 인덱스를 생성한 것과 흡사하게 작동할 수 있게 된다. - 세컨더리 키에 자동으로 포함된 프라이머리 키
9.3.1.5 인덱스 머지#
- 인덱스를 이용해 쿼리를 실행하는 경우, 대부분 옵티마이저는 테이블별로 하나의 인덱스만 사용하도록 실행 계획을 수립
- 하지만 인덱스 머지 실행 계획을 사용하면 하나의 테이블에 대해 2개 이상의 인덱스를 이용해 쿼리를 처리
- 한 테이블에 대한 WHERE 조건이 여러 개 있더라도 하나의 인덱스에 포함된 칼럼에 대한 조건만으로 인덱스를 검색
- 나머지 조건은 읽어온 레코드에 대해서 체크하는 형태로만 사용되는 것이 일반적
- 하나의 인덱스만 사용해 충분히 작업범위를 줄일 수 있다면 하나의 인덱스만 활용하는 것이 일반적
- 쿼리에 사용된 각 각의 조건이 서로 다른 인덱스를 사용할 수 있고 그 조건을 만족하는 레코드 건수가 많을 것으로 예상 될 때 MySQL 서버는 인덱스 머지 실행 계획을 선택
- 인덱스 머지 실행 계획은 다음과 같이 3개의 세부 실행 계획으로 나누어 볼 수 있다.
- 3가지 최적화 모두 여러 개의 인덱스를 통해 결과를 가져온다는 것은 동일
- 하지만 각각의 결과를 어떤 방식으로 병합할 지에 따라 구분
- index_merge_intersection
- index_merge_sort_union
- index_merge_union
9.3.1.6 인덱스 머지 - 교집합(ndex_merge_intersection)#
mysql> EXPLAIN SELECT * FROM employees WHERE first_name='Georgi' AND emp_no BETWEEN 10000 AND 20000;- 실행 계획의 Extra 칼럼에 “Using intersect”라고 표시된 것은 이 쿼리가 여러 개 의 인덱스를 각각 검색해서 그 결과의 교집합만 반환했다는 것을 의미
9.3.1.7 인덱스 머지 - 합집합#
9.3.1.8 인덱스 머지 - 정렬 후 합집합#
9.3.1.9 세미조인#
다른 테이블과 실제 조인을 수행하지는 않고, 단지 다른 테이블에서 조건에 일치하는 레코드가 있는지 없는지만 체크하는 형태의 쿼리를 세미 조인(Semi-Join)이라고 한다.
9.3.1.10 테이블 풀-아웃#
- Table pullout 최적화는 세미 조인의 서브쿼리에 사용된 테이블을 아우터 쿼리로 끄집어낸 후에 쿼리를 조인 쿼리로 재작성하는 형태의 최적화다.
- 서브쿼리 최적화가 도입되기 이전에 수동으로 쿼리 를 튜닝하던 대표적인 방법이었다.
EXPLAIN
SELECT * FROM employees e
WHERE e.emp_no IN (SELECT de.emp_no FROM dept_emp de WHERE de.dept_no='d009');- 해당 쿼리의 실행 계획은 테이블별로 다음과 같음
dept_emp의 경우 인덱스를 이용employees의 경우 아무런 실행 계획이 나오지 않음
- Table pullout 최적화는 별도로 실행 계획에
Using table pullout문구가 출력되지 않는다.- 그래서 Table pullout 최적화가 사용됐는지는 실행 계획에서 해당 테이블들의 id 칼럼 값이 같은지 다른지를 비교해보는 것이 가장 간단한 방법
- 그러면서 Extra 칼럼에 아무것도 출력되지 않는 경우
- Table pullout 최적화가 사용됐는지 더 정확하게 확인하는 방법은 EXPLAIN 명령을 실행한 직후
- SHOW WARNINGS 명령으로 MySQL 옵티마이저가 재작성한 쿼리를 살 펴보는 것
- 이를 확인해보면 IN 쿼리 대신 JOIN으로 쿼리가 재작성 된것을 볼 수 있음
- Table pullout 최적화의 제약사항
- 세미 조인 서브쿼리에서만 사용 가능하다.
- 서브쿼리 부분이 UNIQUE 인덱스나 프라이머리 키 룩업으로 결과가 1건인 경우에만 사용 가능하다.
- Table pullout이 적용된다고 하더라도 기존 쿼리에서 가능했던 최적화 방법이 사용 불가능한 것은 아니므로 MySQL에서는 가능하다면 Table pullout 최적화를 최대한 적용한다.
- 서브쿼리의 테이블을 아우터 쿼리로 가져와서 조인으로 풀어쓰는 최적화를 수행하는데, 만약 서브쿼리의 모든 테이블이 아우터 쿼리로 끄집어 낼 수 있다면 서브쿼리 자체는 없어진다.
- MySQL에서는 “최대한 서브쿼리를 조인으로 풀어서 사용해라”라는 튜닝 가이드가 많은데, Table pullout 최적화는 사실 이 가이드를 그대로 실행하는 것이다. 이제부터는 서브쿼리를 조인으로 풀어서 사용할 필요가 없다.
9.3.1.11 퍼스트 매치#
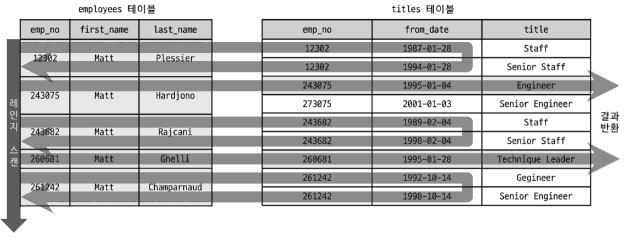
First Match 최적화 전략은 IN(subquery) 형태의 세미 조인을 EXISTS(subquery) 형태로 튜닝한 것과 비슷한 방법으로 실행된다.
EXPLAIN
SELECT * FROM employees e
WHERE e.first_name='Matt'
AND e.emp_no IN (
		SELECT t.emp_no
		FROM titles t
		WHERE t.from_date BETWEEN '1995-01-01' AND '1995-01-30'
);
- 해당 방법으로 실행계획 생성시 Extra 칼럼에
FristMatch(e)라는 문구가 출력된다.- 해당 문구는 검색 테이블의 레코드에 대해 서브쿼리 테이블에 일치하는 레코드 1건만 찾으면 더이상의 서브쿼리 테이블 검색을 하지 않는다는 것을 의미한다.
- 실제 의미론적으로는 EXISTS(subquery)와 동일하게 처리된 것이다.
- 하지만
FirstMatch는 서브쿼리가 아니라 조인으로 풀어서 실행하면서 일치하는 첫 번째 레코드만 검색하는 최적화를 실행한 것
- 검색 순서
- 먼저 employees 테이블에서 first_name 칼럼의 값이 ‘Matt’인 사원의 정보를 ix_firstname 인덱스를 이용 해 레인지 스캔으로 읽는다.
- first_name이 Matt으로 검색된 사원 번호를 이용해 titles테이블을 조인해 from_date가 t.from_ date BETWEEN '1995-01-01' AND '1995-01-30' 조건을 만족하는 레코드를 찾아봄
- 이때 일치하는 첫 번째 레코드를 찾는다면 해당 사원 번호에 대해 더 이상 titles 테이블을 검색하지 않고 즉시 레코드를 최종 결과로 반환
- IN-to-EXISTS 변환에 비해 FirstMatch 최적화의 장점
- 가끔은 여러 테이블이 조인되는 경우 원래 쿼리에는 없던 동등 조건을 옵티마이저가 자동으로 추가하는 형태의 최적화가 실행되기도 한다.
- IN-to-EXISTS 최적화에서는 이러한 동등 조건 전파가 서브쿼리 내에서만 가능했었음
- FirstMatch에서는 조인 형태로 처리되기 때문에 서브쿼리뿐만 아니라 아우터 쿼리의 테이블까지 전파 가능
- 최종적으로는 FirstMatch 최적화로 실행되면 더 많은 조건이 주어지는 것이므로 더 나 은 실행 계획을 수립 가능
- IN-to-EXISTS 변환 최적화 전략에서는 아무런 조건 없이 변환이 가능한 경우에는 무조건 그 최적화를 수행
- FirstMatch 최적화에서는 서브쿼리의 모든 테이블에 대해 FirstMatch 최적화를 수행할지 아니면 일부 테이블에 대해서만 수행할지 취사선택할 수 있다는 것이 장점
- FirstMatch 최적화의 제약사항
- 서브쿼리에서 하나의 레코드만 검색되면 더이상의 검색을 멈추는 단축 실행 경로이기 때문에 FirstMatch 최적화에서 서브쿼리는 그 서브쿼리가 참조하는 모든 아우터 테이블이 먼저 조회된 이후에 실행 됨
- 최적화가 사용되면 실행 계획의 Extra 칼럼에는 FirstMatch(table-N) 문구가 표시 됨
- 상관 서브쿼리(Correlated subquery)에서도 사용 가능
- GROUP BY나 집합 함수가 사용된 서브쿼리의 최적화에는 사용 불가
9.3.1.12 루스 스캔#
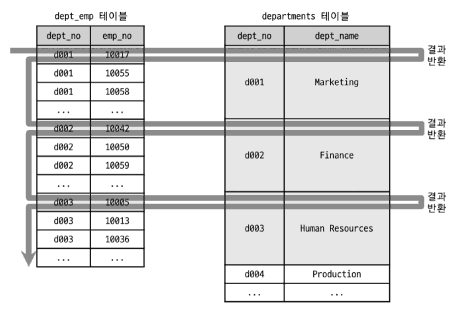
세미 조인 서브쿼리 최적화의 LooseScan은 인덱스를 사용하는 GROUP BY 최적화 방법에서 살펴본 루스 인덱스 스캔과 비슷한 읽기 방식을 사용
EXPLAIN
SELECT * FROM departments d
WHERE d.dept_no IN ( SELECT de.dept_no FROM dept_emp de );departments테이블의 레코드는 9건,dept_emp테이블의 레코드는 33만건인 경우dept_emp테이블의 프라이머리 키는dept_no, emp_no- 이 프라이머리 키는 전체 레코드 수는 33만 건 정도 있지만 dept_no 만으로 그루핑해서 보면 결국 9건밖에 없다는 것을 알 수 있다.
dept_emp테이블의 프라이머리 키를 루스 인덱스 스캔으로 유니크한dept_no만 읽으면 아주 효율적으로 서브쿼리 부분을 실행할 수 있다.- 그것도 중복된 레코드까지 제거하면서 말이다.
- 실행계획의 Extra 컬럼에는
LooseScan라는 문구로 표시됨 - 루스 스캔의 특성
- LooseScan 최적화는 루스 인덱스 스캔으로 서브쿼리 테이블을 읽고, 그다음으로 아우터 테이블을 드리븐으로 사 용해서 조인을 수행
- 서브쿼리 부분이 루스 인덱스 스캔을 사용할 수 있는 조건이 갖춰져야 사용할 수 있는 최적화다.
sql... WHERE expr IN (SELECT keypart1 FROM tab WHERE ...) ... WHERE expr IN (SELECT keypart2 FROM tab WHERE keypart1='상수' ...)루스 스캔을 사용할 수 있는 경우의 서브쿼리
9.3.1.13 구체화#
- Materialization 최적화는 세미 조인에 사용된 서브쿼리를 통째로 구체화해서 쿼리를 최적화한다는 의미다.
- 여기서 구체화(Materialization)는 쉽게 표현하면 내부 임시 테이블을 생성한다는 것을 의미한다.
EXPLAIN
SELECT * FROM employees e
WHERE e.emp_no IN (SELECT de.emp_no FROM dept_emp de WHERE de.from_date='1995-01-01');- 이 쿼리는 FirstMatch 최적화를 사용하면 employees 테이블에 대한 조건이 서브쿼리 이외에는 아무것도 없기 때문에 employees 테이블을 풀 스캔해야 할 것
- 그래서 이런 형태의 세미 조인에서는 First Match 최적화가 성능 향상에 도움이 되지 않음
- 때문에 이런 형태의 쿼리를 위해 서브쿼리 구체화라는 최적화를 되입함
- 실행계획의 Extra 컬럼에는
Materialization라고 표시됨 - 실행 순서
- dept_emp 테이블을 읽는 서브쿼리가 먼저 실행되어 짐
- 그 결과로 임시 테이블이 만들어짐
- 최종적으로 서브쿼리가 구체화된 임시 테이블과 employees 테이블을 조인해서 결과를 반환
- 구체화 전략은 다른 서브쿼리 최적화와 달리 서브쿼리 내에 GROUP BY절이 있어도 사용이 가능
- 구체화 최적화의 제한 사항과 특성
- IN(subquery)에서 서브쿼리는 상관 서브쿼리(Correlated subquery)가 아니어야 한다.
- 서브쿼리는 GROUP BY나 집합 함수들이 사용돼도 구체화를 사용할 수 있다.
- 구체화가 사용된 경우에는 내부 임시 테이블이 사용된다.
9.3.1.14 중복 제거#
Duplicate Weedout은 세미 조인 서브쿼리를 일반적인 INNER JOIN 쿼리로 바꿔서 실행하고 마지막에 중복된 레코드를 제거하는 방법으로 처리되는 최적화 알고리즘이다.
EXPLAIN
SELECT * FROM employees e
WHERE e.emp_no IN (SELECT s.emp_no FROM salaries s WHERE s.salary>150000);salaries테이블의 프라이머리 키는emp_no + from_datesalary가 150000 이상인 레코드를 salaries 테이블에서 조회하면 그 결과에는 중복된 emp_no가 발생- 이 쿼리를 아래과 같이 재작성해서 GROUP BY 절을 넣어 주면 위의 세미 조인 서브쿼리와 동일한 결과를 얻을 수 있다.
SELECT *
FROM employees e, salaries s
WHERE e.emp_no=s.emp_no AND s.salary>150000
GROUP BY e.emp_no;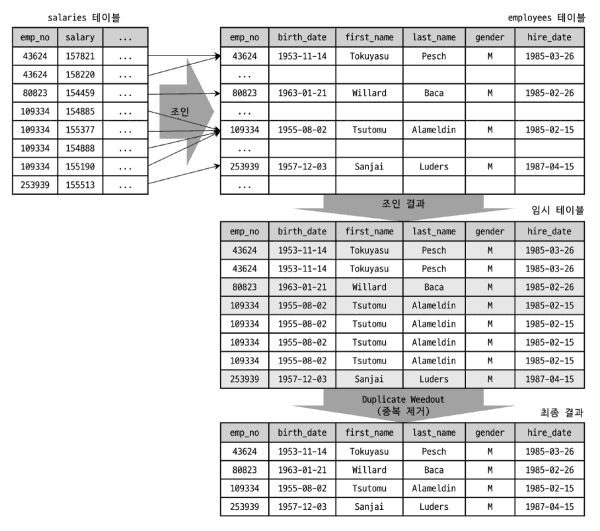
- 실행 순서
- salaries 테이블의 인덱스를 스캔해서 salary가 150000보다 큰 사원을 검색해 employees 테이블 조인을 실행
- 조인된 결과를 임시 테이블에 저장
- 임시 테이블에 저장된 결과에서 emp_no 기준으로 중복 제거
- 중복을 제거하고 남은 레코드를 최종적으로 반환
- 실행 계획의 Extra 컬럼에는 조인과 임시테이블 저장의 반복 시작시
Start temporary문구가, 그리고 반복 과정이 끝나는 테이블의 실행 계획 라인에는End temporary문구가 표시 - 중복 제거 최적화의 장점
- 서브쿼리가 상관 서브쿼리라고 하더라도 사용할 수 있는 최적화다.
- Duplicate Weedout은 서브쿼리의 테이블을 조인으로 처리하기 때문에 최적화할 수 있는 방법이 많다.
- 중복 제거 최적화의 제약사항
- 서브쿼리가 GROUP BY나 집합 함수가 사용된 경우에는 사용될 수 없다.
9.3.1.15 컨디션 팬아웃#
- 조인을 실행할 때 테이블의 순서는 쿼리의 성능에 매우 큰 영향을 미친다.
- A테이블과 B테이블을 조인할 때 A테이블에는 조건에 일치하는 레코드가 1만 건이고 B테이블에는 일치하는 레코드 건수가 10건이라고 가정
- A테이블을 조인의 드라이빙 테이블로 결정하면 B테이블을 1만 번 읽어야 한다.
- B테이블의 인덱스를 이용해 조인을 실행한다고 하더라도 레코드를 읽을 때마다 B테이블의 인덱스를 구성하는 B-Tree의 루트 노드부터 검색을 실행해야 한다.
- MySQL 옵티마이저는 여러 테이블이 조인되는 경우 가능하다면 일치하는 레코드 건수가 적은 순서대로 조인을 실행한다.
SELECT * FROM employees e
INNER JOIN salaries s ON s.emp_no=e.emp_no
WHERE e.first_name='Matt'
AND e.hire_date BETWEEN '1985-11-21' AND '1986-11-21';- 컨디션 팬아웃 없이 실행한다면
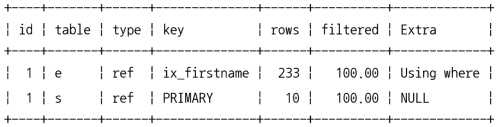
- employees 테이블의 row 칼럼이 233, filtered 칼럼의 값이 100%
- employees 테이블에서 ix_firstname 인덱스를 이용해 first_name='Matt' 조건에 일치하는 233건의 레코드를 검색한다.
- 검색된 233건의 레코드 중에서 hire_date가 1985-11-21부터 1986-11-21일 사이인 레코드만 걸러내는데, 이 실행 계획에서는 filtered 칼럼의 값이 100인 것은 옵티마이저가 233건 모두 hire_date 칼럼의 조건을 만족할 것으로 예측했다는 것을 의미
- employees 테이블을 읽은 결과 233건에 대해 salaries 테이블의 프라이머리 키를 이용해 salaries 테이블의 레코드를 읽는다. 이때 MySQL 옵티마이저는 employees 테이블의 레코드 한 건당 salaries 테이블의 레코드 10건이 일치할 것으로 예상했다.
- 컨디션 팬아웃 최적화를 진행한다면
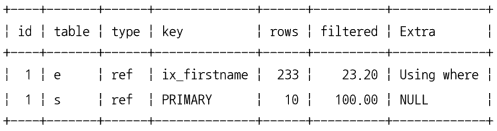
- employees 테이블의 row 칼럼이 233으로 동일, filtered 칼럼의 값이 23.2%로 변경
- 옵티마이저가 first_name 칼럼 조건 이외 의 나머지 조건(hire_date 칼럼의 조건)에 대해서도 얼마나 조건을 충족할지를 고려했다는 뜻
- 이전과 다르게 employees 테이블에서 54건(233 * 0.2320)만 조건을 충족할 것이라고 예측
- 다음 조건을 만족하면 칼럼의 조건들에 대해 조건을 만족하는 레코드 비율 계산 가능
- WHERE 조건절에 사용된 칼럼에 대해 인덱스가 있는 경우
- WHERE 조건절에 사용된 칼럼에 대해 히스토그램이 존재하는 경우
- 옵티마이가 실행 계획을 수립할 때 테이블이나 인덱스의 통계 정보만 사용하는 것이 아니라 다음의 순서대로 사용 가능한 방식을 선택한다.
- 레인지 옵티마이저(Range optimizer)를 이용한 예측
- 히스토그램을 이용한 예측
- 인덱스 통계를 이용한 예측
- 추측에 기반한 예측
- 컨디션 팬아웃을 사용하면 옵티마이저는 더 정교한 계산을 거쳐서 실 행 계획을 수립
- 쿼리의 실행 계획 수립에 더 많은 시간과 컴퓨팅 자원을 사용하게 된다.
- MySQL 8.0 이전 버전에서도 쿼리 실행 계획이 잘못된 선택을 한 적이 별로 없다면 팬아웃 최적화는 성능 향상에 크게 도움되지 않을 수 있음
- 쿼리의 빈도가 매우 높다면 실행 계획 수립에 추가되는 오버헤드가 더 크게 보일 수 있으므로 가능하면 업그레이드를 실행하기 전에 성능 테스트를 진행하는 것이 좋다.
9.3.1.16 파생 테이블 머지#
- 옛 버전의 MySQL은 FROM절에 사용된 서브쿼리는 먼저 실행하고 그 결과를 임시 테이블로 만든 다음 외부 쿼리 부분을 처리
EXPLAIN
SELECT * FROM (
	SELECT * FROM employees
	WHERE first_name='Matt'
) derived_table
WHERE derived_table.hire_date='1986-04-03';- emplyees 테이블에서 first_name 칼럼의 값이 ‘Matt’인 레코드들만 읽어서 임시 테이 블을 생성
- 이 임시 테이블을 다시 읽어서 hire_date 칼럼의 값이 ‘1986-04-03’인 레코드만 걸러내어 반환한 것
- MySQL에서는 이렇게 FROM 절에 사용된 서브쿼리를 파생 테이블(Derived Table)이라고 부른다.
- 해당 실행 계획의 경우 내부적으로 임시 테이블을 생성하고 first_name='Matt'인 레코드를 employees 테이블에서 읽어서 임시 테이블로 INSERT
- 그리고 다시 임시 테이블을 읽으므로 MySQL 서버는 레코드를 복사하고 읽는 오버헤드가 더 추가 됨
- 임시 테이블 레코드가 많아지면 디스크로 가기 때문에 크기가 작다면 큰 영향을 미치지 않겠지만 레코드가 많아지면 오버헤드로 인해 성능은 느려질 것
SELECT
	employees.employees.emp_no AS emp_no,
	employees.employees.birth_date AS birth_date,
	employees.employees.first_name AS first_name,
	employees.employees.last_name AS last_name,
	employees.employees.gender AS gender,
	employees.employees.hire_date AS hire_date
FROM employees.employees
WHERE (
	(employees.employees.hire_date = DATE'1986-04-03')
	AND (employees.employees.first_name 'Matt')
)- 모든 서브쿼리를 외부 쿼리로 병합 가능한게 아니기 때문에 가능하다면 서브쿼리는 외부 쿼리로 수동으로 병합해서 작성하는 것이 성능 향상에 도움이 된다.
- 아래의 경우 서브쿼리는 가능하다면 외부 쿼리로 수동으로 병합해 작성하는 것이 좋음
- SUM() 또는 MIN(), MAX() 같은 집계 함수와 윈도우 함수가 사용된 서브쿼리
- DISTINCT가 사용된 서브쿼리
- GROUP BY나 HAVING이 사용된 서브쿼리
- LIMIT이 사용된 서브쿼리
- UNION 또는 UNION ALL을 포함하는 서브쿼리
- SELECT 절에 사용된 서브쿼리
- 값이 변경되는 사용자 변수가 사용된 서브쿼리
9.3.1.17 인비저블 인덱스#
- MySQL 8.0 버전부터는 인덱스의 가용 상태를 제어할 수 있는 기능이 추가됐다.
- MySQL 8.0 이전 버전까지는 인덱스가 존재하면 항상 옵티마이저가 실행 계획을 수립할 때 해당 인덱스를 검토하고 사용 했다.
- 하지만 MySQL 8.0 버전부터는 인덱스를 삭제하지 않고, 해당 인덱스를 사용하지 못하게 제어하는 기능을 제공
9.3.1.18 스킵 스캔#
인덱스의 핵심은 값이 정렬돼 있다는 것이며, 이로 인해 인덱스를 구성하는 칼럼의 순서가 매우 중요
A, B, C칼럼으로 구성된 인덱스가 있을 때- WHERE 절에 A와 B 칼럼에 대한 조건이 있다면 이 쿼리는 A 칼럼과 B 칼럼까지만 인덱스를 활용
- WHERE 절에 A 칼럼에 대한 조건만 가지고 있다면 A 칼럼까지만 인덱스를 활용
- WHERE 절에 B와 C 칼럼에 대한 조건을 가지고 있다면 이 쿼리는 인덱스를 활용할 수 없음
- 인덱스 스킵 스캔은 제한적이긴 하지만 인덱스의 이런 제약 사항을 뛰어넘을 수 있는 최적화 기법이다.
ALTER TABLE employees ADD INDEX ix_gender_birthdate (gender, birth_date);

-- // ix_gender_birthdate 인덱스를 사용하지 못하는 쿼리
SELECT * FROM employees WHERE birth_date>='1965-02-01';
-- // ix_gender_birthdate 인덱스를 사용할 수 있는 쿼리
SELECT * FROM employees WHERE gender='M' AND birth_date>='1965-02-01';gender칼럼과birth_date칼럼의 조건을 모두 가진 두 번째 쿼리는 인덱스를 효율적으로 사용할 수 있지만gender칼럼에 대한 비교 조건이 없는 첫 번째 쿼리는 인덱스를 사용할 수가 없었다.- 주로 이런 경우에는
birth_date칼럼부터 시작하는 인덱스를 새로 생성해야만 했다. - 하지만 MySQL 8.0 버전부터는 인덱스 스킵 스캔 최적화가 도입 됨
- 이 기능은 인덱스의 선행 칼럼이 조건절에 사용되지 않더라도 후행 칼럼의 조건만으로도 인덱스를 이용한 쿼리 성능 개선이 가능
- MySQL 8.0 버전의 옵티마이저는 테이블에 존재하는 모든
gender칼럼을 값을 가져와 두 번째 쿼리와 같이gender칼럼의 조건이 있는 것처럼 쿼리를 최적화한다. - 그런데 인덱스의 선행 칼럼이 매우 다양한 값을 가지는 경우에는 인덱스 스킵 스캔 최적화가 비효율적일 수 있다.
- 그래서 MySQL 8.0 옵티마이저는 인덱스의 선행 칼럼이 소수의 유니크한 값을 가질 때만 인덱스 스킵 스캔 최적화를 사용한다.
9.3.1.19 해시 조인#
9.3.1.20 인덱스 선호 정렬#
9.3.2 조인 최적화 알고리즘#
- MySQL에는 조인 쿼리의 실행 계획 최적화를 위한 알고리즘이 2개 있다.
- 이 알고리즘들은 오래 전부터 존재했지만 중요성에 비해 모르는 경우가 많다.
- 조인된 테이블의 개수가 많아 지면 실행계획을 수립하는게 어려워진다.
- 테이블의 개수가 특정 한계를 넘어서면 그때 부터는 실행 계획 수립에 소요되는 시간만 몇 시간이나 며칠로 늘어날 수도 있다.
9.3.2.1 Exhaustive 검색 알고리즘#
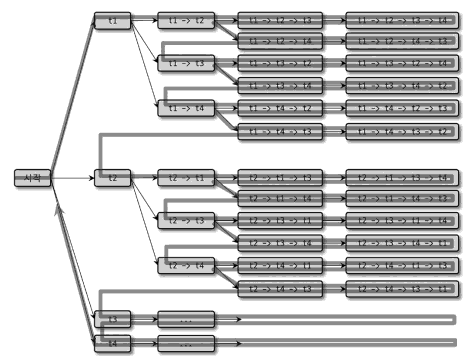
- Exhaustive 검색 알고리즘은 MySQL 5.0과 그 이전 버전에서 사용되던 조인 최적화 기법
- FROM 절에 명시된 모든 테이블의 조합에 대해 실행 계획의 비용을 계산해서 최적의 조합 1개를 찾는 방법
- 가령 테이블이 20개라면 이 방법으로 처리했을 때 가능한 조인 조합은 모두 20!(팩토리얼)개가 된다.
- 이전 버전의 Exhaustive 검색 알고리즘에서는 사실 테이블이 10개만 넘어도 실행 계획을 수립하는 데 몇 분이 걸린다.
9.3.2.2 Greedy 검색 알고리즘#
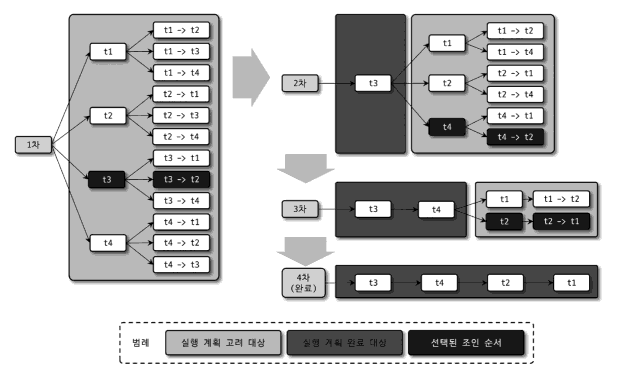
- Greedy 검색 알고리즘은 Exhaustive 검색 알고리즘의 시간 소모적인 문제점을 해결하기 위해 MySQL 5.0부터 도입된 조인 최적화 기법
- 그림의 조인 최적화 순서
- 전체 N개의 테이블 중에서
optimizer_search_depth시스템 설정 변수에 정의된 개수의 테이블로 가능한 조인 조합을 생성 - 1번에서 생성된 조인 조합 중에서 최소 비용의 실행 계획 하나를 선정
- 2번에서 선정된 실행 계획의 첫 번째 테이블을 부분 실행 계획(실행 계획 완료 대상) 의 첫 번째 테이블로 선정
- 전체 N-1개의 테이블 중(3번에서 선택된 테이블 제외)에서
optimizer_search_depth시스템 설정 변수에 정의된 개수의 테이블로 가능한 조인 조합을 생성 - 4번에서 생성된 조인 조합들을 하나씩 3번에서 생성된 부분 실행 계획에 대입해 실행 비용을 계산
- 5번의 비용 계산 결과, 최적의 실행 계획에서 두 번째 테이블을 3번에서 생성된 부분 실행 계획의 두 번째 테이블 로 선정
- 남은 테이블이 모두 없어질 때까지 4~6번까지의 과정을 반복 실행하면서 부분 실행 계획에 테이블의 조인 순서 를 기록
- 최종적으로 부분 실행 계획이 테이블의 조인 순서로 결정됨
optimizer_search_depth시스템 변수는 Greedy 검색 알고리즘과 Exhaustive 검색 알고리즘 중에서 어떤 알 고리즘을 사용할지 결정하는 시스템 변수- 값은 0~62까지의 정숫값을 설정할 수 있음, 1~62까지의 정숫값이 설정되면 Greedy 검색 대상을 지정된 개수로 한정해서 최적의 실행 계획을 산출
- 0으로 설정되면 Greedy 검색을 위해 최적의 조인 검색 테이블의 개수를 MySQL 옵티마이저가 자동으로 결정 함
- 조인에 사용된 테이블의 개수가 설정 값보다 크다면 설정 값 만큼의 테이블은 Exhaustive 검색이 사용되고 나머지 테이블은 Greedy 검색이 사용된다.
- 설정 값보다 작다면 Exhaustive 검색만 사용된다.
optimizer_prune_level시스템 변수는 MySQL 5.0부터 추가된 Heuristic 검색이 작동하는 방식을 제어함- 우리가 어떤 알고리즘을 사용하더라고 MySQL 옵티마이저는 여러 테이블의 조인 순서를 결정하기 위해 상당히 많은 조인 경로를 비교함
- Heuristic 검색의 가장 핵심적인 내용은 다양한 조인 순서의 비용을 계산하는 도중 이미 계산했던 조인 순서의 비용보다 큰 경우에는 언제든지 중간에 포기할 수 있다는 것
- 아우터 조인으로 연결되는 테이블은 우선순위에서 제거하는 등 경험 기반의 최적화도 Heuristic 검색 최적화에는 포함돼 있다.
- 설정 값이 1일 경우 조인 순서 최적화에 경험 기반의 Heuristic 알고리즘을 사용
- 설정 값이 0일 경우 경험 기반의 Heuristic 알고리즘이 사용되지 않음
- 실제 Heuristic 조인 최적화는 조인 대상 테이블이 몇 개 되지 않더라도 상당한 성능 차이를 낸다. 그러므로 특별한 요건이 없다면 설정 값을 0으로 설정하지 말자.
- MySQL 8.0 버전의 조인 최적화는 많이 개선되어
optimizer_search_depth변수의 값에는 크게 영향을 받지 않는 것으로 보인다.- 하지만
optimizer_prune_level을 0으로 설정하면optimizer_search_depth값 변화에 따라 실행 계획 수립에 소요되는 시간이 급증한다.
- 조인 최적화와 관련된 휴리스틱(Heuristic)의 문제점이 있었지만 MySQL 8.0에서는 이런 조인 최적화 관련된 휴리스틱을 비활성화할 필요가 거의 없어졌다.
9.4 쿼리 힌트#
- MySQL 서버는 우리가 서비스하는 비즈니스를 100% 이해하지는 못한다.
- 그래서 서비스 개발자나 DBA보다 MySQL 서버가 부족한 실행 계획을 수립할 때가 있을 수 있다.
- 이런 경우에는 옵티마이저에게 쿼리의 실행 계획을 어떻게 수립해야 할지 알려줄 수 있는 방법이 필요하다.
- MySQL 서버에서 사용 가능한 쿼리 힌트는 2가지로 구분할 수 있다.
- 인덱스 힌트
- 옵티마이저 힌트
- 인덱스 힌트는 예전 버전의 MySQL 서버에서 사용되어 오던
USE INDEX같은 힌트를 의미하며, 옵티마이저 힌트는 MySQL 5.6 버전부터 새롭게 추가되기 시작한 힌트들을 지칭한다.
9.4.1 인덱스 힌트#
STRAIGHT_JOIN과USE INDEX등을 포함한 인덱스 힌트들은 모두 MySQL 서버에 옵티마이저 힌트가 도입되기 전에 사용되던 기능들이다.- 이들은 모두 SQL의 문법에 맞게 사용해야 하기 때문에 사용하게 되면 ANSI-SQL 표준 문법을 준수하지 못하게 되는 단점이 있다.
- MySQL 5.6 버전부터 추가되기 시작한 옵티마이저 힌트들은 모두 MySQL 서버를 제외한 다른 RDBMS에서는 주석으로 해석하기 때문에 표준을 준수한다고 볼 수 있다.
- 그래서 가능하다면 인덱스 힌트보다는 옵티마이저 힌트를 사용할 것을 추천한다.
- 인덱스 힌트는 SELECT 명령과 UPDATE 명령에서만 사용할 수 있다.
9.4.1.1 STRAIGHT_JOIN#
STRAIGHT_JOIN은 옵티마이저 힌트인 동시에 조인 키워드이기도 하다.STRAIGHT_JOIN은SELECT,UPDATE,DELETE쿼리에서 여러 개의 테이블이 조인되는 경우 조인 순서를 고정하는 역할을 한다.- 여러 테이블을 조인할 때 어느 테이블이 드리븐 테이블이 될지 알 수 업삳.
- 옵티마이저가 그때그때 각 테이블의 통계정보와 쿼리의 조건을 기반으로 가장 최적이라고 판단되는 순서로 조인한다.
- 일반적으로 조인을 하기 위한 칼럼들의 인덱스 여부로 조인의 순서가 결정되며, 조인 칼럼의 인덱스에 아무런 문제가 없는 경우에는 레코드가 적은 테이블을 드라이빙 으로 선택한다.
- WHERE 조건이 있는 경우는 WHERE 조건을 만족하는 테이블 선택
- 쿼리의 조인 순서를 변경하려는 경우에는
STRAIGHT_JOIN힌트를 사용할 수 있다. - 인덱스 힌트는 사용해야 하는 위치가 이미 결정됐으므로 그 이외의 다른 위치에서는 사용하지 않도록 주의하자.
- 다음 기준에 맞게 조인 순서가 결정되지 않는 경우에만 조인 순서를 조정하는게 좋다.
- 임시 테이블(인라인 뷰 또는 파생된 테이블)과 일반 테이블의 조인
- 이 경우에는 거의 일반적으로 임시 테이블을 드라이빙 테이블로 선정하는 것이 좋다
- 일반 테이블의 조인 칼럼에 인덱스가 없는 경우에는 레코드 건수가 작은 쪽을 먼저 읽도록 드라이빙으로 선택하는 것이 좋은데, 대부분 옵티마이저가 적절한 조인 순서를 선택하기 때문에 쿼리를 작성할 때부터 힌트를 사용할 필요는 없다.
- 임시 테이블끼리 조인
- 임시 테이블(서브쿼리로 파생된 테이블)은 항상 인덱스가 없기 때문에 어느 테이블을 먼저 드라이빙으로 읽어도 무관하므로 크기가 작은 테이블을 드라이빙으로 선택해주는 것이 좋다.
- 일반 테이블끼리 조인
- 양쪽 테이블 모두 조인 칼럼에 인덱스가 있거나 양쪽 테이블 모두 조인 칼럼에 인덱스가 없는 경우에는 레코드 건수가 적은 테이블을 드라이빙으로 선택해주는 것이 좋음
- 그 이외의 경우에는 조인 칼럼에 인덱스가 없는 테이블을 드라이빙으로 선택하는 것이 좋다.
STRAIGHT_JOIN힌트와 비슷한 역할을 한는 힌트- JOIN_FIXED_ORDER / JOIN_ORDER / JOIN_PREFIX / JOIN_SUFFIX
- JOIN_FIXED_ORDER 옵티마이저 힌트는 STRAIGHT_JOIN 힌트와 동일한 효과를 낸다.
- STRAIGHT_JOIN 힌트는 한 번 사용되면 FROM 절의 모든 테이블에 대해 조인 순서가 결정되는 효과를 낸다.
- 하지만 나머지 3개의 옵티마이저 힌트(JOIN_ORDER와 JOIN_PREFIX, 그리고 JOIN_SUFFIX)는 STRAIGHT_JOIN과는 달리 일부 테이블의 조인 순서에 대해서만 제안하는 힌트다.
9.4.1.2 USE INDEX / FORCE INDEX / IGNORE INDEX#
- 조인의 순서를 변경하는 것 다음으로 자주 사용되는 것이 인덱스 힌트인데,
STRAIGHT_JOIN힌트와는 달리 인덱스 힌트는 사용하려는 인덱스를 가지는 테이블 뒤에 힌트를 명시해야 한다. - 대체로 옵티마이저는 어떤 인덱스를 사용해야 할지 무난하게 잘 선택하는 편
- 3~4개 이상의 칼럼을 포함하는 비슷한 인덱스가 여러개 존재하면 가끔 실수함
- 이런 경우에는 강제로 특정 인덱스를 사용하도록 힌트를 추가한다.
- 인덱스 힌트 3가지
- USE INDEX
- 가장 자주 사용되는 인덱스 힌트
- MySQL 옵티마이저에게 특정 테이블의 인덱스를 사용하도록 권장하는 힌트
- 대부분의 경우 인덱스 힌트가 주어지면 옵티마이저는 사용자의 힌트를 채택함
- 하지만 항상 그 인덱스를 사용하는 것은 아니다.
- FORCE INDEX
- USE INDEX와 비교해서 다른 점은 없음
- USE INDEX보다 옵티마이저에게 미치는 영향이 더 강한 힌트로
- 하지만 USE INDEX 힌트만으로도 옵티마이저에 대한 영향력이 충분히 크기 때문에 FORCE INDEX는 거의 사용할 필요가 없음
- IGNORE INDEX
- 특정 인덱스를 사용하지 못하게 하는 용도로 사용하는 힌트
- 옵티마이저가 풀 테이블 스캔을 사용하도록 유도하기 위해 IGNORE INDEX 힌트를 사용할 수도 있다.
- 용도가 명시되지 않을 경우 3가지 용도로 사용됨
- USE INDEX FOR JOIN
- 여기서 JOIN이라는 키워드는 테이블 간의 조인뿐만 아니라 레코드를 검색하기 위한 용도까지 포함하는 용어
- 이미 실행 계획 부분에서도 한 번 언급했듯이 MySQL 서버에서는 하나의 테이블로부터 데이터를 검색하는 작업도 JOIN이라고 표현
- 때문에 FOR JOIN이라는 이름이 붙은 것이다.
- USE INDEX FOR ORDER BY
- 명시된 인덱스를 ORDER BY 용도로만 사용할 수 있게 제한
- USE INDEX FOR GROUP BY
- 명시된 인덱스를 GROUP BY 용도로만 사용할 수 있게 제한
- 인덱스의 사용법이나 좋은 실행 계획이 어떤 것인지 판단하기 힘든 상황이라면 힌트를 사용해 강제로 옵티마이저의 실행 계획에 영향을 미치는 것은 피하는 것이 좋음
- MySQL의 옵티마이저도 한눈에 파악할 수 있을 정도의 최적화는 눈 깜짝할 사이에 처리하기 때문
- 가장 훌륭한 최적화는 그 쿼리를 서비스에서 없애 버리거나 튜닝할 필요가 없게 데이터를 최소화하는 것
- 그것이 어렵다면 데이터 모델의 단순화를 통해 쿼리를 간결하게 만들고 힌트가 필요없게 만드는 것
- 실무에서는 앞쪽의 작업들에 상당한 시간과 작업 능력이 필요하기 때문에 항상 이런 힌트에 의존하는 경우가 많다.
9.4.1.3 SQL_CALC_FOUND_ROWS#
- LIMIT을 사용하는 경우, 조건을 만족하는 레코드가 LIMIT에 명시된 수보다 더 많다고 하더라도 LIMIT에 명시된 수만큼 만족하는 레코드를 찾으면 즉시 검색 작업을 멈춘다
- 하지만 SQL_CALC_FOUND_ROWS 힌트가 포함된 쿼리의 경우에는 LIMIT을 만족하는 수만큼의 레코드를 찾았다고 하더라도 끝까지 검색을 수행한다.
- 최종적으로 사용자에게는 LIMIT에 제한된 수만큼의 결과 레코드만 반환됨에도 불구함에도
- 페이징을 위해서 검토할만한 작업임
- SQL_CALC_FOUND_ROWS 사용법sql
SELECT SQL_CALC_FOUND_ROWS * FROM employees WHERE first_name='Georgi' LIMIT 0, 20; SELECT FOUND_ROWS() AS total_record_count;- 이 경우에는 한 번의 쿼리 실행으로 필요한 정보 2가지를 모두 가져오는 것처럼 보이지만 FOUND_ROWS() 함수의 실행을 위해 또 한 번의 쿼리가 필요하기 때문에 쿼리를 2번 실행해야 한다.
- SQL_CALC_FOUND_ ROWS 힌트 때문에 조건을 만족하는 레코드 전부를 읽어 봐야함
- 랜덤 I/O가 발생하게 됨
- 기존 2개의 쿼리로 쪼개어 실행하는 방법sql
SELECT COUNT(*) FROM employees WHERE first_name='Georgi'; SELECT * FROM employees WHERE first_name='Georgi' LIMIT 0, 20;- 이 방식 또한 쿼리는 2번 실행해야 한다.
- 이 쿼리에서는 실제의 레코드 데이터가 필요한 것이 아니라 건수만 가져오면 되기 때문에 실제로 데이터 레코드를 찾아 가기 위한 랜덤 I/O는 발생하지 않는다
- 커버링 인덱스(Covering index) 쿼리이기 때문이다.
- SQL_CALC_FOUND_ROWS은 인덱스를 이용하는 방식과 비교도 안되게 느리다.
- UNION(또는 UNION DISTINCT)으로 연결된 경우에는 SQL_CALC_FOUND_ROWS 힌트를 사용해도 FOUND_ROWS() 함수로 정확한 레코드 건수를 가져올 수 없다는 것도 문제
- 인덱스나 쿼리의 튜닝이 제대로 됐다면 SQL_CALC_FOUND_ROWS는 사용하지 않는게 좋다.
- 결론
- 제대로 쿼리나 인덱스를 튜닝해서 해당 힌트는 쓰지말자
9.4.2 옵티마이저 힌트#
9.4.2.1 옵티마이저 힌트 종류#
- 영향 범위에 따라 4개의 그룹으로 나눠볼 수 있음
- 인덱스: 특정 인덱스의 이름을 사용할 수 있는 옵티마이저 힌트
- 테이블: 특정 테이블의 이름을 사용할 수 있는 옵티마이저 힌트
- 쿼리 블록: 특정 쿼리 블록에 사용할 수 있는 옵티마이저 힌트로서, 특정 쿼리 블록의 이름을 명시하는 것이 아니라 힌트가 명시된 쿼리 블록에 대해서만 영향을 미치는 옵티마이저 힌트
- 글로벌(쿼리 전체): 전체 쿼리에 대해서 영향을 미치는 힌트
- 위 구분들로 인해 힌트 사용위치가 달라지지 않음
- 힌트에 인덱스 이름이 명시될 수 있는 경우를 인덱스 수준의 힌트로 구분하고, 테이블 이름까지만 명시될 수 있는 경우를 테이블 수준의 힌트로 구분
- 인덱스의 이름을 모두 명시할 수도 있지만 인덱스의 이름을 명시하지 않고 테이블 이름만 명시할 수도 있는데, 이런 경우는 인덱스와 테이블 수준의 힌트가 된다.
인덱스 힌트의 종류 (너무 많아서 감춤)
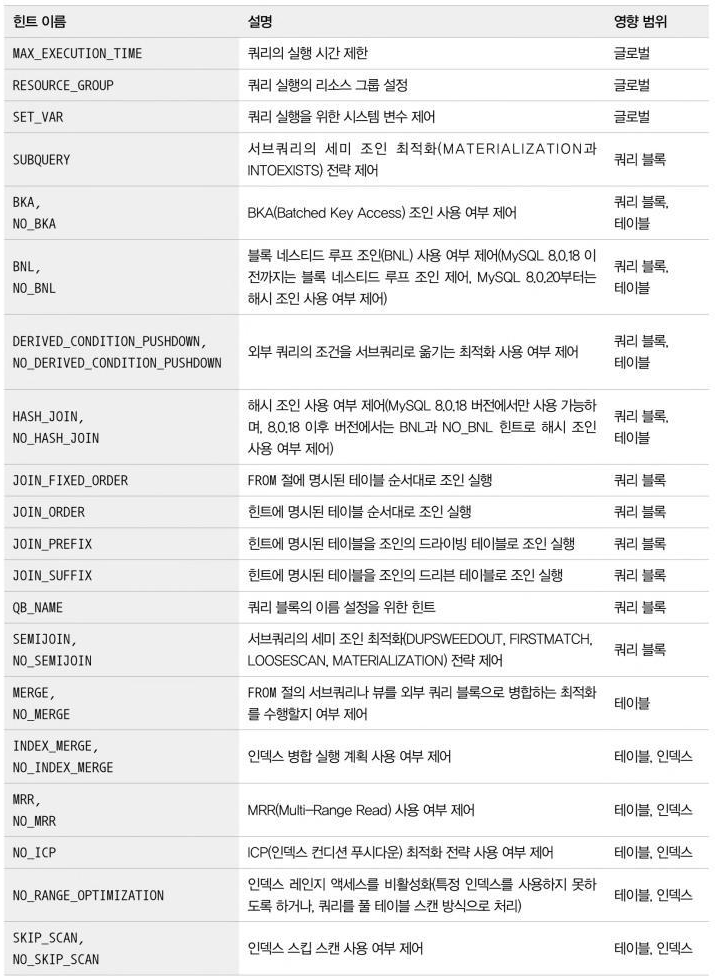
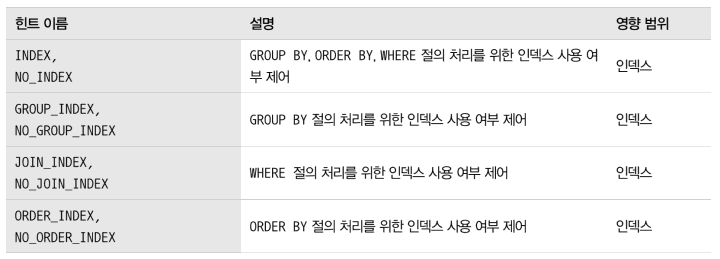
- 모든 인덱스 수준의 힌트는 반드시 테이블명이 선행돼야 한다. 예를 들어, 인덱스 수준의 옵티마이저 힌트인 INDEX 힌트를 사용하는 경우 사용할 인덱스명을 사용해야 한다.
- 하나의 SQL 문장에서 SELECT 키워드는 여러 번 사용될 수 있다.
- 각 SELECT 키워드로 시작하는 서브쿼리 영역을 쿼리 블록이라고 한다.
- 특정 쿼리 블록에 영향을 미치는 옵티마이저 힌트는 그 쿼리 블록 내에서 사용될 수도 있지만 외부 쿼리 블록에서 사용할 수도 있다.
- 이처럼 특정 쿼리 블록을 외부 쿼 리 블록에서 사용하려면
QB_NAME()힌트를 이용해 해당 쿼리 블록에 이름을 부여해야 한다.
9.4.2.2 MAX_EXECUTION_TIME#
- 옵티마이저 힌트 중에서 유일하게 쿼리의 실행 계획에 영향을 미치지 않는 힌트
- 단순히 쿼리의 최대 실행 시간을 설정하는 힌트
- 밀리초 단위의 시간을 설정
- 쿼리가 지정된 시간을 초과하면 다음과 같이 쿼리는 실패하게 된다.
9.4.2.3 SET_VAR#
- 옵티마이저 힌트뿐만 아니라 MySQL 서버의 시스템 변수들 또한 쿼리의 실행 계획에 상당한 영향을 미침
- 대표적으로 조인 버퍼의 크기를 설정하는 join_buffer_size 시스템 변수의 경우 쿼리에 아무런 영향을 미치지 않을 것처럼 보인다.
- 하지만 옵티마이저는 조인 버퍼의 공간이 충분하면 조인 버퍼를 활용하는 형태의 실행 계획을 선택할 수도 있음
- 그뿐만 아니라 옵티마이저 힌트로 부족한 경우 optimizer_switch 시스템 변수를 제어해야 할 수도 있다.
- SET_VAR 힌트는 실행 계획을 바꾸는 용도뿐만 아니라 조인 버퍼나 정렬용 버퍼(소트 버퍼)의 크기를 일시적으로 증가시켜 대용량 처리 쿼리의 성능을 향상시키는 용도로도 사용할 수 있다.
9.4.2.4 SEMIJOIN & NO_SEMIJOIN#
- 세미 조인의 최적화는 여러 가지 세부 전략이 있다는 것을 이미 살펴봤다.
- SEMIJOIN 힌트는 어떤 세부 전략을 사용할지를 제어하는데 사용할 수 있다.
| 최적화 전략 | 힌트 |
| SEMIJOIN(DUPSWEEDOUT) | First Match |
| SEMIJOIN(FIRSTMATCH) | Loose Scan |
| SEMIJOIN(LOOSESCAN) | Materialization |
| SEMIJOIN(MATERIALIZATION) | Table |
| Pull-out | 없음 |
Table Pull-out최적화 전략은 별도로 힌트를 사용할 수 없다.Table Pull-out전략은 그 전략을 사용할 수 있다면 항상 더 나은 성능을 보장하기 때문- 하지만 다른 최적화 전략들은 상황에 따라 다른 최적화 전략으로 우회하는 것이 더 나은 성능을 낼 수도 있기 때문에 NO_SEMIJOIN 힌트도 제공되는 것
9.4.2.5 SUBQUERY#
- 서브쿼리 최적화는 세미 조인 최적화가 사용되지 못할 때 사용하는 최적화 방법
- 서브쿼리는 2가지 형태로 최적화할 수 있다.
| 최적화 전략 | 힌트 |
| IN-to-EXISTS | SUBQUERY(INTOEXISTS) |
| Materialization | SUBQUERY(MATERIALIZATION) |
- 세미 조인 최적화는 주로 IN(subquery) 형태의 쿼리에 사용될 수 있지만 안티 세미 조인(Anti Semi Join)의 최적화에는 사용될 수 없다.
- 서브쿼리 최적화 힌트는 세미 조인 최적화 힌트와 비슷한 형태
- 서브쿼리에 힌트를 사용하거나 서브쿼리에 쿼리 블록 이름을 지정해서 외부 쿼리 블록에서 최적화 방법을 명시하면 됨
9.4.2.6 BNL & NO_BNL & HASHJOIN & NO_HASHJOIN#
- MySQL 8.0.18 버전부터는 새롭게 도입된 해시 조인 알고리즘이 블록 네스티드 루프 조인을 대체하도록 개선됐다.
- 그런데도 BNL 힌트와 NO_BNL 힌트는 MySQL 8.0.20과 그 이 후의 버전에서도 여전히 사용 가능함
- MySQL 8.0.20 버전과 그 이후 버전에서는 BNL 힌트를 사용하면 해시 조인을 사용하도록 유도하는 힌트로 용도가 변경
- HASHJOIN과 NO_HASHJOIN 힌트는 MySQL 8.0.18 버전에서만 유효하며, 그 이후 버전에서는 효력이 없다.
9.4.2.7 JOIN_FIXED_ORDER & JOIN_ORDER & JOIN_PREFIX & JOIN_SUFFIX#
- MySQL 서버에서는 조인의 순서를 결정하기 위해 전통적으로 STRAIGHT_JOIN 힌트를 사용
- 하지만 STRAIGHT_JOIN 힌트는 우선 쿼리의 FROM 절에 사용된 테이블의 순서를 조인 순서에 맞게 변경해야 하는 번거로움이 있음
- 또한 STRAIGHT_JOIN은 한 번 사용되면 FROM 절에 명시된 모든 테이블의 조인 순서가 결정되기 때문에 일부는 조인 순서를 강제하고 나머지는 옵티마이저에게 순서를 결정하게 맞기는 것이 불가능 함
- 이런 단점들을 보완하기 위해 STRAIGHT_JOIN과 동일한 힌트까지 포함해서 다음과 같이 4개의 힌트를 제공
- JOIN_FIXED_ORDER: STRAIGHT_JOIN 힌트와 동일하게 FROM 절의 테이블 순서대로 조인을 실행하게 하는 힌트
- JOIN_ORDER: FROM 절에 사용된 테이블의 순서가 아니라 힌트에 명시된 테이블의 순서대로 조인을 실행하는 힌트
- JOIN_PREFIX: 조인에서 드라이빙 테이블만 강제하는 힌트
- JOIN_SUFFIX: 조인에서 드리븐 테이블(가장 마지막에 조인돼야 할 테이블들)만 강제하는 힌트
9.4.2.8 MERGE & NO_MERGE#
- 예전 버전의 MySQL 서버에서는 FROM 절에 사용된 서브쿼리를 항상 내부 임시 테이블로 생성함
- 생성된 내부 임시 테이블을 파생 테이블(Derived table)이라고 하는데, 이는 불필요한 자원 소모 를 유발
- 그래서 MySQL 5.7과 8.0 버전에서는 가능하면 임시 테이블을 사용하지 않게 FROM 절의 서브쿼리를 외부 쿼리와 병합하는 최적화를 도입
- 때로는 MySQL 옵티마이저가 내부 쿼리를 외 부 쿼리와 병합하는 것이 나을 수도 있고, 때로는 내부 임시 테이블을 생성하는 것이 더 나은 선택일 수도 있음
- 이런 경우 MERGE 또는 NO_MERGE 힌트를 사용하면 됨
9.4.2.9 INDEX_MERGE & NO_INDEX_MERGE#
- MySQL 서버는 가능하다면 테이블당 하나의 인덱스만을 이용해 쿼리를 처리하려고 함
- 하지만 하나의 인덱스만으로 검색 대상 범위를 충분히 좁힐 수 없다면 옵티마이저는 사용 가능한 다른 인덱스를 이용하기도 함
- 여러 인덱스를 통해 검색된 레코드로부터 교집합 또는 합집합만을 구해서 그 결과를 반환
- 이처럼 하나의 테이블에 대해 여러 개의 인덱스를 동시에 사용하는 것을 인덱스 머지라 함
- 인덱스 머지 실행 계획은 때로는 성능 향상에 도움이 되지만 항상 그렇지는 않을 수도 있다.
- 인덱스 머지 실행 계획의 사용 여부를 제어하려면
- INDEX_MERGE와 NO_INDEX_MERGE 옵티마이저 힌트를 이용하면 된다.
9.4.2.10 NO_ICP#
- 인덱스 컨디션 푸시다운 최적화는 사용 가능하다면 항상 성능 향상에 도움이 되므로 MySQL 옵티마이저는 최대한 인덱스 컨디션 푸시다운 기능을 사용하는 방향으로 실행 계획을 수립 함
- 옵티마이저에서는 ICP 힌트는 제공되지 않는다.
- 그런데 인덱스 컨디션 푸시다운으로 인해 여러 실행 계획의 비용 계산이 잘못된다면 결과적으로 잘못된 실행 계획을 수립하게 될 수도 있다.
- 인덱스 컨디션 푸시다운 최적화만 비활성화해서 조금 더 유연하고 정확하게 실행 계획을 선택하게 할 수 있다.
9.4.2.11 SKIP_SCAN & NO_SKIP_SCAN#
- 인덱스 스킵 스캔은 인덱스의 선행 칼럼에 대한 조건이 없어도 옵티마이저가 해당 인덱스를 사용할 수 있게 해주는 매우 훌륭한 최적화 기능
- 하지만 조건이 누락된 선행 칼럼이 가지는 유니크한 값의 개수가 많아진다면 인덱스 스킵 스캔의 성능은 오히려 더 떨어짐
- 옵티마이저가 유니크한 값의 개수를 제대로 분석하지 못하거나 잘못된 경로로 인해 비효율적인 인덱스 스킵 스캔을 선택한다면
- NO_SKIP_SCAN 옵티마이저 힌트를 이용해 인덱스 스킵 스캔을 사용하지 않게 할 수 있다.
9.4.2.12 INDEX & NO_INDEX#
- 인덱스 힌트를 대체하는 용도로 제공됨
| 인덱스 힌트 | 옵티마이저 힌트 |
| USE INDEX | INDEX |
| USE INDEX FOR GROUP BY | GROUP_INDEX |
| USE INDEX FOR ORDER BY | ORDER_INDEX |
| IGNORE INDEX | NO_INDEX |
| IGNORE INDEX FOR GROUP BY | NO_GROUP_INDEX |
| IGNORE INDEX FOR ORDER BY | NO_ORDER_INDE |
- 옵티마이저 힌트에는 테이블명과 인덱스 이름을 함께 명시해야 한다.