1장 - 사용자 수에 따른 규모 확장성
- 태그
- Interview
- 생성일
- 2022년 10월 20일 PM 12:02
1. 단일서버#
1.1. 단일서버란?#
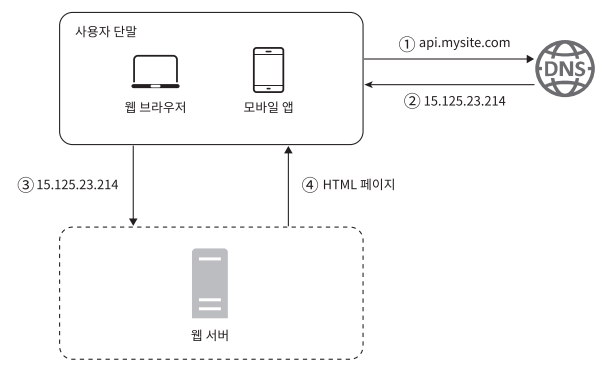
- 웹, 앱, 데이터베이스, 캐시 등이 모두 한 대의 서버에서 실행되는 형태
1.2. 단일 서버의 사용자 요청 처리 흐름#
- 사용자는 DNS를 통해서 웹사이트의 접속 정보를 받는다.
- DNS 조회 결과로 IP주소가 반환된다.
- 해당 IP 주소로 HTTP 요청이 전달된다.
- 요청을 받은 웹 서버는 HTML 페이지나 JSON 형태의 응답을 반환한다.
1.3. 요청 단말의 종류#
단말의 종류는 크게 웹과 앱으로 구분할 수 있다.
- 웹 어플리케이션
- 비즈니스 로직, 데이터 저장 등을 처리하기 위한 서버 구현용 언어를 사용한다.
- 프레젠테이션용으로는 클라이언트 구현용 언어를 사용한다.
- 모바일 앱
- 모바일 앱과 웹 서버 간 통신을 하기 위해서는 HTTP 프로코톨을 이용한다.
- HTTP 프로토콜을 통해 반환될 응답 데이터 포맷은 보통 JSON 포맷이 사용된다.
2. 데이터베이스#
2.1. 데이터 베이스의 분리#
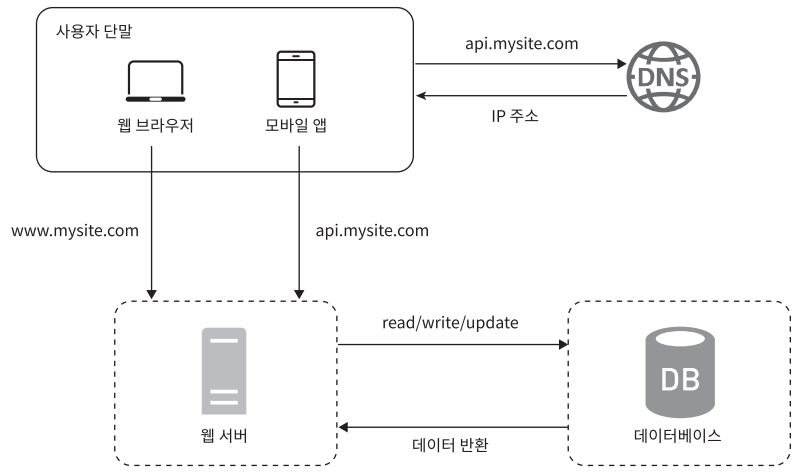
사용자가 늘어나면 서버 하나로는 충분하지 않아 여러 서버로 분리하여 사용하게 된다.
- 웹/모바일 트래픽 처리 용도
- 데이터베이스 용도
2.2. 사용할 데이터베이스 선택#
데이터베이스는 크게 관계형과 비-관계형으로 나눠 구분할 수 있다.
2.2.1 관계형 데이터베이스#
- 관계형 데이터베이스는 관계형 데이터베이스 관리 시스템이라 부른다.
- Relational Database Management System, RDBMS
- 가장 유명한 것으로는 MySQL, Oracle, PostgreSQL 등이 있다.
- 관계형 데이터베이스는 자료를 테이블과 열, 칼럼으로 표현하고, SQL을 사용해 여러 테이블에 있는 데이터를 관계에 따라 조인하여 합칠 수 있다.
2.2.2. 비-관계형 데이터베이스#
- 비 관계형 데이터베이스는 NoSQL이라고도 부른다.
- 대표적으로 CouchDB, Neo4j, Cassandra, HBase, Amazon DynamoDB 등이 있다.
- 비 관계형 데이터베이스는 일반적으로 조인 연산은 지원하지 않는다.
- NoSQL은 다시 네 분류로 나눌 수 있다.
- 키-값 저장소 (key-value store)
- 그래프 저장소 (graph store)
- 칼럼 저장소 (column store)
- 문서 저장소 (document store)
- 비 관계형 데이터베이스가 바람직한 경우
- 아주 낮은 응답시간(latency)이 요구되는 경우
- 다른 데이터가 비정형(unstructured)이라 관계형 데이터가 아닌 경우
- 데이터(JSON, YAML, XML 등)를 직렬화하거나 역직렬화 할 수 있기만 하면 되는 경우
- 아주 많은 양의 데이터를 저장할 필요가 있는 경우
3. 수평적 규모 확장 vs 수직적 규모 확장#
3.1. 수평적 확장#
- 스케일 아웃(Scale out)이라고 불린다.
- 더 많은 서버를 추가해 성능을 개선하는 행위
- 수직적 확장의 단점 때문에 대규모 어플리케이션을 지원하는 데는 해당 방법이 적절하다.
3.2. 수직적 확장#
- 스케일 업(Scale up)이라고 불린다.
- 서버에 고사양 자원(추가적인 CPU, RAM 등)을 추가하는 행위
- 서버의 트래픽 양이 적을때는 수직적 확장이 좋은 선택이다.
- 해당 방법의 가장 큰 장점은 확장의 단순함에 있다.
3.2.1. 단점#
- 수직적 규모 확장에는 한계가 있다.
- 서버 한 대에 무한대로 사양을 증설할 방법이 없다.
- 수직적 규모 확장법은 장애에 대한 자동복구(Failover) 방안이나 다중화 방안을 제시하지 않는다.
- 장애가 발생하면 웹/앱 서비스가 모두 중단된다.
3.2. 로드밸런서#
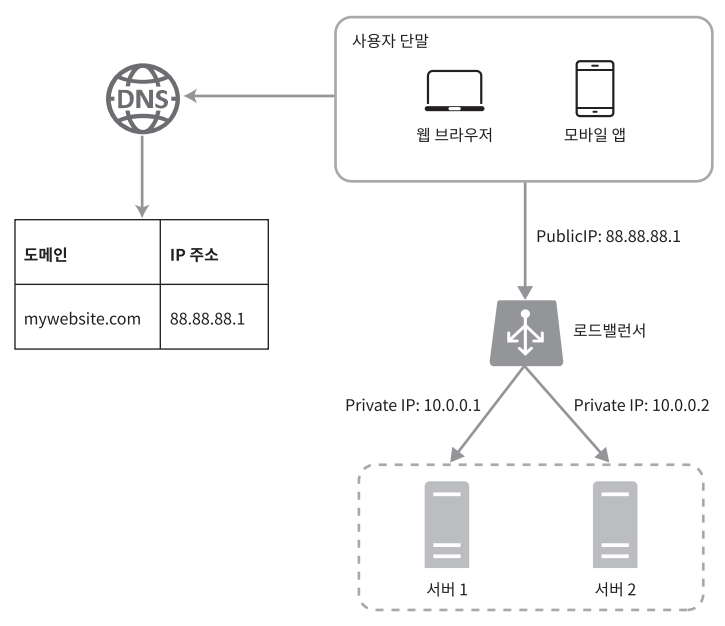
- 서버가 한계 상황에 도달하게 되면 응답 속도가 느려지거나 접속이 불가능해질 수도 있다.
- 이런 문제를 해결하기 위한 방법으로 분산부하기인 로드밸런서를 도입하는것이 최선이다.
- 사용자는 로드밸런서로 접속하고 서버로 직접적으로 접속하지 않는다.
- 더 나은 보안을 위해 서버 간 통신은 사설IP를 이용한다.
- 서버1이 다운되면 모든 트래픽은 서버2로 전송된다.
- 따라서 웹 사이트 전체가 다운되는 일이 방지된다.
- 부하를 나누기 위해 새로운 서버를 추가할 수도 있다.
3.3. 데이터베이스 다중화#
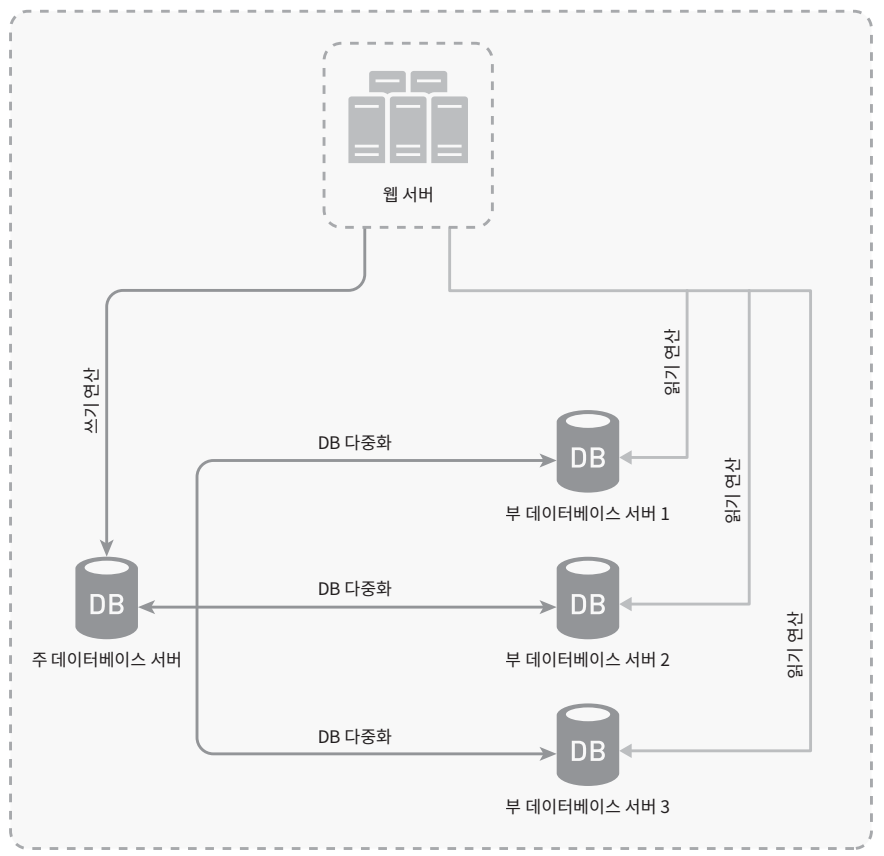
- 일반적으로 나눠진 데이터베이스 다중화의 형태
- 주(master)-부(slave) 관계를 설정해 원본은 주 서버, 사본은 부 서버에 저장한다.
- 쓰기연산과 읽기연산의 부하 분산이라 말할 수 있다.
- DB 다중화를 하면 얻게되는 이점
- 더 나은 성능 - 병렬 처리되는 읽기 연산이 늘어나 성능이 좋아진다.
- 안정성 - 데이터를 여러 지역에 다중화 해놓으면 재해를 당해도 데이터를 보존할 수 있다.
- 가용성 - 데이터를 여러 지역에 복제해두어 하나의 DB에서 장애가 발생해도 다른지역에서 가져올 수 있다.
- 주 서버가 죽으면?
- 하나의 부 서버가 주 서버로 승급하여 쓰기 연산을 받기 시작한다.
3.4. 요약#
- 트래픽이 증가해서 더 많은 트래픽 처리를 위해 행할 수 있는 방식은 크게 수평적 확장과 수직적 확장이 존재한다.
- 일반적으로 애플리케이션 가용성을 위해서 수평적 확장을 더 선호한다.
- 이는 웹서버뿐 아니라 데이터베이스 또한 동일하게 적용된다.
- 웹서버는 로드밸러스를 통해, 데이터베이스는 주-부 서버를 통해서 수평적 확장된다.
4. 캐시#
- 캐시는 값비싼 연산 결과 또는 자주 참조되는 데이터를 메모리 안에 두고, 뒤 이은 요청이 보다 빨리 처리될 수 있도록 하는 저장소다.
4.1. 캐시 계층#
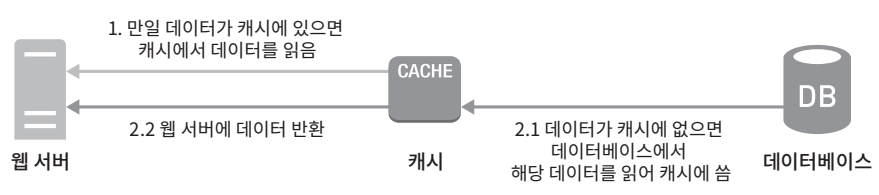
- 일반적으로 데이터베이스보다 비싸지만 훨씬 빠르다.
- 위 그림과 같이 캐시 히트된다면 캐시에서 없다면 데이터베이스에서 읽은 후 적제하는 방식을 읽기 주도형 캐시 전략이라 한다.
- 이 외 캐시할 데이터 종류, 크기, 액세스 패턴에 맞게 다른 전략을 사용할 수 있다.
4.1.1. 캐시 사용시 유의점#
- 중요한 데이터는 영속성 저장소에 저장하도록 하자
- 데이터 갱신이 빈번하지 않다면 캐시를 고려할만 하다.
- 캐시 만료 정책을 잘 마련해두어야 한다.
- 원본과의 일괄성 유지 방법에 대해서 고민해보아야 한다.
- 캐시가 단일 장애 지점이 되어버릴 가능성이 있기 때문에 이에 대한 대책을 세워야 한다.
- 캐시가 꽉차면 어떤 데이터를 방출할 것인가?
5. 콘텐츠 전송 네트워크 (CDN)#
- CDN은 정적 콘텐츠를 전송하는 데 쓰이는 지리적으로 분산된 서버의 네트워크다.
- 이미지, CSS, JS, 비디오 등을 캐시할 수 있다.
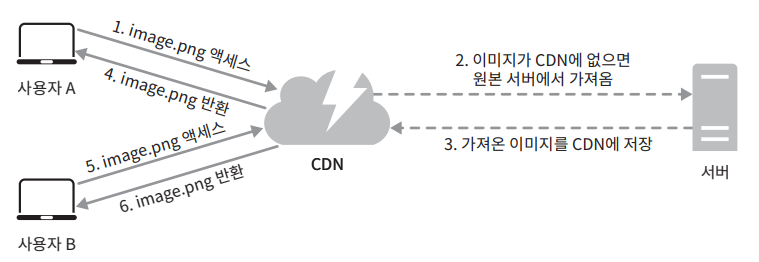
- 위 그림처럼 CDN을 통해서 대용량 이미지나 비디오 HTML 등을 보다 빠르게 로딩할 수 있다.
- 원본서버가 해저케이블을 통해서 나가야하는 위치에 있다면 상당히 오래 걸리고, 중간에 데이터가 유실될 가능성이 높다.
- 이때 CDN을 사용하면 해당 지역에 가까운 CDN을 통하기 때문에 빠르고 안정성 높게 이용할 수 있다.
5.1. 이용시 주의사항#
- 비용 - 보통 서드파티 업체가 제공하기 때문에 전송량에 따라 가격이 책정되며 도입의 이점이 크지 않다면 빼도록 하자
- 적절한 만료 시한 설정 - CDN도 캐시기 때문에 원본과 괴리가 생길 수 있어 적절한 만료 시점이 필요하다.
- CDN 장애에 대한 Failover - CDN이 죽었을 경우 어떻게 응용 프로그램이 동작할지 고려해야한다.
6. 무상태(stateless) 웹 계층#
- 상태 정보를 관계형 데이터베이스나 NoSQL 같은 지속성 저장소에 보관 후, 필요할 때 가져오도록 하는 구성을 무상태 웹 계층이라 부른다.
6.1. 상태 정보 의존적인 아키텍처#
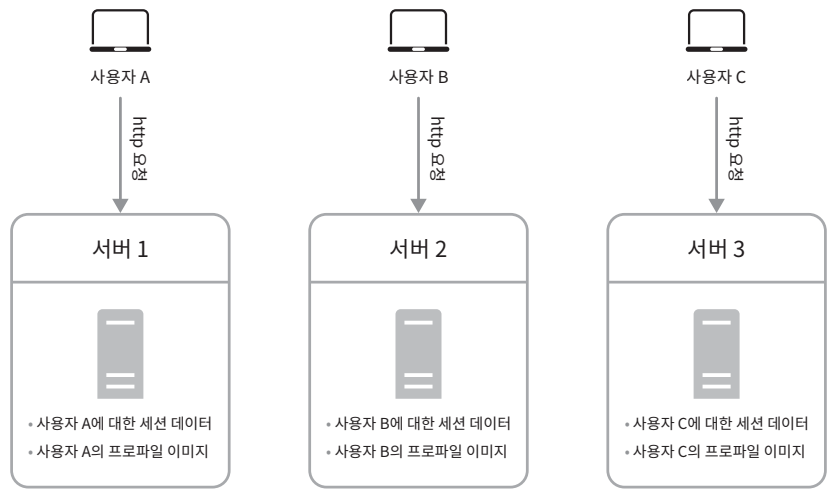
- 위 그림처럼 서버 간 상태정보가 공유되지 않고 독립적으로 가진 아키텍처가 상태정보 의존적인 아키텍처다.
- 이 경우 로드밸런서에서 Stiky Session 과 같은 기술로 특정 사용자가 마지막으로 접속한 서버에 지속적으로 연결 시켜줘야지 상태 정보를 잃어버리지 않는다.
- 그런데 이러면 로드밸런서의 이점을 잃어버리게 된다.
6.2. 무상태 아키텍처#
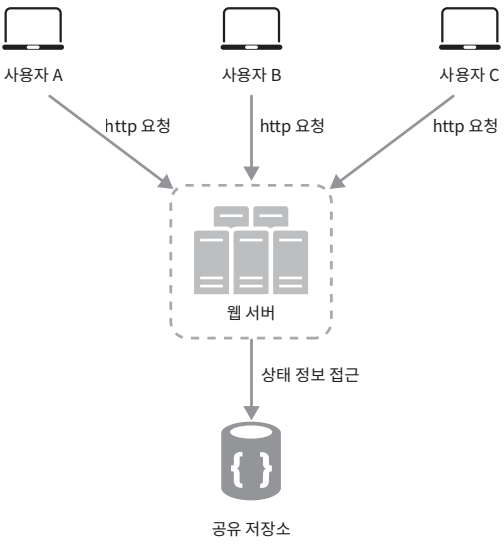
- 해당 구조로 변경된다면 고정 세션이 될 필요없이 어떤 서버에서도 동일한 상태 정보에 접근할 수 있다.
- 해당 공유 저장소는 Redis와 같은 캐시일 수도 있고, NoSQL일 수도 있다.
- NoSQL이 확장성이 좋아서 주로 쓰이는 편이다.
7. 데이터 센터#
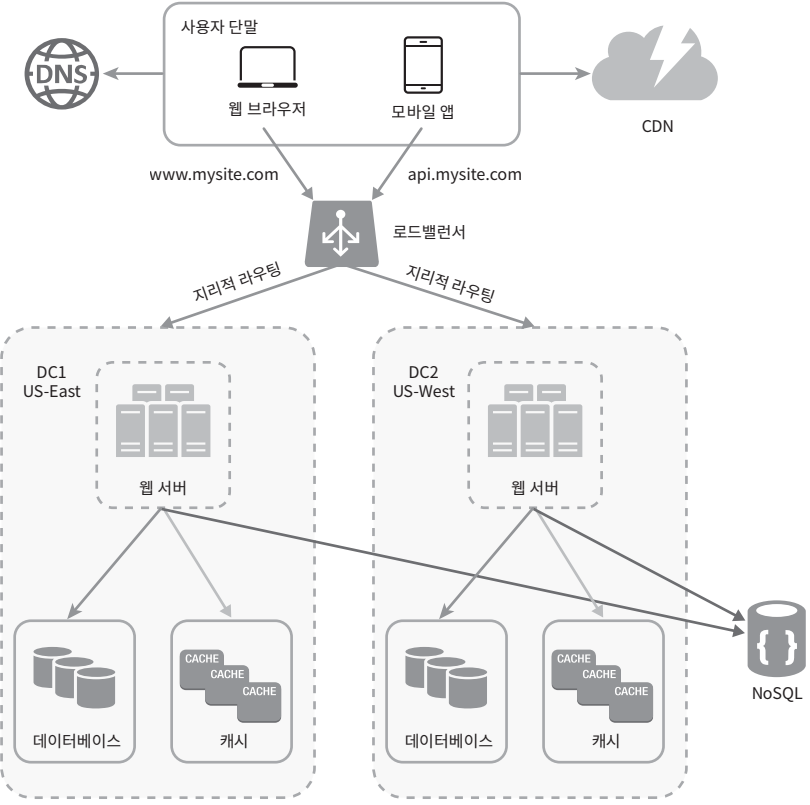
- 두 개의 데이터 센터를 로드밸런서를 통해서 묶는 방식이다.
- 일반적으로는 가까운 데이터 센터로 안내하는 지리적 라우팅 방식을 사용한다.
- 지리적 라우팅에서의 geoDNS는 사용자의 위치에 따라 도메인 이름을 어떤 IP주소로 변환할 지 결정할 수 있게 해주는 DNS서비스다.
- 만약 두 데이터 센터 중 하나가 재해나 장애가 발생할 경우 다른 쪽 데이터 센터가 모든 트래픽을 받도록 한다.
7.1. 해당 아키텍처의 기술적 난제#
- 데이터 동기화 문제
- 데이터 센터마다 독립적인 데이터베이스를 사용하고 있다면, 장애가 해소되어도 다른 센터 내 데이터베이스와 괴리가 발생할 수 있다.
- 테스트와 배포
- 어플리케이션을 다양한 위치에서 테스트 해보고 배포 도구를 통해서 일괄성있는 배포가 이뤄질 수 있도록 해야한다.
8. 메시지 큐#
- 메시지 큐는 무손실을 보정하는 비동기 통신을 지원하는 컴포넌트다.
- 버퍼 역할을 하며 비동기 적으로 전송한다.
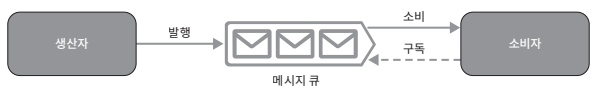
- 기본적 아키텍쳐는 간단한데 생산자가 메시지를 발행 소비자가 메시지를 구독 하는 방식으로 서비스가 느슨하게 연결되어 있다.
- 생산자는 소비자의 상태와 무관하게 메시지를 발행할 수 있고, 소비자는 언제든지 메시지를 구독/해지 할 수 있다.
9. 로그, 메트릭 그리고 자동화#
- 소규모 웹 사이트를 만들 때는 로그나 메트릭, 자동화 같은 것을 하면 좋지만 꼭 할 필요는 업었다.
- 하지만 사업 규모가 커지고 나면, 그런 도구에 필수적으로 투자해야 한다.
- 로그 - 로그를 수집해 웹 사이트에서 발생하는 오류를 모니터링 해야한다.
- 메트릭 - 트래픽, 서버의 하드웨어적 상태, 가상 프로세서의 상태 등을 수집할 수 있으며 수집된 데이터는 유용하게 사용할 수 있다.
- 자동화 - 시스템이 크고 복잡해지면 생산성을 높이기 위해 자동화 도구를 활용해야 한다.
- 코드 검증 절차의 자동화
- 빌드, 테스트, 배포 등의 자동화
10. 데이터베이스의 규모 확장#
- 저장할 데이터가 많아지면 데이터베이스에 대한 부하도 증가한다.
- 이때 데이터베이스의 증설 방법을 찾아봐야한다.
10.1. 수직적 확장#
- 스케일 업이라고도 부르는 수직적 규모 확장법은 기존 서버에 더 많은, 또는 고성능의 자원을 증설하는 방법
- 증설에는 한계가 있으므로 CPU, RAM 등을 무한으로 증설할 수는 없다.
- SPOF로 인한 위험성이 크다.
- 비용이 많이 든다. 고성능 서버로 갈수록 가격이 올라가게 마련이다.
10.2. 수평적 확장#
- 데이터베이스의 수평적 확장은 샤딩이라고도 부르는데, 더 많은 서버를 추가함으로써 성능을 향상시킬 수 있도록 한다.
- 샤딩은 샤드라고 부르는 작은 단위로 분할하는 기술을 일컫는데, 모든 샤드는 같은 스키마를 쓰지만 샤드에 보관되는 데이터 사이에는 중복이 없다.
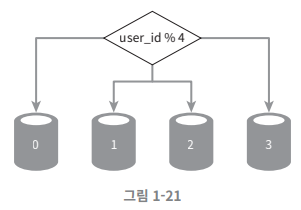
- 가장 단순하게 샤딩하는 방법으로써 해당 그림처럼 진행할 수 있다.
- 하나의 샤드는 각각 하드웨어적으로 독립되어 있어서 보다 빠르게 CURD를 할 수 있다.
10.2.1. 샤딩을 도입하면 풀어야할 문제#
- 데이터의 재 샤딩
- 재 샤딩은 다음 경우에 필요하다.
- 데이터가 너무 많아져서 하나의 샤드로는 더 이상 감당하기 어려울 때
- 샤드 간 데이터 분포가 균등하지 못하여 어떤 샤드에 할당된 공간 소모가 다른 샤드에 비해 빨리 진행될 때
- 샤드 소진이라고도 부르는 이런 현상이 발생하면 샤드 키 계산 함수를 변경하고 데이터를 재배치 하여야 한다.
- 유명인사(celebrity) 문제
- 핫스팟 키 문제라고도 하는데, 특정 샤드에 질의가 집중되어 서버에 과부하가 걸리는 문제다.
- 이 문제를 풀려면 유명인사 각각에 샤드 하나씩을 할당해야 할 수도 있고, 심지어 더 잘게 쪼개야할 수 있다.
- 조인과 비 정규화
- 일단 하나의 데이터베이스를 여러 샤드 서버로 쪼개고 나면, 여러 샤드에 걸친 데이터를 조인하기 힘들어진다.
- 데이터베이스를 비정규화 하여 하나의 테이블에서 질의가 수행되도록 한다.