13장 - 검색어 자동완성 시스템
- 태그
- Interview
- 생성일
- 2024년 7월 23일 AM 12:12
1. 문제 이해 및 설계 범위 확정#
1.1. 요구사항#
- 빠른 응답 속도
- 시스템 응답속도는 100밀리초 이내여야 한다.
- 연관성
- 자동완성 검색어는 입력한 단어와 연관되어야 한다.
- 정렬
- 계산 결과는 인기도 등의 순위 모델에 의해 정렬되어야 한다.
- 규모 확장성
- 많은 트래픽을 감당할 수 있도록 확장 가능해야 한다.
- 고가용성
- 시스템 일부에 장애, 예상치 못한 문제가 생겨도 계속 사용 가능해야 한다.
1.2. 개략적 규모 추정#
- 일간 능동 사용자(DAU)는 천만 명으로 가정
- 평균적으로 한 사용자는 매일 10건의 검색을 수행한다고 가정
- 질의할 때마다 평균적으로 20바이트의 데이터를 입력한다고 가정
- ASCII를 사용한다고 가정하면, 1 문자 = 1 바이트
- 질의문은 평균적으로 4단어, 각 단어는 평균적으로 5글자로 구성된다고 가정하면질의당 평균 20바이트 이다.
- 평균적으로 1회 검색당 20건의 요청이 백엔드로 전달된다.
- 대략 초당 24,000건의 질의(QPS)가 발생할 것이다.
- 천만 사용자 x 10질의 x 20자 / 24시간 / 3600초 = 24,000
- 최대 QPS = QPS x 2 = 대략 48,000
- 질의 가운데 20%는 신규 검색어라고 가정하면…
- 천만 사용자 x 10질의 / 일 x 20자 x 20% = 대략 0.4GB
- 매일 0.4GB의 신규 데이터가 시스템에 추가된다.
2. 개략적 설계안 제시 및 동의 구하기#
개략적으로 보면 시스템은 두 부분으로 나뉜다.
- 데이터 수집 서비스 : 사용자가 입력한 질의를 실시간으로 수집하는 시스템
- 질의 서비스 : 주어진 질의에 다섯 개의 인기 검색어를 정렬해서 내놓는 서비스
2.1. 데이터 수집 서비스#
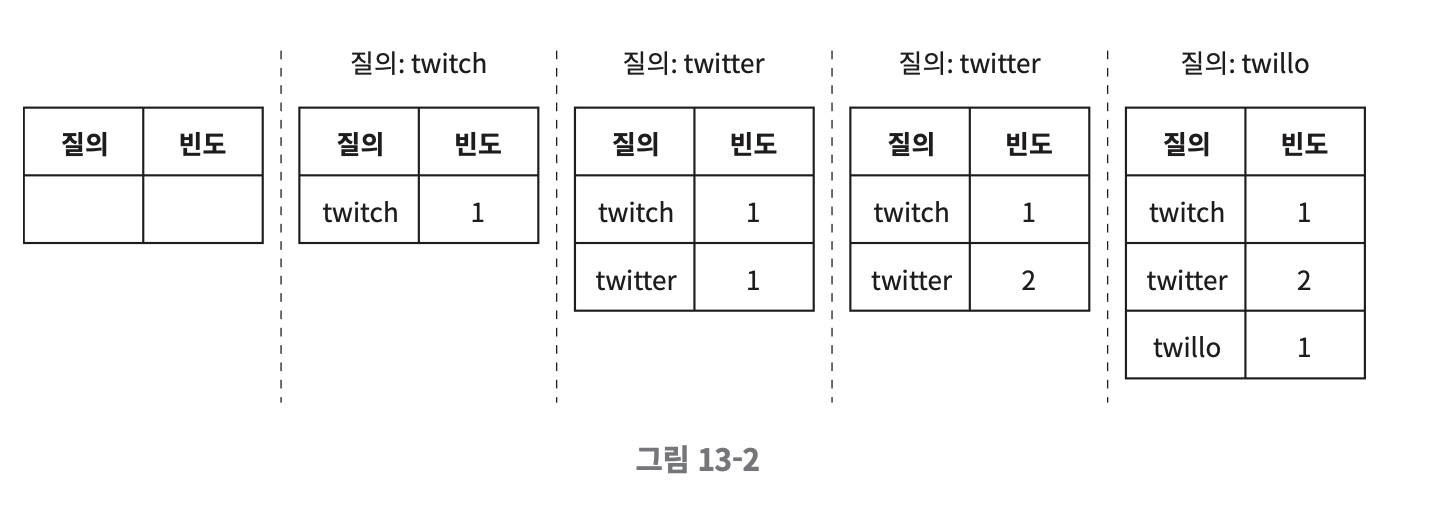
- 사용자가 많이 검색한 검색어를 빈도 위주로 추천한다.
- 데이터양이 적을 때는 나쁘지 않은 설계다.
3. 상세 설계#
3.1. 트라이 자료구조#
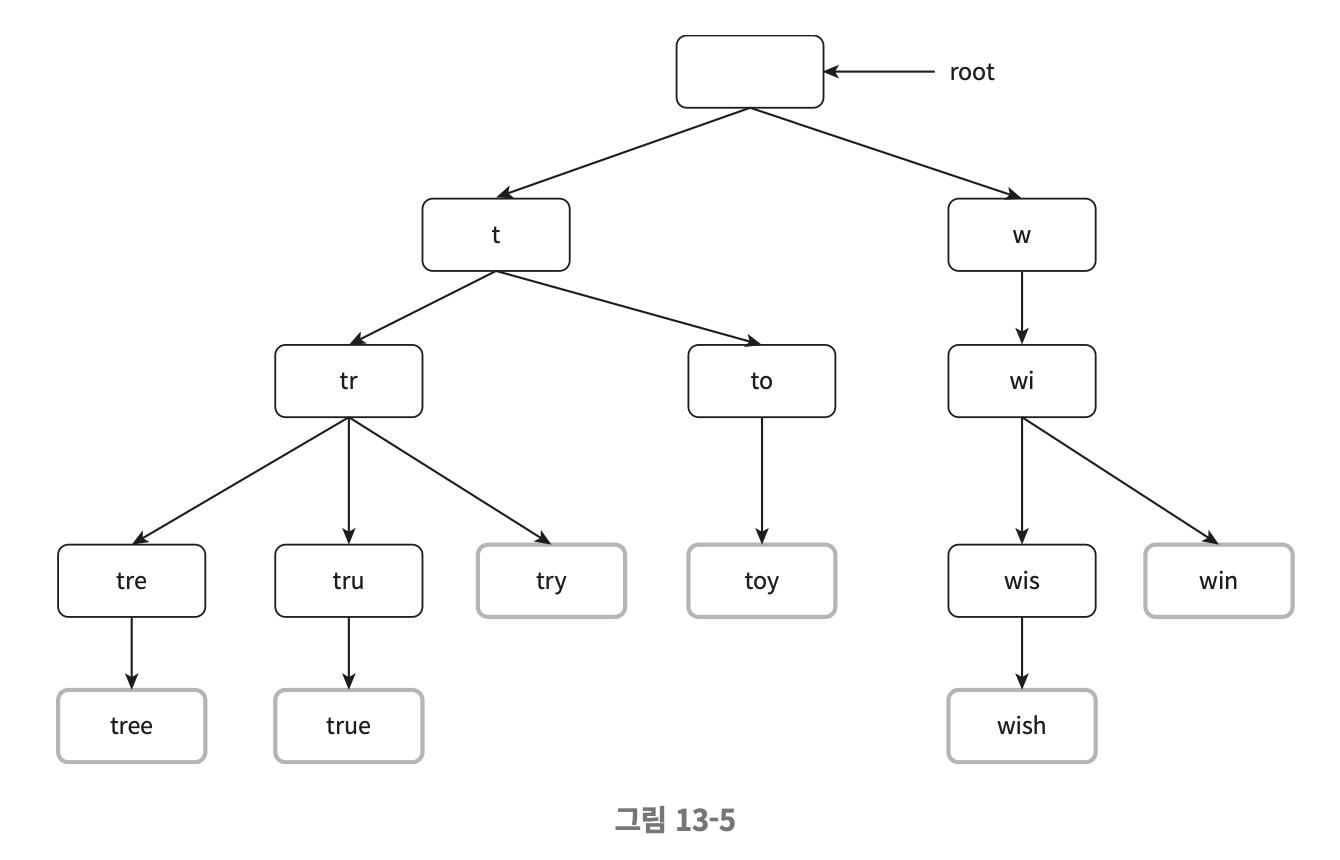
- 트리 형태의 자료구조
- 루트 노드는 빈 문자열을 나타냄
- 각 노드는 글자 하나를 저장하며 26개의 자식 노드를 가질 수 있음
- 각 트리 노드는 하나의 단어, 또는 접두어 문자열을 나타냄
- 용어 정의
- p: 접두어(prefix)의 길이
- n: 트라이 안에 있는 노드 개수
- c: 주어진 노드의 자식 노드 개수
- 가장 많이 사용된 질의어 k개는 다음과 같이 찾을 수 있다.
- 해당 접두어를 표현하는 노드를 찾는다. 시간복잡도 O(p)
- 해당 노드부터 시작하는 하위 트리를 탐색하여 모든 유효 노드를 찾는다. 시간복잡도 O(c)
- 유효 노드들을 정렬하여 가장 인기 있는 검색어 k개를 찾는다. 시간복잡도 O(clogc)
- 전체 알고리즘 복잡도 = O(p) + O(c) + O(clogc)
- 직관적 알고리즘이지만 최악의 경우 전체 트라이를 다 검색해야할 수 있다.
- 해결 방법 2가지
- 접두어의 최대길이 제한
- 각 노드에 인기 검색어 캐시
3.1.1. 접두어 최대 길이 제한#
- 사용자가 긴 검색어를 입력하는 일은 거의 없다
- p값을 작은 정숫값이라고 가정해도 안전하다.
- 접두어 노드를 찾는 시간 복잡도 = O(p) = O(작은 정숫값) = O(1)이 된다.
3.1.2. 노드에 인기 검색어 캐시#
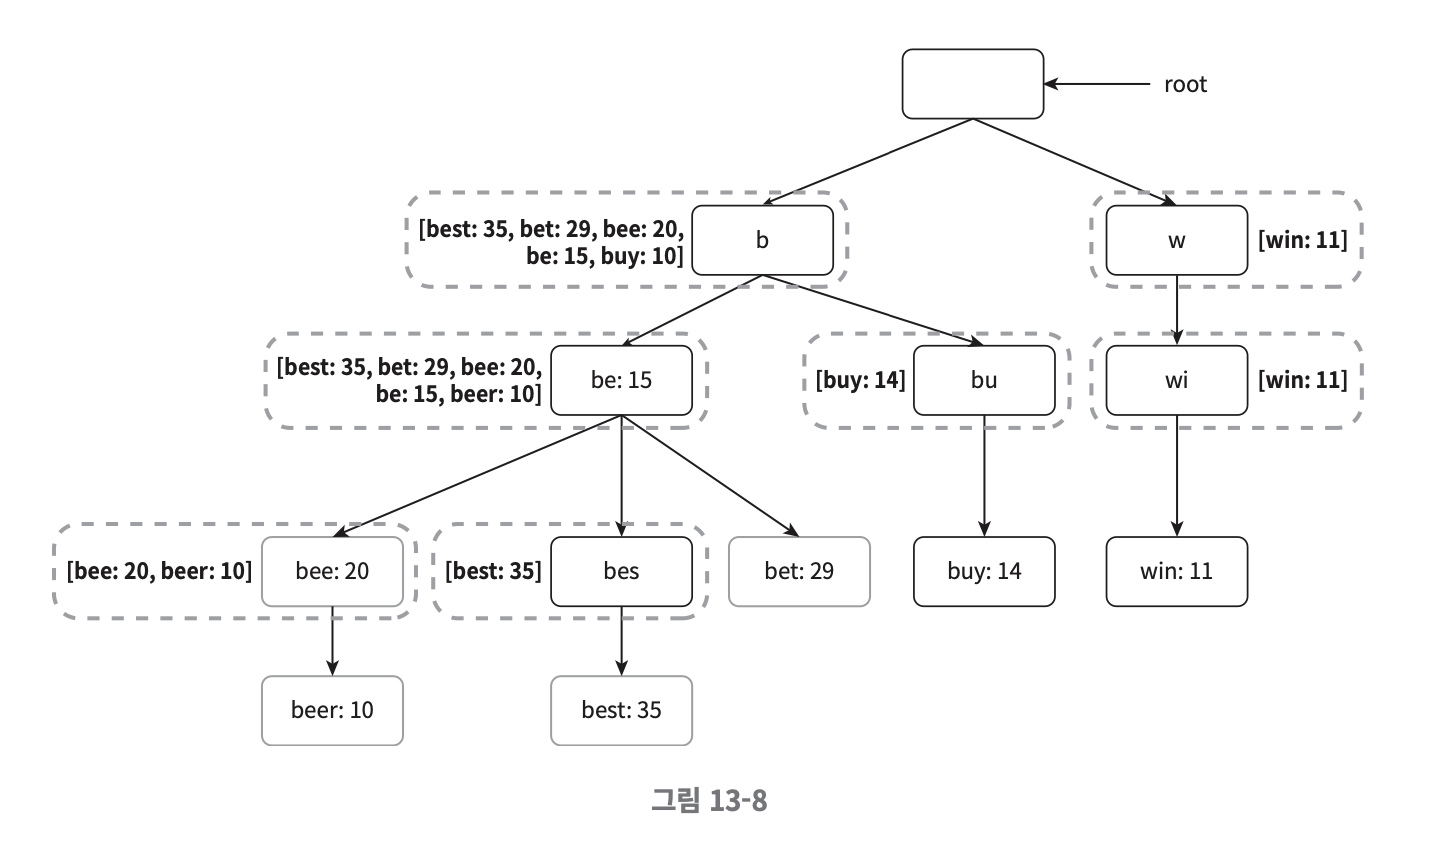
- 각 노드에 k개의 인기 검색어를 저장해 두면 전체 트라이를 검색하는 일을 방지할 수 있다.
- 각 단계의 시간 복잡도가 O(1)로 바뀐 덕분에 최고 인기 검색어 k개를 찾는 전체 알고리즘의 복잡도도 O(1)로 바뀌게 된다.
3.1.3. 데이터 수집 서비스#
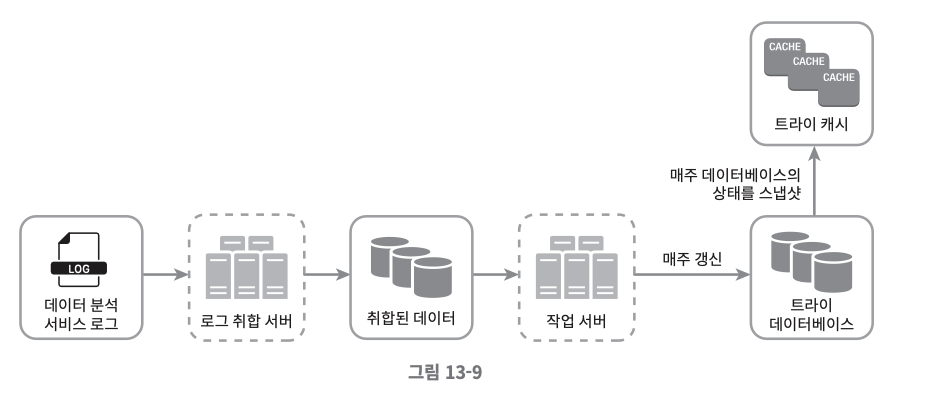
- 매일 수천만 건의 질의가 입력될 텐데 그때마다 트라이를 갱신하면 질의 서비스는 심각하게 느려질 것이다.
- 일단 트라이가 만들어지고 나면 인기 검색어는 그다지 자주 바뀌지 않을 것이기 때문에 자주 갱신할 필요가 없다.
- 트라이를 만드는데 쓰이는 데 쓰는 데이터는 보통 데이터 분석 서비스나 로깅 서비스로부터 올 것이다.
3.1.4. 데이터 분석 서비스 로그#
- 검색창에 입력된 질의에 관한 원본 데이터가 보관된다.
- 새로운 데이터가 추가될 뿐 수정은 이뤄지지 않으며 로그 데이터에는 인덱스를 걸지 않는다.
3.1.5. 로그 취합 서버#
- 데이터 분석 서비스로부터 나오는 로그는 보통 그 양이 엄청나고 데이터 형식이 제각각인 경우가 많음
- 이 데이터를 잘 취합하여 우리 시스템에서 소비할 수 있도록 해야한다.
- 데이터 취합 방식은 우리 서비스의 용례에 따라 달라질 수 있다.
- 데이터 취합이 빠른 경우도 있지만 대부분 일주일에 한번 정도로 충분하다.
3.1.6. 작업 서버#
- 주기적으로 비동기적 작업을 실행하는 서버 집합
- 트라이를 만들고 데이터베이스에 저장하는 역할
3.1.7. 트라이 캐시#
- 매주 데이터베이스의 스냅샷을 떠서 갱신한다.
3.1.8. 트라이 데이터베이스#
- 트라이 데이터베이스로 사용할 수 있는 선택지는
- 문서 저장소
- 새 트라이를 매주 만들 것이므로 주기적으로 트라이를 직렬화하여 데이터베이스에 저장할 수 있음
- 몽고디비 같은 문서 저장소를 활용 가능
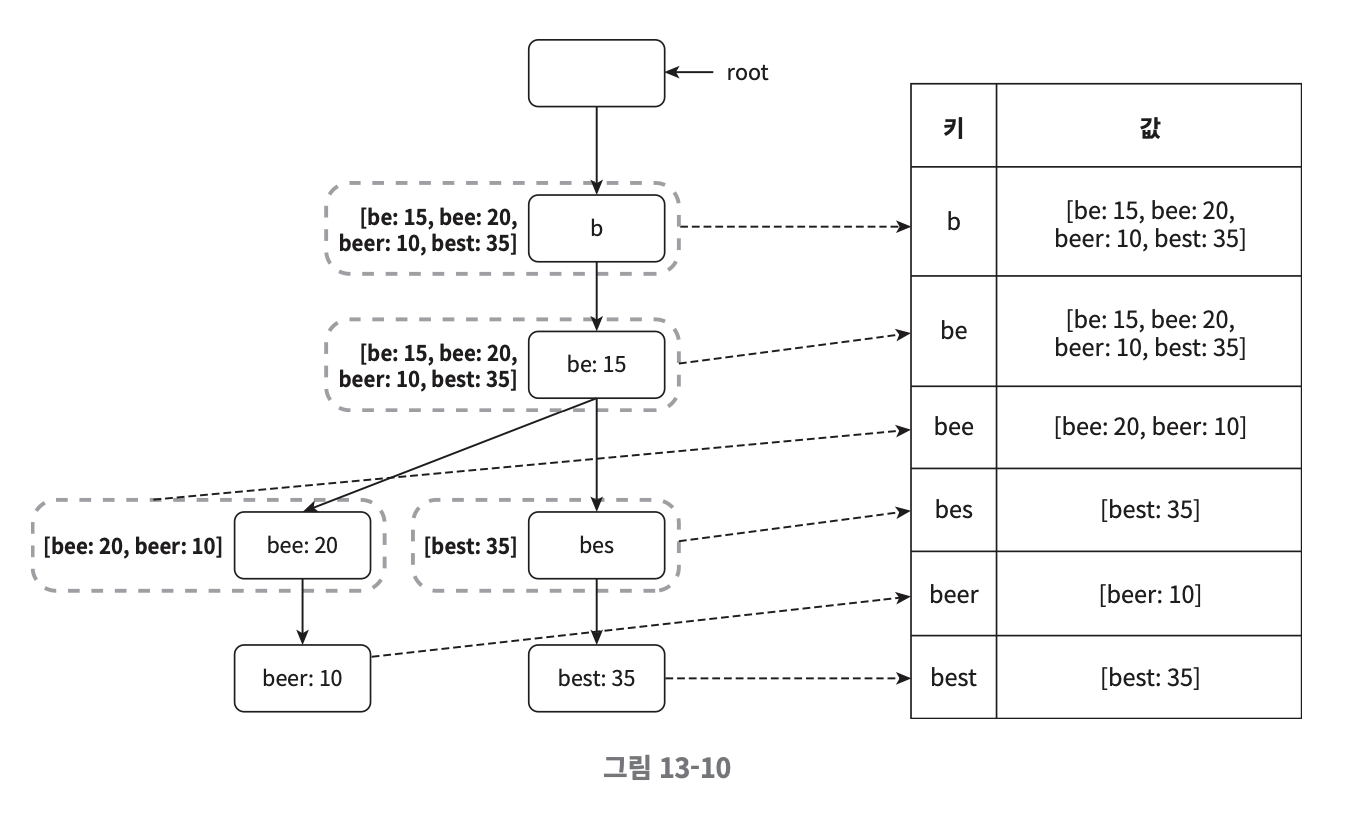
- 키-값 저장소
- 해시 테이블 형태로 변환 가능
- 트라이에 보관된 모든 접두어를 해시 테이블 키로 변환
- 각 트라이 노드에 보관된 모든 데이터를 해시 테이블 값을 변환
3.1.9. 질의 서비스#
- 검색 질의가 로드밸런서로 전송
- 로드밸런서는 해당 질의를 API 서버로 전달
- API 서버는 트라이 캐시에서 데이터를 가져와 자동완성 검색어 제안 응답을 구성
- 데이터가 트라이 캐시에 없는 경우 트라이 데이터베이스에서 가져와 캐시에 채움
- 질의 서비스는 번개같이 빨라야 하는데 이를 위한 최적화 방법은 다음과 같다
- AJAX 요청
- 요청을 보내고 받기 위해 페이지를 새로고침 할 필요가 없다.
- 브라우저 캐싱
- 제안된 검색어들을 브라우저 캐시에 넣어두면 후속 질의의 결과는 해당 캐시에서 바로 가져갈 수 있다.
- 데이터 샘플링
- 모든 질의 결과를 로깅하도록 하면 CPU 자원과 저장공간을 많이 소진하게 된다.데이터 샘플링 기법은 N개 요청 가운데 1개만 로깅하도록 하는 것.
3.2. 트라이연산#
3.2.1. 트라이 생성#
- 트라이 생성은 작업 서버가 담당하며, 데이터 분석 서비스의 로그나 데이터베이스로부터 취합된 데이터를 이용한다.
3.2.2. 트라이 갱신#
- 매주 한 번 갱신하는 방법
- 새로운 트라이를 만든 다음 기존 트라이를 대체한다.
- 트라이의 각 노드를 개별적으로 갱신하는 방법
- 성능이 좋지 않다.
- 트라이가 작을때는 고려해봄직한 방안.
3.2.3. 검색어 삭제#
- 혐오성, 폭력적 등.. 여러 가지로 위험한 질의어를 자동완성 결과에서 제거해야 한다.
- 트라이 캐시 앞에 필터 계층을 두고 부적절한 질의어가 반환되지 않도록 할 수 있음.
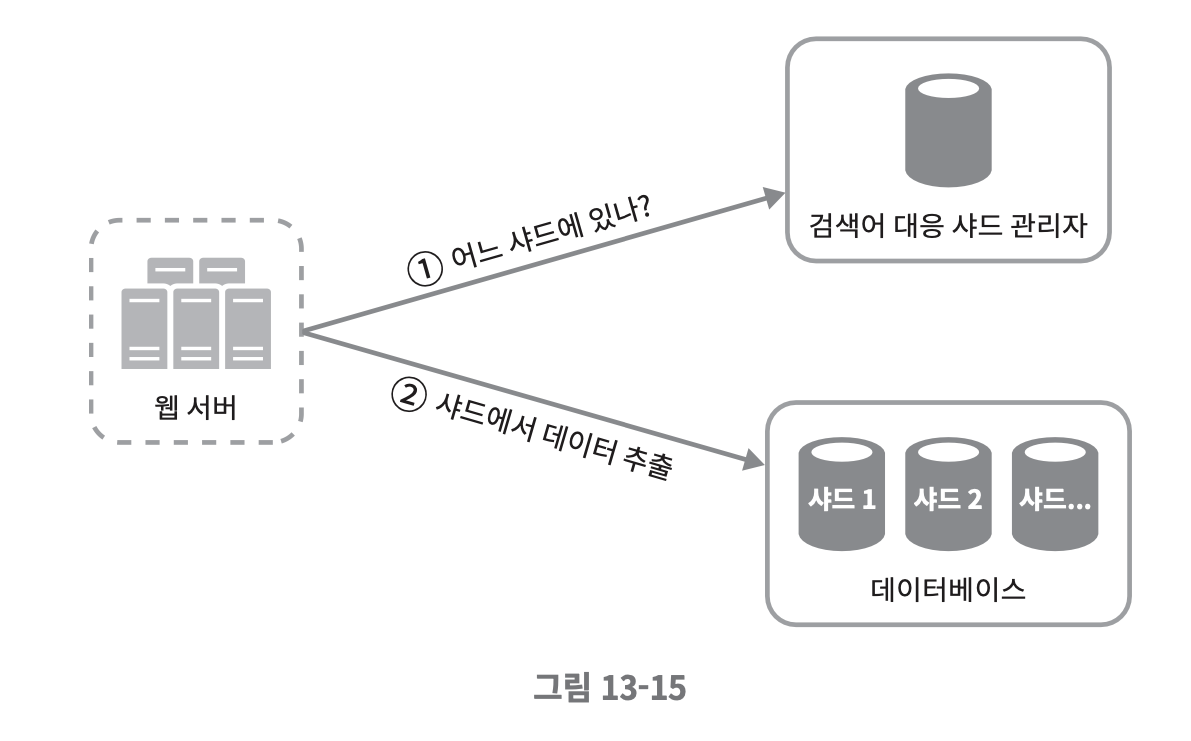
3.3. 저장소 규모 확장#
- 검색어 보관을 위해 두 대 서버가 필요하다면, a-z라면 첫 서버에 나머지는 두 번째 서버에 저장한다.
- 세 대 서버가 필요하다면 a-i까지는 첫 서버에 j-r까지는 두 번째에, 나머지는 세번째에 저장한다.
- 이 방법은 최대 26대로 제한된다.
- 이 이상으로 수를 늘리려면 샤딩을 해야한다.
- a 시작 서버에 aa로 시작하는 데이터는 다른곳에 저장되도록 이런식으로
- 그런데 데이터를 균등하게 저장하는건 어려운일이다.
- 과거 질의 데이터의 패턴을 분석하여 샤딩하는 방법을 사용한다.