4장 - 처리율 제한 장치의 설계
- 태그
- Interview
- 생성일
- 2024년 7월 7일 PM 8:21
1. 개요#
- 처리율 제한 장치가 필요한 이유
- DoS 공격에 의한 자원고갈을 방지할 수 있다.
- 추가 요청 처리를 제한하면 서버를 많이 두지않아도 되어 비용을 절감할 수 있다.
- 서버 과부하를 막는다.
2. 문제 이해 및 설계 범위 확정#
- 처리율 제한 장치를 구현하는 데는 여러 알고리즘을 사용 가능하며 각각 고유한 장단점을 갖고 있다.
- 소통하며 어떤 제한 장치를 구현해야 하는지 확인하자
- 요구사항
- 설정된 처리율을 초과하는 요청은 정확하게 제한한다.
- 낮은 응답시간 : 이 처리율 제한 장치는 HTTP 응답시간에 나쁜 영향을 주어서는 곤란하다.
- 가능한 한 적은 메모리를 써야 한다.
- 분산형 처리율 제한 : 하나의 처리율 제한 장치를 여러 서버나 프로세스에서 공유할 수 있어야 한다.
- 예외 처리 : 요청이 제한되었을 때는 그 사실을 사용자에게 분명하게 보여주어야 한다.
- 높은 결함 감내성 : 제한 장치에 장애가 생기더라도 전체 시스템에 영향을 주어서는 안 된다.
3. 개략적 설계안 제시 및 동의 구하기#
처리율 제한 장치는 어디에 둘 것인가?#
- 직관적으로 보면 장치는 클라이언트나 서버에 둘 수 있다.
- 클라이언트에 둔다면?
- 일반적으로 클라이언트 처리율 제한을 안정적으로 걸 수 있는 장소가 못된다.
- 클라이언트는 위변조가 쉽기 때문이다.
- 서버에 둔다면?
- 처리율 제한 장치를 API서버에 두거나 미들웨어를 통해서 제한할 수 있다.
- 너무 많은 요청을 보내면 429 HTTP StatusCode를 전달할 것이다.
- 마이크로서비스의 경우 처리율 제한 장치는 API-Gateway 컴포넌트에 구현된다.
- 이는 SSL 종단, 사용자 인증, IP 허용 목록 관리 등을 지원하는 Fully Managed Service다.
- 일단 처리율 제한 장치를 지원하는 미들웨어로 인식하자
- 처리율 제한 기능을 설계할 때 중요하게 따져야 하는 것은 엔지니어링 인력, 우선순위, 목표에 따라 달라질 수 있다.
- 현재 기술 스택에 지원하기 충분할 정도로 효율이 나오는가?
- 적절한 제한 알고리즘을 찾아서 적용하라
- MSA를 사용한다면 API 게이트웨이에 처리율 제한 기능도 포함시켜야할 수 있다.
- 처리율 제한 장치는 직접 만드는데 시간이 든다.
- 인력이 부족하다면 사용 API 게이트웨이를 쓰는게 바람직하다.
3.1. 처리율 제한 알고리즘#
- 일반적으로 처리율 제한 알고리즘에 널리 쓰이는 알고리즘들을 소개한다.
3.1.1. 토큰 버킷 알고리즘 (token bucket)#
- 처리율 제한에 폭넓게 사용되는 알고리즘으로 간단하고, 세간의 이해도가 높으며 인지도 있는 기업이 사용하고 있다.
- 동작 원리는 다음과 같다.
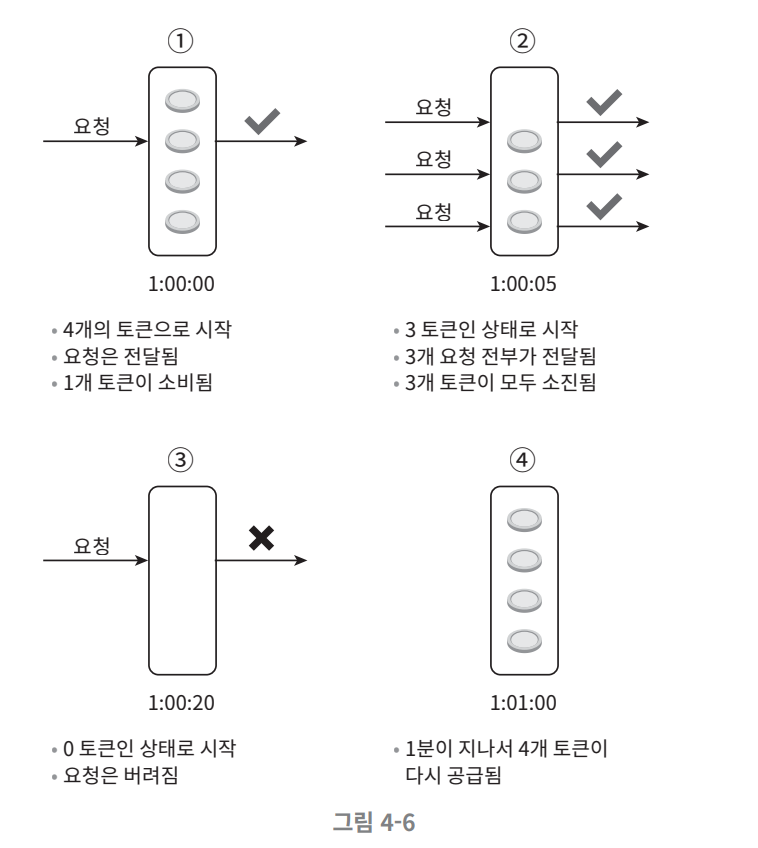
- 토큰 버킷은 지정된 용량을 갖는 컨테이너로 사전 설정된 양의 토큰이 주기적으로 채워진다.
- 토큰 공급기는 매초 2개의 토큰을 추가한다.
- 버킷이 가득 차면 추가로 공급된 토큰은 버려진다.
- 각 요청이 처리될 때마다 하나의 토큰을 사용하며 요청이 도착하면 버킷에 토큰이 있는지 검사한다.
- 요청이 있다면 토큰이 소모되고 없다면 요청이 버려진다.
- 토큰 버킷 알고리즘은 2개의 인자를 받는다.
- 버킷 크기 : 버킷에 담을 수 있는 토큰의 최대 개수
- 토큰 공급률 : 초당 몇 개의 토큰이 버킷에 공급되는가
- 시스템 요구사항에 따라 버킷을 어찌 둘지 결정할 수 있다.
- 사용자마다 요청제한이 존재한다면, 사용자마다 버킷을 할당해야 한다.
- IP 주소별로 제한이 필요하다면 IP 주소마다 버킷을 할당해야 한다.
- 초당 처리율로 제한한다면 모든 사용자가 버킷을 공유하도록 해야한다.
장점
- 구현이 쉽다.
- 메모리 사용 측면에서도 효율적이다.
- 짧은 시간에 집중되는 트래픽도 처리 가능하다.
단점
- 버킷 크기와 토큰 공급률 두 인자를 가지고 있는데, 두 값을 적절히 튜닝하는게 까다로울 수 있다.
3.1.2. 누출 버킷 알고리즘#
- 누출 버킷은 토큰 버킷과 비슷하지만 요청 처리율이 고정되어 있다는 점이 다르다.
- 누출 버킷은 요청 처리율이 고정되어 있다.
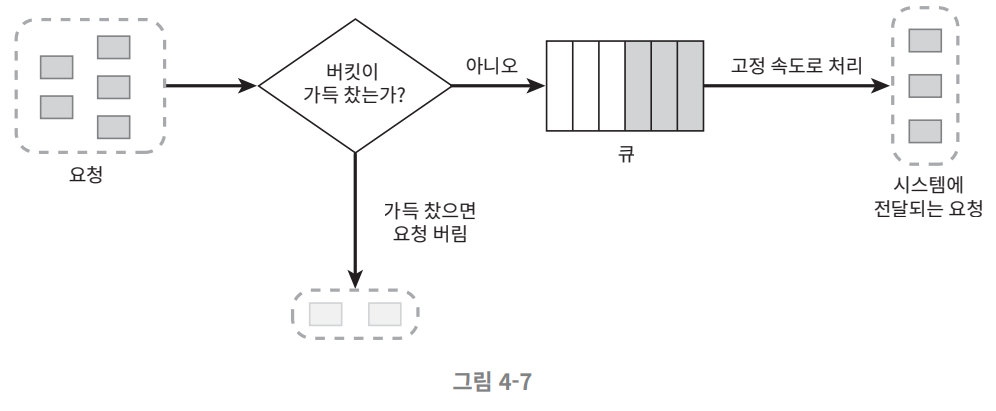
- 누출 버킷은 보통 FIFO 큐로 구현한다.
동작 원리
- 요청이 도착하면 큐가 가득 차 있는지 본다.
- 빈자리가 있는 경우 큐에 요청을 추가한다.
- 큐가 가득 차 있는 경우 새 요청을 버린다.
- 지정된 시간마다 큐에서 요청을 꺼내어 처리한다.
- 누축 버킷 알고리즘이 가지는 인자값
- 버킷 크기 : 큐 사이즈로 몇 개의 항목을 처리할지 지정하는 값
- 처리율 : 지정된 시간당 몇 개의 항목을 처리할지 정하는 값
장점
- 큐의 크기가 제한되어 있어 메모리 사용량 측면에서 효율적이다.
- 고정된 처리율을 갖고 있기 때문에 안정적 출력이 필요한 경우에 적합하다.
단점
- 단시간에 많은 트래픽이 몰리는 경우 큐에는 오래된 요청들이 쌓이게 되고, 그 요청들을 제때 처리 못하면 최신 요청들은 버려지게 된다.
- 올바르게 튜닝하기 어려울 수 있다.
3.1.3. 고정 윈도 카운터 알고리즘#
동작 원리
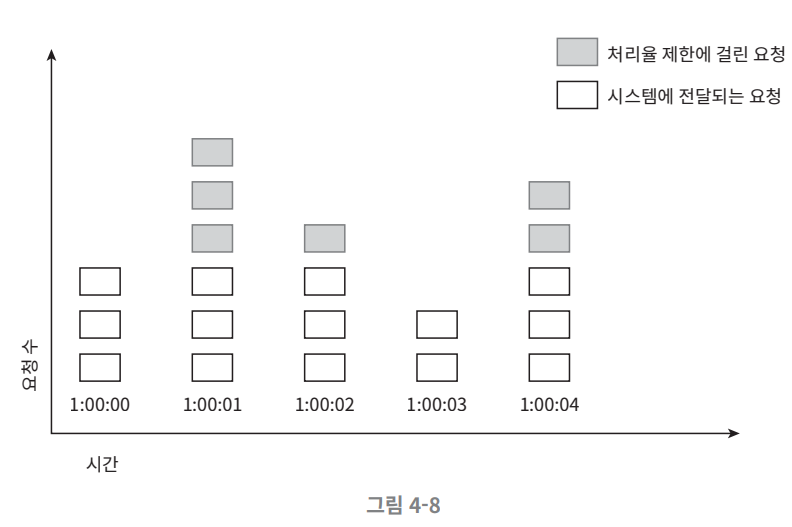
- 타임라인을 고정된 간격의 윈도로 나누고, 각 윈도마다 카운터를 붙인다.
- 요청이 접수될 때마다 이 카운터의 값은 1씩 증가한다.
- 이 카운터의 값이 사전에 설정된 임계치에 도달하면 새로운 요청은 새 윈도가 열릴 때까지 버려진다.
장점
- 메모리 효율이 좋다.
- 이해하기 쉽다.
- 윈도가 닫히는 시점에 카운터를 초기화하는 방식은 특정한 트래픽 패턴을 처리하기에 적합하다.
단점
- 윈도의 경계 부근에 순간적으로 많은 트래픽이 집중될 경우 윈도에 할당된 양보다 더 많은 요청이 처리될 수 있다는 점이다.
3.1.4. 이동 윈도 로깅 알고리즘#
동작 원리
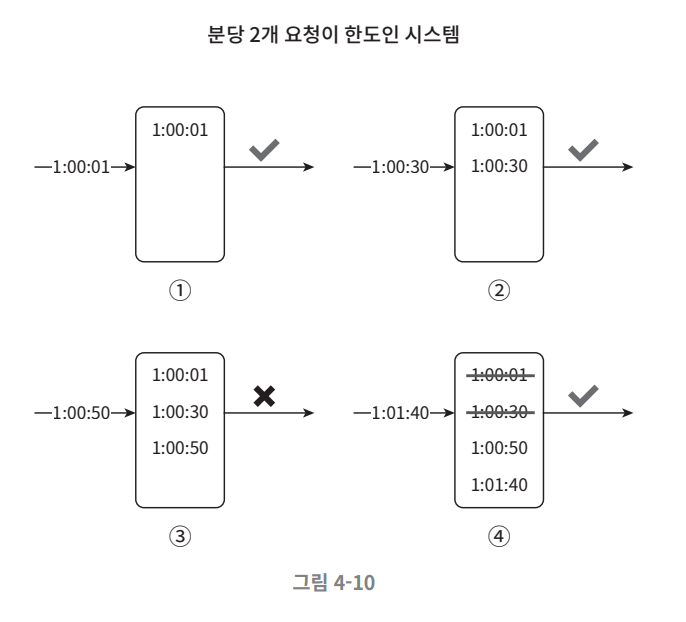
- 타임스탬프를 추적하는 알고리즘으로 타임스탬프 데이터는 보통 레디스의 sorted set 같은 캐시에 보관한다.
- 새 요청이 오면 만료된 타임스탬프는 제거한다.
- 새 요청의 타음스탬프를 로그에 추가한다.
- 로그의 크기가 허용치보다 같거나 작으면 시스템에 전달하며 허용치보다 크면 처리를 거부한다.
장점
- 처리율 제한 메커니즘이 매우 정교하다.
- 어느 순간의 윈도를 보더라도 처리율 한도를 넘지 않는다.
단점
- 거부된 요청의 타임스탬프도 보관하기 때문에 메모리를 많이 사용한다.
3.1.5. 이동 윈도 카운터 알고리즘#
- 앞서 두 알고리즘을 결합한 형태의 알고리즘이다.
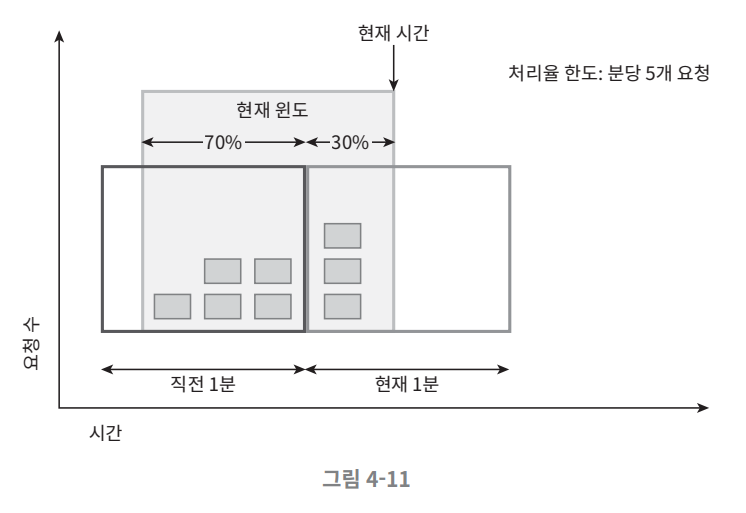
동작 원리
- 현재 1분간의 요청 수+직전 1분간의 요청 수X이동 윈도와 직전 1분이 겹치는 비율
장점
- 이전 시간대의 평균 처리율에 따라 현재 윈도의 상태를 계산하므로 짧은 시간에 몰리는 트래픽 대응에 용이하다.
- 메모리 효율이 좋다.
단점
- 직전 시간대에 도착한 요청이 균등하게 분포되어 있다고 가정
- 따라서 추정치를 계산하기 때문에 100% 정확하지는 않다.
- 하지만 클라우드플레어에서 수행한 실험에 의하면 오탐은 0.003% 에 불과했다고한다.
4. 상세 설계#
4.1. 처리율 제한 규칙#
- 리프트(Lyft)는 처리율 제한에 오픈소스를 사용한다.
yaml
domain: messaging
descriptors:
	- key: message_type
		Value: marketing
		rate_limit:
			unit: day
request_per_unit: 5yaml
domain: auth
descriptors:
	- key: auth_type
		Value: login
		rate_limit:
			unit: minute
request_per_unit: 54.2. 처리율 한도 초과 트래픽 처리#
- 처리율 제한 장치는 HTTP 헤더를 통해서 클라이언트에게 보낸다.
- X-Ratelimit-Remaining: 윈도 내에 남은 처리 가능 요청의 수
- X-Ratelimit-Limit: 매 윈도마다 클라이언트가 전송할 수 있는 요청의 수
- X-Ratelimit-Retry-After: 한도 제한에 걸리지 않으려면 몇 초 뒤에 요청을 다시 보내야 하는지 알림
4.3. 분산 환경에서 처리율 제한 장치의 구현#
- 분산 환경에서는 소개하는 두 가지 문제를 풀어야 한다.
4.3.1. 경쟁 조건#
- 병렬로 하나의 값을 갱신할 경우 읽는 시점과 갱신하는 시점간의 괴리가 발생하여 원치않는 동작이 일어날 수 있음
- 책에서 소개한 해소 방법으로는 루아 스크립트를 이용하는 방법과 정렬 집합을 이용하는 방법을 소개함
4.3.2. 동기화#
- 수백만의 사용자를 지원하려면 한 대의 처리율 제한 장치 서버로는 충분하지 않을 수 있다.
- 때문에 여러대의 처리율 제한 장치 서버를 사용할 수 있다.
- 이때 제한 장치 서버간 동기화를 진행해야 한다.
- Sticky session을 통해서 문제 해결도 가능하지만, 유연하지 않은 방법이여서 추천되지 않는다.
- 중앙 집중형 데이터 저장소를 사용해서 이 동기화 문제를 해결하는게 권장되는 방법이다.
4.3.3. 성능 최적화#
- 데이터 센터가 멀리 떨어져 있으면 레이턴시가 증가한다.
- 에지 서버를 사용해서 이를 해결하자
- 데이터를 동기화할 경우 최종 일관성 모델을 사용하자.
5. 마무리#
- 경성 처리율 제한 = 요청의 개수는 임계치를 절대 넘어설 수 없다.
- 연성 처리율 제한 = 요청 개수는 잠시 동안은 임계치를 넘어설 수 있다.
- 처리율 제한 회피 방법
- 클라이언트 측 캐시를 사용해 API 호출 횟수를 줄인다.
- 처리율 제한의 임계치를 이해하고, 짧은 시간 동안 너무 많은 메시지를 보내지 않도록 한다.
- 예외나 에러 처리하는 코드를 도입해 예외적 상황을 우아하게 복구될 수 있도록 하자
- 재시도 로직을 구현할 때는 충분한 백오프 시간을 둔다.