6장 - 키/값 저장소 설계
- 태그
- Interview
- 생성일
- 2024년 7월 9일 AM 12:38
1. 개요#
- 키-값 저장소는 비 관계형 데이터베이스다.
- 키-값 쌍에서의 키는 유일해야 하며 키에 매달린 값은 키를 통해서만 접근할 수 있다.
- 키는 일반 텍스트 혹은 해시 값일 수도 있다.
- 성능상의 이유로 키는 짧은수록 좋다.
- 값의 경우 텍스트, 리스트, 오브젝트일 수 있다.
2. 문제 이해 및 설계 범위 확정#
- 키-값 쌍의 크기는 10KB 이하다.
- 큰 데이터를 저장할 수 있어야 한다.
- 높은 가용성을 제공해야 한다.
- 장애가 있더라도 빠르게 응답해야한다.
- 높은 규모 확장성을 제공해야 한다.
- 동적으로 서버의 증설/삭제가 이뤄져야 한다.
- 데이터 일관성 수준은 조정이 가능해야 한다.
- 응답 지연시간이 짧아야 한다.
3. 단일 서버 키-값 저장소#
- 한 대 서버만 사용하는 키-값 저장소를 설계하는 것은 쉽다.
- 직관적인 방법은 키-값 쌍 전부를 메모리에 해시 테이블로 저장하는 것이다.
- 접근 속도는 빠르지만, 메모리안에 두는게 불안하다.
- 이 문제의 개선책
- 데이터 압축
- 자주 쓰이는 데이터만 메모리에 두고 나머지는 디스크 저장
4. 분산 키-값 저장소#
- 분산 시스템을 설계할 때는 CAP 정리를 이애하고 있어야 한다.
4.1. CAP정리#
- CAP 정리란?
- Consistency(일관성)
- 분산 시스템에 접속하는 모든 클라이어트는 어떤 노드에 접속했느냐에 관계 없이 언제나 같은 정보를 보게 되어야 한다.
- Availability(가용성)
- 분산 시스템에 접속하는 클라이언트는 일부 노드에 장애가 발생하더라도 응답을 받을 수 있어야한다.
- Partition tolerance(파티션 감내)
- 파트션은 두 노드 사이에 통신 장애가 발생하였음을 의미한다.
- 파티션 감내는 네트워크에 파티션이 생기도라도 시스템은 계속 동작하여 한다.
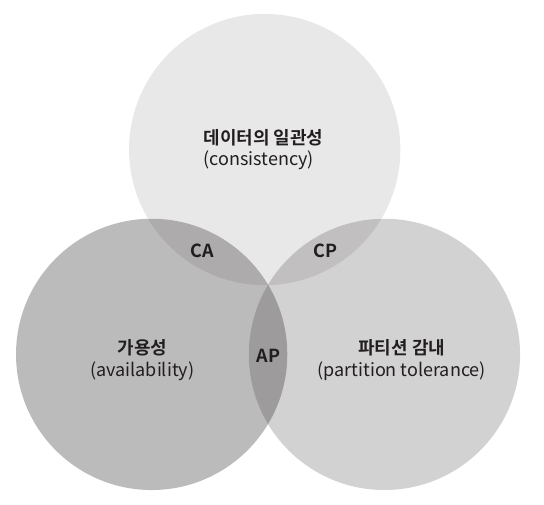
- 이들 가운데 어떤 두 가지를 만족하면 하나는 희생되어야 한다.
- 그리고 어느 두 가지를 만족한 시스템을 다음과 같이 분류한다.
- CP 시스템
- AP 시스템
- CA 시스템
- 분산시스템은 반드시 파티션 문제를 감내할 수 있도록 설계해야하기 때문에 실세계에서 CA시스템은 존재하지 않는다.
4.1.1. 이상적 상태#
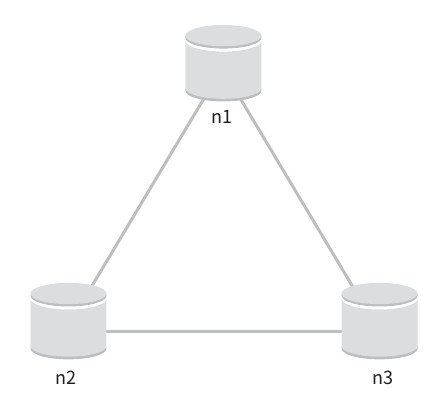
- 이상적 환경에서는 네트워크가 파티션 되는 상황은 절대로 일어나지 않는다.
4.1.2. 실세계의 분산 시스템#
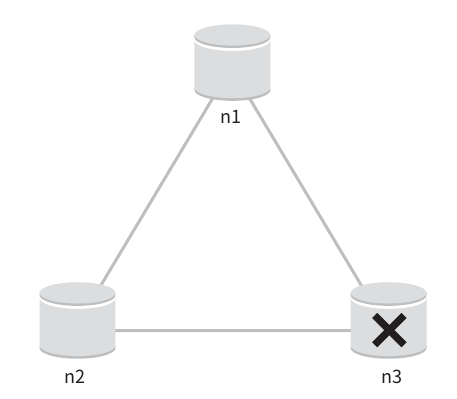
- 분산 시스템은 파티션 문제를 피할 수 없으며 우리는 일관성과 가용성 사이에 하나를 선택해야 한다.
- n3에서 장애 발생시 n3에서 기록된 데이터가 n1, n2로 전달되지 않았다면 일관성이 깨지게된다.
- 일관성을 선택하면 n1, n2의 쓰기 연산을 중단시켜야 한다.
- 이 경우 당연히 가용성이 떨어진다.
- 가용성을 선택하면 낡은데이터를 반환할 위험이 있어도 쓰기 연산을 허용해야 한다.
4.2. 시스템 컴포넌트#
- 키-값 저장소 구현에 사용될 핵심 컴포넌트들 및 기술들을 살표본다.
- 데이터 파티션
- 데이터 다중화
- 일관성
- 일관성 불일치 해소
- 장애 처리
- 시스템 아케텍처 다이어그램
- 쓰기 경로
- 읽기 경로
4.2.1. 데이터 파티션#
- 대규모 어플리케이션에서 전체 데이터를 한 대 서버에 욱여넣는 것은 불가능하다.
- 가장 단순한 해결책은 데이터를 작은 파티션들로 분할한 다음 여러 대의 서버에 저장하는 것이다.
- 데이터를 파티션 단위로 나눌 때는 다음 두 가지 문제를 중요하게 살펴보아야 한다.
- 데이터를 여러 서버에 고르게 분산할 수 있는가
- 노드가 추가되거나 삭제될 때 데이터의 이동을 최소화 할 수 있는가
- 이전에 배운 안정 해시는 이런 문제를 푸는 데 적합한 기술이다.
- 안정 해시를 사용하여 데이터 파티션하면 얻을 수 있는 이점
- 규모 확장 자동화
- 시스템 부하에 따라 서버가 자동으로 추가되거나 삭제될 수 있다.
- 다양성
- 각 서버의 용량에 맞게 가상 노드의 수를 조정할 수 있다.
- 다시 말해, 고성능 서버는 더 많은 가상 노드를 갖도록 설정할 수 있다.
4.2.2. 데이터 다중화#
- 높은 가용성과 안정성을 확보하기 위해서는 데이터를 N개 서버에 비동기적으로 다중화할 필요가 있다.
- N개의 서버를 선정하는 방법
- N개 서버를 선정하는 방법은 어떤 키를 해시 링 위에 배치
- 그 지점으로부터 시계 방향으로 링을 순회
- 만나는 첫 N개 서버에 데이터 사본을 보관하는 것이다.
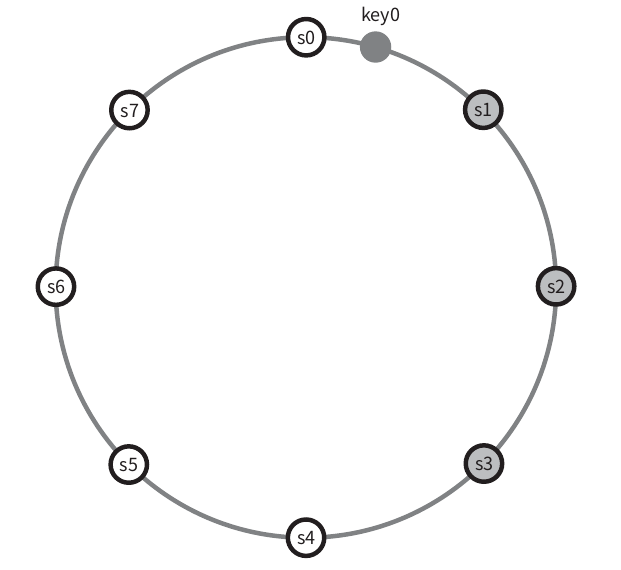
- 가상 노드를 사용하면 선택한 N개의 노드가 대응될 실제 물리서버 개수가 N보다 작아질 수 있다.
- 이 문제를 피하기 위해서는 노드를 선택할 때 같은 물리서버를 중복으로 선택하지 않도록 해야 한다.
4.2.3. 데이터 일관성#
- 여러 노드에 다중화된 데이터는 적절히 동기화 되어야 한다.
- 정족수 합의 프로토콜을 사용하면 읽기/쓰기 연산 모두에 일관성을 보장할 수 있다.
- N=사본 개수
- W=쓰기 연산에 대한 정족수. 쓰기 연산이 성공한 것으로 간주되려면 적어도 W개의 서버로부터 쓰기 연산이 성공했다는 응답을 받아야 한다.
- R=읽기 연산에 대한 정족수. 읽기 연산이 성공한 것으로 간주되려면 적어도 R개의 서버로부터 응답을 받아야 한다.
- W, R, N의 값을 정하는 것은 응답 지연과 데이터 일관성 사이의 타협점을찾는 전형적인 과정이다.
- R=1, W=N : 빠른 읽기 연산에 최적화된 시스템
- W=1, R=N : 빠른 쓰기 연산에 최적화된 시스템
- W+R>N : 강한 일관성 보장
- W+R<=N : 강한 일관성의 보장이 없다.
일관성 모델
- 일관성 모델은 키-값 저장소를 설계할 때 고려해야할 중요한 요소다.
- 일관성 수준의 종류
- 강한 일관성
- 모든 읽기 연산은 가장 최근에 갱신된 결과를 반환한다.다시 말해서 클라이언트는 절대로 낡은 데이터를 보지 못한다.
- 약한 일관성
- 읽기 연산은 가장 최근에 갱신된 결과를 반환하지 못할 수 있다.
- 최종 일관성
- 약한 일관성의 한 형태로, 갱신 결과가 결국에는 모든 사본에 반영(==동기화) 되는 모델이다.
- 강한 일관성을 달성하는 일반적인 방법은, 모든 사번에 현재 쓰기 연산의 결과가 반영될 때 까지 해당 데이터에 대한 읽기/쓰기를 금지하는 것
- 새로운 요청 처리가 중단되기 때문에 고가용성 시스템에 적절하지 않다.
- 최종 일관성 모델을 따를 경우 쓰기 연산이 병렬적으로 발생하면 시스템에 저장된 값의 일관성이 깨어질 수 있는데, 이 문제는 클라이언트가 해결해야 한다.
비 일관성 해소 기법 : 데이터 버저닝
- 데이터를 다중화하면 가용성은 높아지지만 사본 간 일관성이 깨질 가능성이 높아진다.
- 버저닝과 벡터 시계는 그 문제를 해소하기 위해 등장한 기술이다.
- 버저닝은 데이터를 변경할 때마다 해당 데이터의 새로운 버전을 만드는 것을 의미한다.
- 따라서 각 버전의 데이터는 변경 불가능하다.
- 두 클라이언트가 동시에 같은 키값으로 사본 저장소에 작업을 한다면 두 가지 버전으로 충돌이 일어난다.
- 이런 충동 문제를 해결하기 위한 방법으로 벡터 시계를 이용한다.
- 벡터 시계? = [서버, 버전]의 순서쌍을 데이터에 매단 것
- 어떤 버전이 선행인지, 어떤 버전과 충돌이 있는지 판별하는데 사용
- 벡터 시계의 표현법
- Data ( [서버1, 버전1], [서버2, 버전2], ... [서버n, 버전n] )
- 만약, 데이터를 서버1에 등록 한다면, 다음 작업 중 하나를 수행한다.
- [서버1, 버전1]가 있으면 버전1을 하나 증가시킨다.
- 없다면, 새 항목 [서버1, 버전1]을 생성한다.
- 벡터 시계의 시나리오
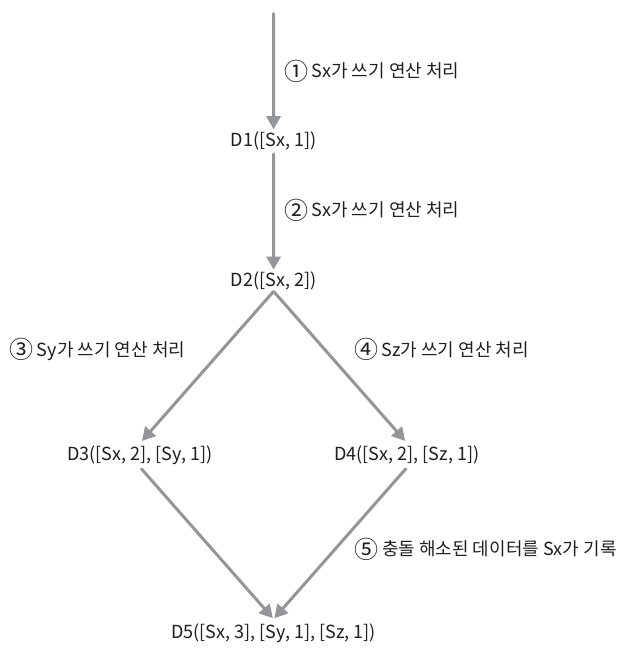
- 두 클라이언트가 동시에 다른 사본 서버에 쓰기를 수행하면 두 개의 버전이 만들어짐
- 클라이언트가 D3, D4를 읽을 때 충돌을 감지하여 충돌 해소 후 새롭게 기록한다.
- 벡터 시계의 단점
- 충돌 감지 및 해소로직이 클라이언트가 수행해야 한다.
- [서버: 버전] 순서쌍의 개수가 굉장히 빠르게 늘어난다.
장애 감지
- 분산 시스템에서는 그냥 서버 한대가 죽었다고 해당 서버를 장애처리 하지 않는다.
- 보통 두 대 이상의 서버가 똑같이 서버 A의 장애를 보고해야 실제로 해당 서버에 장애가 발생했다고 간주한다.
- 모든 노드 사이에 멀티캐스팅 채널을 구축하는 것이 서버 장애를 감지하는 가장 손쉬운 방법이다.
- 다만, 서버가 많으면 비효율적이다.
- 가십 프로토콜
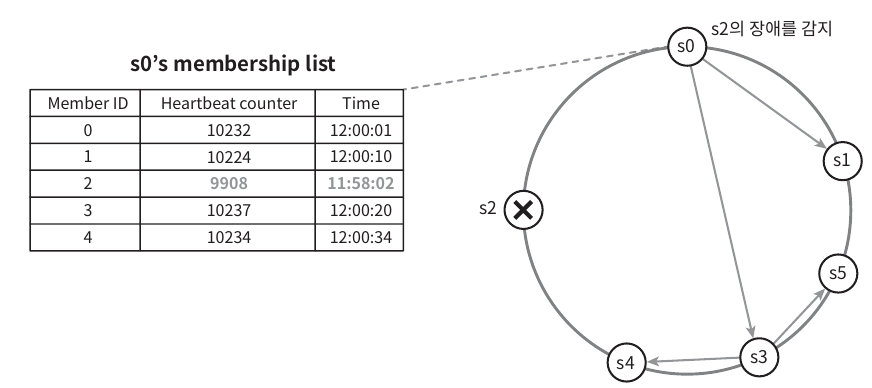
- 분산형 장애감지 솔루션
- 각 노드는 멤버십 목록을 유지한다.
- 멤버십 목록은 각 멤버 ID와 그 박동 카운터 쌍의 목록이다.
- 각 노드는 주기적으로 자신의 박동 카운터를 증가시킨다.
- 각 노드는 무작위로 선정된 노드들에게 주기적으로 자기 박동 카운터 목록을 보낸다.
- 박동 카운터 목록을 받은 노드는 멤버십 목록을 최신 값으로 갱신한다.
- 어떤 멤버의 박동 카운터 값이 지정된 시간 동안 갱신되지 않으면 해당 멤버는 장애 상태인 것으로 간주한다.
장애 처리
일시적 장애 처리#
- 엄격한 정족수 접근법을 쓴다면 읽기와 쓰기를 금지해야한다.
- 느슨한 정족수를 쓴다면 건강한 서버와 읽기 연산을 수행할 R개의 건강한 서버를 해시링에서 고른다.
- 즉, 다른서버가 일시적으로 맡아서 요청을 처리한다.
- 이때 처리에 대한 힌트를 남겨둔다.
- 서버가 다시 복구된다면 다시 일괄 반영한다.
- 이런 방법을 단서 후 임시 위탁이라 부른다.
영구 장애 처리#
- 영구적 노드 손상에 대처하는 방법 = 머클트리를 사용
- 머클트리
- 각 노드에 그 자식 노드들에 보관된 값의 해시, 자식 노드들의 레이블로부터 계산된 해시 값을 레이블로 붙여두는 트리
- 키 공간이 1부터 12까지 구성될 경우,
- 키 공간을 버킷으로 나눈다.
- 버킷에 포함된 각각의 키에 균등 분포 해시 함수를 이용하여 해시 값을 계산한다.
- 버킷별로 해시값을 계산한다. 해당 해시 값을 레이블로 갖는 노드를 생성한다.
- 자식 노드의 레이블로부터 새로운 해시 값을 계산하여 이진 트리를 상향식으로 만들어 나간다.