9장 - 웹 크롤러 설계
- 생성일
- 2024년 7월 14일 PM 10:29
1. 문제 이해 및 설계 범위 확정#
- 웹 크롤러의 기본 알고리즘은 간단하다.
- URL 집합이 입력으로 주어지면 해당 URL들이 가리키는 모든 웹 페이지를 다운로드한다.
- 다운받은 웹 페이지에서 URL들을 추출한다.
- 추출된 URL들을 다운로드할 URL 목록에 추가하고 위의 과정을 처음부터 반복한다.
- 규모 확장성
- 웹은 거대하고 웹에는 수십억 개의 페이지가 존재한다.
- 따라서 병행성(parallelism)을 활용하면 보다 효과적으로 웹 크롤링을 할 수 있다.
- 안정성(robustness)
- 웹은 함정으로 가득하다.
- 잘못 작성된 HTML, 아무 반응이 없는 서버, 장애, 악성 코드가 붙어 있는 링크 등이 그 좋은 예다.
- 크롤러는 이런 비정상적 입력이나 환경에 잘 대응할 수 있어야 한다.
- 예절(Politeness)
- 크롤러는 수집 대상 웹 사이트에 짧은 시간 동안 너무 많은 요청을 보내서는 안된다.
- 확장성
- 새로운 형태의 콘텐츠를 지원하기가 쉬워야 한다.
- 예를 들어, 이미지 파일도 크롤링하고 싶을 때 이를 위해 전체 시스템을 새로 설계해야 한다면 곤란할 것이다.
1.1. 개략적 규모 추정#
- 매달 10억 개의 웹 페이지를 다운로드 한다.
- QPS = 10억 / 30일 / 24시간 / 3600초 = 대략 400 page / sec
- 최대 (Peak) QPS = 2 X QPS = 800 page/sec
- 웹 페이지의 평균 크기는 500k라고 가정
- 10억 페이지 x 500k = 500 TB /month.
- 1개월치 데이터를 보관하는 데는 500 TB, 5년간 보관한다고 가정하면 결국 500TB X 12개월 X 5년 = 30PB의 저장용량이 필요하다.
2. 개략적 설계안 제시 및 동의 구하기#
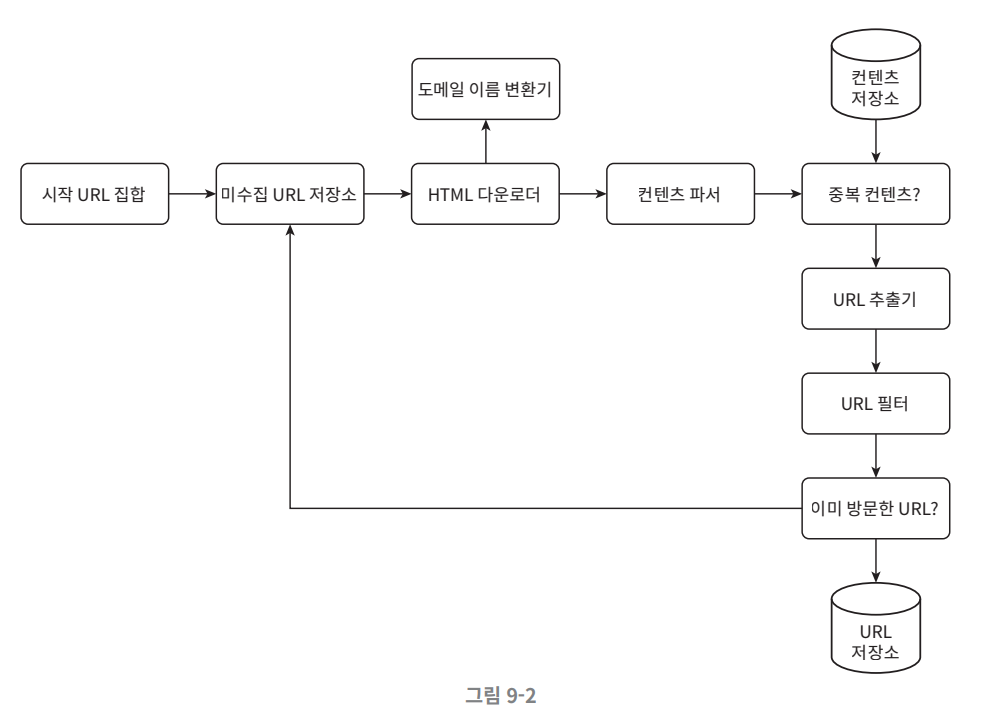
2.1. 시작 URL 집합#
- 시작 URL 집합은 웹 크롤러가 크롤링을 시작하는 첫 출발점이다.
- 전체 웹을 크롤링해야 하는 경우 시작 URL을 고를 때 좀 더 창의적일 필요가 있다.
- 크롤러가 가능한 많은 링크를 탐색할 수 있도록 하는 URL을 고르는 것이 바람직하다.
- 일반적으로는 전체 URL 공간을 작은 부분집합으로 나누는 전략을 쓴다.
- 또 다른 방법은 주제별로 다른 시작 URL을 사용하는 것이다.
2.2. 미수집 URL 저장소#
- 대부분의 현대적 웹 크롤러는 크롤링 상태를 다운로드 할 URL, 다운로드된 URL 두 가지로 나눠 관리한다.
- 이 중 다운로드 할 URL을 저장 관리하는 컴포넌트를 미수집 URL 저장소라 부른다.
- 이는 FIFO 큐라고 생각하면 된다.
2.3. HTML 다운로더#
- HTML 다운로더는 인터넷에서 웹 페이지를 다운로드하는 컴포넌트다.
- 다운로드할 페이지의 URL은 미수집 URL 저장소가 제공한다.
2.4. 도메인 이름 변환기#
- 웹 페이지를 다운받으려면 URL을 IP 주소로 변환하는 절차가 필요하다. HTML 다운로더는 도메인 이름 변환기를 사용하여 URL에 대응되는 IP 주소를 알아낸다.
2.5. 콘텐츠 파서#
- 웹 페이지를 다운로드하면 파싱과 검증 절차를 거쳐야한다. 이상한 웹 페이지는 문제를 일으킬 수 있는데다 저장 공간만 낭비하게 도기ㅣ 때문이다. 크롤링 서버 안에 콘텐츠 파서를 구현하면 크롤링 과정이 느려지게 될 수 있으므로 독립된 컴포넌트로 구성함.
2.6. 콘텐츠 저장소#
- 콘텐츠 저장소는 HTML 문서를 보관하는 시스템이다. 저장소를 구현하는 데 쓰일 기술을 고를 때는 저장할 데이터의 유형, 크기, 저장소 접근 빈도, 데이터의 유효 기간 등을 종합적으로 고려해야 한다.
- 데이터 양이 너무 많으므로 대부분의 콘텐츠는 디스크에 저장한다.
- 인기 있는 콘텐츠는 메모리에 두어 접근 지연시간을 줄일 것이다.
2.7. URL 추출기#
URL 추출기는 HTML 페이지를 파싱하여 링크들을 골라내는 역할을 한다.
2.8. URL 필터#
- URL 필터는 특정한 콘텐츠 타입이나 파일 확장자를 갖는 URL, 접속 시 오류가 발생하는 URL, 접근 제외 목록에 포함된 URL 등을 크롤링 대상에서 배제하는 역할을 한다.
2.9. URL 저장소#
- URL 저장소는 이미 방문한 URL을 보관하는 저장소다.
2.10. 웹 크롤러 작업 흐름#
- 시작 URL들을 미수집 URL 저장소에 저장한다.
- HTML 다운로더는 미수집 URL 저장소에서 URL 목록을 가져온다.
- HTML 다운로더는 도메인 이름 변환기를 사용하여 URL의 IP 주소를 알아내고, 해당 IP 주소로 접속하여 웹 페이지를 다운받는다.
- 콘텐츠 파서는 다운된 HTML 페이지를 파싱하여 올바른 형식을 갖춘 페이지인지 검증한다.
- 콘텐츠 파싱과 검증이 끝나면 중복 콘텐츠인지 확인한느 절차를 개시한다.
- 중복 콘텐츠인지 확인하기 위해서, 해당 페이지가 이미 저장소에 있는지 본다.
- 이미 저장소에 있는 콘텐츠인 경우에는 처리하지 않고 버린다.
- 저장소에 없는 콘텐츠인 경우에는 저장소에 저장한 뒤 URL 추출기로 전달한다.
- URL 추출기는 해당 HTML 페이지에서 링크를 골라낸다.
- 골라낸 링크를 URL 필터로 전달한다.
- 필터링이 끝나고 남은 URL만 중복 URL 판별 단계로 전달한다.
- 이미 처리한 URL인지 확인하기 위하여, URL 저장소에 보관된 URL인지 살핀다. 이미 저장소에 있는 URL은 버린다.
- 저장소에 없는 URL은 URL 저장소에 저장할 뿐 아니라 미수집 URL 저장소에도 전달한다.
3. 상세 설계#
3.1. DFS를 쓸 것인가, BFS를 쓸 것인가?#
- 웹은 유향 그래프(directed graph)와 같다.
- 페이지는 노드이고, 하이퍼링크는 에지라고 보면 된다.
- 크롤링 프로세스는 이 유향 그래프를 에지를 따라 탐색하는 과정이다.
- 일반적으로 웹 크롤러는 BFS를 사용한다.
- DFS의 경우 그래프 깊이가 얼마나 깊어질지 가늠이 어렵기 때문
- 이 구현법의 두 가지 문제점
- 한 페이지에서 나오는 링크의 상당수는 같은 서버로 되돌아간다.
- 호스트 링크를 병렬로 처리 시, 과부하에 걸릴 수 있다.
- 표준적 BFS 알고리즘은 URL 간에 우선순위를 두지 않는다.
- 모든 페이지는 동일한 품질과 중요성을 가지지 않기 때문에 여러 척도에 비추어 우선순위를 구별하는것이 바람직하다.
3.2. 미수집 URL 저장소#
- 미수집 URL 저장소를 활용하면 이런 문제를 좀 쉽게 해결할 수 있다.
- URL 저장소는 다운로드할 URL을 보관하는 장소다.
- 이 저장소를 잘 구현하면 크롤러의 여러 문제점을 해결 할 수 있다.
3.3. 예의#
- 웹 크롤러는 수집 대상 서버로 짧은 시간 안에 너무 많은 요청을 보내는 것을 삼가야 한다.
- 예의 바른 크롤러를 만드는 데 있어서 지켜야 할 한 가지 원칙
- 동일 웹 사이트에 대해서는 한 번에 한 페이지만 요청한다
- 이 요구사항을 만족시키려면 웹 사이트의 호스트명과 다운로드를 수행하는 작업 스레드 사이의 관계를 유지하면 된다.
- 각 다운로드 스레드는 별도의 FIFO 큐를 가지고 있어서 해당 큐에서 꺼낸 URL만 다운로드한다.
- 해당 아이디어의 설계
- 호스트와 - 큐는 하나의 키-밸류 테이블로 묶여있다.
- 큐 라우터
- 같은 호스트에 속한 URL은 언제나 같은 큐로 가도록 보장하는 역할을 한다.
- 매핑 테이블
- 호스트 이름과 큐 사이의 관계를 보관하는 테이블
- FIFO 큐
- 같은 호스트에 속한 URl은 언제나 같은 큐에 보관된다.
- 큐 선택기
- 큐 선택기는 큐들을 순회하면서 큐에서 URl을 꺼내서 해당 큐에서 나온 URL을 다운로드하도록 지정된 작업 스레드에 전달하는 역할을 한다.
- 작업 스레드
- 작업 스레드는 전달된 URL을 다운로드하는 작업을 수행한다.
- 전달된 URL은 순차적으로 처리될 것이며, 작업들 사이에는 일정한 지연시간을 둘 수 있다.
3.4. 우선순위#
- 유용성에 따라 URL의 우선순위를 나눌 때는 페이지랭크, 트래픽 양, 갱신 빈도 등 다양한 척도를 사용할 수 있다.
- 순위결정장치는 URL 우선순위를 정하는 컴포너트다.
- 순위결정장치
- URL을 입력으로 받아 우선순위를 계산한다.
- 큐
- 우선순위별로 큐가 하나씩 할당된다.
- 우선순위가 높으면 큐에서 더 자주 꺼내도록 프로그램되어 있다.
- 큐 선택기
- 임의 큐에서 처리할 URL을 꺼내는 역할을 담당한다.
- 이런 우선순위를 정해주는 큐를 전면에 두고, 앞서 설명한 예의단의 큐를 후면에 두면 우선순위를 가지고 수집하는 크롤러를 만들 수 있다.
3.5. 신선도#
- 데이터의 신선함을 유지하기 위해서 이미 다운로드한 페이지라고 해도 주기적으로 재수집할 필요가 있다.
- 그러나 모든 URL을 재수집하는 것은 많은 시간과 자원이 필요한 작업이다.
- 따라서 이를 최적화하기 위해 다음과 같은 방법이 있다.
- 웹 페이지의 변경 이력 활용
- 우선순위를 활용하여, 중요한 페이지는 좀 더 자주 재수집
3.6. HTML 다운로더#
3.6.1. Robots.txt (로봇 제외 프로토콜)#
- 웹 사이트가 크롤러와 소통하는 표준 방법이다.
- 이 파일에는 크롤러가 수집해도 되는 페이지 목록이 들어 있다.
- 웹 사이트를 긁어 가기 전에 크롤러는 해당 파일에 나열된 규칙을 먼저 확인해야 한다.
Robots.txt파일을 거푸 다운로드하는 것을 피하기 위해 이 파일을 주기적으로 다시 다운받아 캐시에 보관할 것이다.
3.6.2. 성능최적화#
- 분산 크롤링성능을 높이기 위해 크롤링 작업을 여러 서버에 분산하는 방법이다.
- 각 서버는 여러 스레드를 돌려 다운로드 작업을 처리한다.
- 도메인 이름 변환 결과 캐시도메인 이름 변환기는 크롤러 성능의 병목 중 하나다.
- 이는 DNS 요청을 보내고 결과를 받는 작업의 동기적 특성 때문이다.
- 크롤러 스레드 가운데 어느 하나라도 이 작업을 하고 있으면 다른 스레드의 DNS 요청은 전부 블록된다.
- DNS 조회 결과로 얻어진 도메인 이름과 IP 주소 사이에 관계를 캐시에 보관해 놓고 크론 잡 등을 돌려 주기적으로 갱신하도록 해 놓으면 성능을 높일 수 있다.
- 지역성크롤링 작업을 수행하는 서버를 지역별로 분산하는 방법
- 크롤링 대상 서버와 지역적으로 가까우면 페이지 다운로드 시간이 줄어든다.
- 짧은 타임아웃어떤 웹 서버는 응답이 느리거나 아예 응답하지 않는다.
- 대기 시간이 길어지면 좋지 않으므로, 최대 얼마나 기다릴지를 미리 정해 두자
- 이 시간 동안 서버가 응답하지 않으면 크롤러는 해당 페이지 다운로드를 중지하고 다음 페이지로 넘어간다.
3.6.3. 안정성#
- 안정 해시(consistent hashing)
- 다운로더 서버들에 부하를 분산할 때 적용 가능한 기술이다.
- 이 기술을 이용하면 다운로더 서버를 쉽게 추가하고 삭제할 수 있다.
- 크롤링 상태 및 수집 데이터
- 장애가 발생할 경우에도 쉽게 복구할 수 있도록 크롤링 상태와 수집된 데이터를 지속적 저장장치에 기록해 두는 것이 바람직하다.
- 예외 처리
- 대규모 시스템에서 에러는 불가피할 뿐 아니라 흔하게 벌어지는 일이다. 예외가 발생해도 전체 시스템이 중단되는 일 없이 그 작업을 우아하게 이어나갈 수 있어야 한다.
- 데이터 검증
- 시스템 오류를 방지하기 위한 중요 수단 가운데 하나이다.